
Redis 与缓存 / 系统课时
建立持久化与恢复运行手册
建立持久化与恢复运行手册
本节把 Redis 持久化恢复从个人经验整理成可执行的生产运行手册:明确平时监控什么、备份如何验真、故障如何分级、恢复按什么顺序执行,以及什么条件下才允许恢复业务流量,使值班人员面对故障时能够按同一套基线决策。
学习目标
- 将持久化监控、备份检查、故障分级和恢复动作整理成固定运行流程
- 为恢复过程定义可验证的门禁,而不是以“Redis 已启动”作为成功标准
- 设计定期演练机制,让手册、备份和真实恢复能力持续保持一致
把日常观测写成固定检查项
运行手册首先要解决“故障前有没有信号”。持久化相关检查不应只看磁盘是否存在 RDB 或 AOF 文件,还要同时观察最近保存状态、AOF 重写状态、加载状态、文件增长和磁盘剩余空间。
可以把下面的命令作为值班基线的一部分:
redis-cli -p <PORT> INFO persistence
redis-cli -p <PORT> CONFIG GET dir
redis-cli -p <PORT> CONFIG GET appendonly
redis-cli -p <PORT> CONFIG GET appenddirname
redis-cli -p <PORT> LASTSAVE
预期输出
# Persistence
<实际持久化状态字段>
1) "dir"
2) "<PATH>"
1) "appendonly"
2) "yes或no"
1) "appenddirname"
2) "<VALUE>"
<TIME>
不同 Redis 版本和配置会出现不同的 INFO persistence 字段,因此手册应记录“需要判断的状态”而不是硬编码一整段输出。例如最近一次后台保存是否成功、AOF 是否正在重写、实例是否仍处于加载阶段,以及持久化错误是否持续出现。
让备份检查覆盖可恢复性
“备份任务成功”不等于“能够恢复”。生产基线至少要同时记录备份生成时间、文件大小、校验值、保留位置和恢复验证结果。对于多文件 AOF,备份必须覆盖 manifest 及其引用的全部文件,不能只复制某个最新增量文件。
一个最低限度的文件检查可以包含存在性、大小和摘要:
ls -lh <PATH>/<BACKUP_FILE>
sha256sum <PATH>/<BACKUP_FILE>
预期输出
-rw------- 1 <VALUE> <VALUE> <VALUE> <TIME> <PATH>/<BACKUP_FILE>
<VALUE>  <PATH>/<BACKUP_FILE>
这里的摘要只证明文件在传输后是否发生变化,不能证明 Redis 能加载它。运行手册还应规定周期性把备份恢复到隔离环境,执行启动、关键键查询和业务抽样,只有成功完成恢复验证的备份才能标记为“可恢复”。
用故障等级决定恢复路径
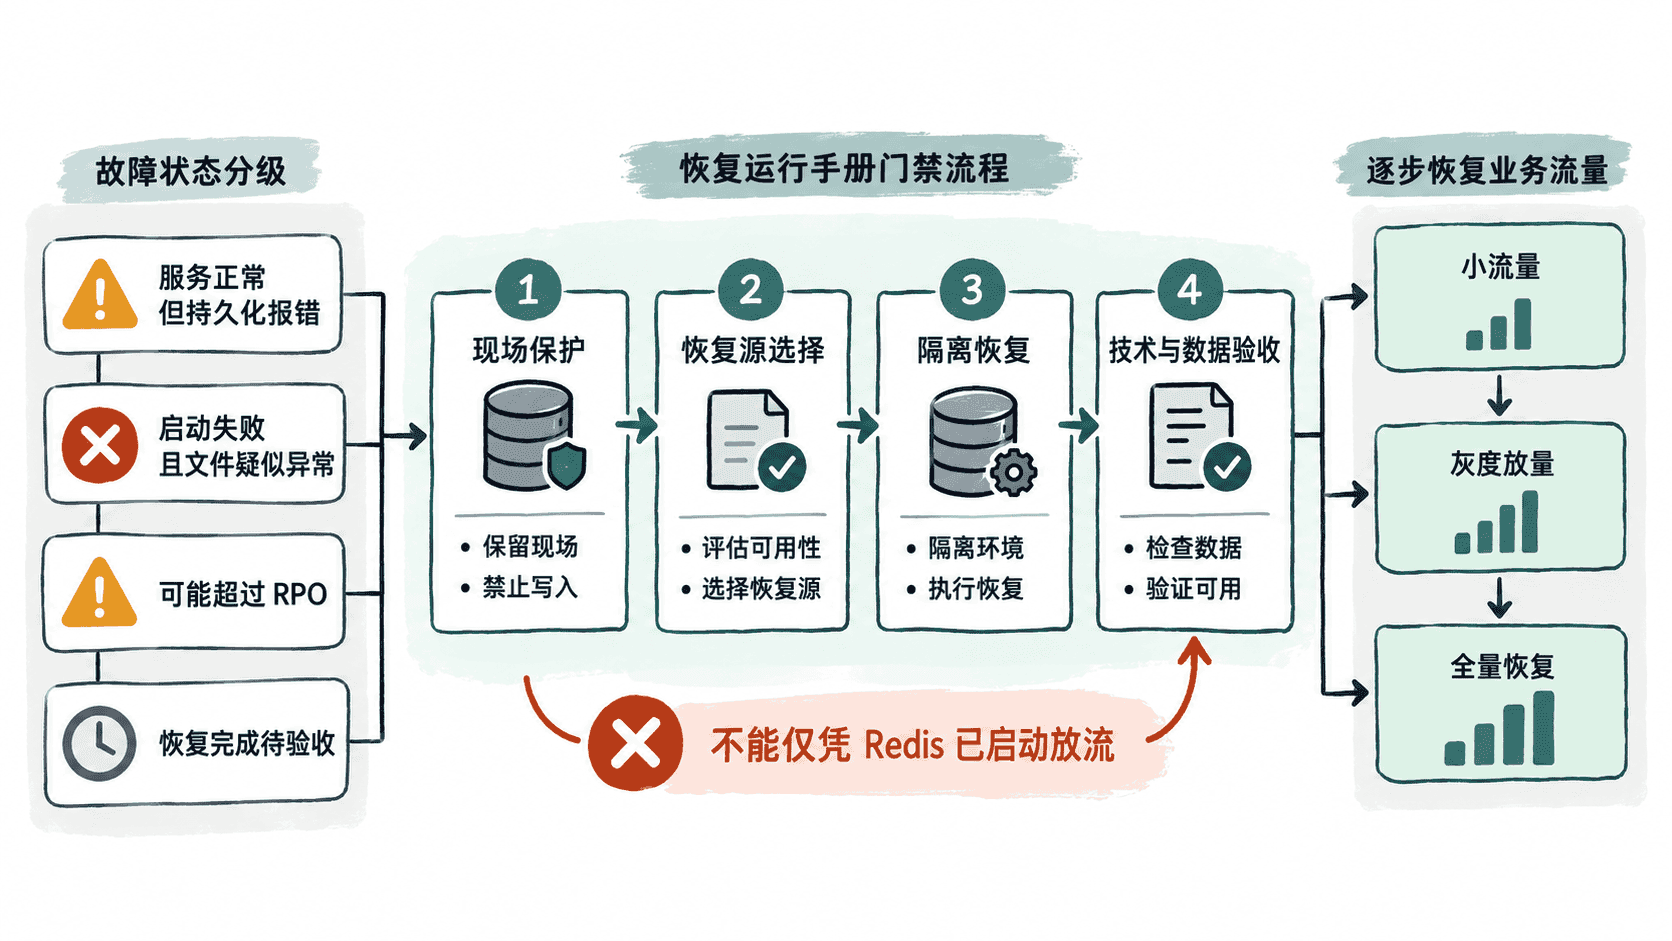
故障分级的价值在于减少临场争论。可以按影响和数据风险划分处理方式:实例仍可服务但持久化失败时,优先保护当前内存数据并修复磁盘或配置;实例不可启动但持久化文件完整时,优先基于原文件副本分析;文件损坏且可能超过 RPO 时,应立即升级并评估备份或上游重建方案。
| 状态 | 首要动作 | 禁止动作 |
|---|---|---|
| 服务正常,持久化报错 | 保护当前数据并定位写盘失败 | 直接重启丢失内存现场 |
| 启动失败,文件疑似异常 | 复制完整现场后离线检查 | 在唯一原件上直接修复 |
| 修复可能丢失超出 RPO | 切换到备份或重建评估 | 为追求启动继续扩大截断 |
| 恢复完成但数据未验收 | 保持流量隔离并继续校验 | 仅凭 PING 成功开放业务 |
把恢复步骤写成有门禁的操作链
手册中的恢复流程应描述“达到什么条件才能进入下一步”,而不是只列命令。一个可执行的基线顺序是:
- 确认影响范围、当前 RPO 与 RTO,并冻结会继续改变故障现场的操作。
- 保存日志、配置、持久化目录和必要的系统信息,对原始文件建立只读副本。
- 判断使用当前 RDB/AOF、最近可信备份还是上游数据重建。
- 在隔离实例完成恢复,不直接把未经验证的数据源加载到生产流量入口。
- 通过技术、数据和业务三层验收后,再逐步恢复客户端访问。
- 保存实际恢复时间点、丢失窗口和全部操作记录,进入复盘。
技术验收可以用一组最小命令确认实例状态:
redis-cli -p <PORT> PING
redis-cli -p <PORT> INFO persistence
redis-cli -p <PORT> DBSIZE
预期输出
PONG
# Persistence
<实际持久化状态字段>
<实际键数量>
PING 只说明进程能够响应;INFO persistence 用于确认加载和持久化状态;DBSIZE 只能做数量级核对。之后还必须执行关键键、抽样记录、业务计数或上下游对账,数据门禁通过后才能进入业务验收。
固定演练周期并维护手册
运行手册只有被真实执行过才有价值。演练应覆盖至少三类场景:RDB 恢复、AOF 异常恢复,以及持久化文件不可用时从备份或上游重建。每次演练记录实际 RTO、实际数据损失窗口、失败步骤和需要人工判断的位置。
演练后应同步更新命令参数、文件路径、责任人角色、监控入口、备份位置和验收查询。生产版本、Redis 配置或存储架构发生变化时,也要触发手册复核,避免故障时才发现路径、文件格式或恢复方式已经改变。
最终的运行基线应形成一个闭环:平时用监控尽早发现持久化风险,用恢复验证证明备份可用;故障时按分级、现场保护、恢复和多层验收执行;恢复后再用演练结果更新手册。这样衡量的不是“有没有备份文件”,而是团队是否持续拥有可验证、可重复的恢复能力。