
Redis 与缓存 / 系统课时
用 RPO 与 RTO 定义恢复目标
用 RPO 与 RTO 定义恢复目标
Redis 持久化方案不能只回答“会不会丢数据”,还要明确业务最多能丢多少数据、故障后多久必须恢复。把这两个问题量化为 RPO 与 RTO,才能进一步确定保护方案、恢复流程与演练标准。
学习目标
- 区分 RPO 与 RTO 分别约束的数据丢失量和恢复时长
- 把业务语言转换成可测量、可验收的 Redis 恢复目标
- 根据目标反推持久化、备份与恢复验证要求
RPO 约束可以丢多少数据
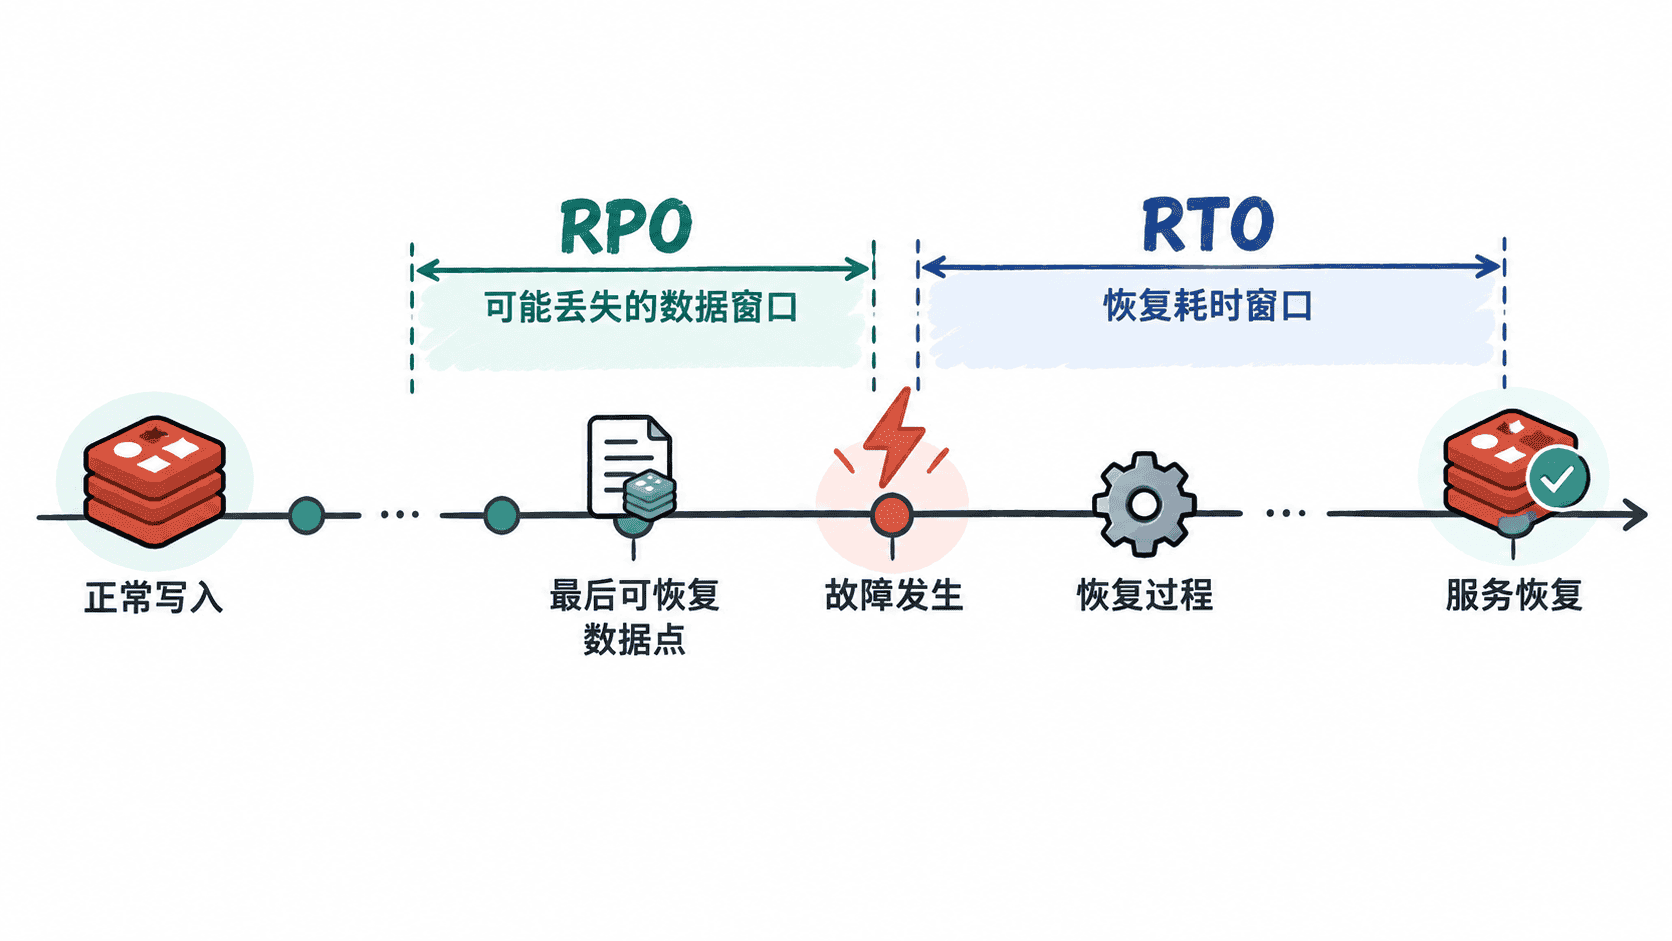
RPO,Recovery Point Objective,表示发生故障后允许恢复到多早以前的数据状态。它关注的是时间窗口内可能丢失的数据量,不是 Redis 多久能重新启动。
例如业务定义 RPO 为 5 分钟,含义是发生存储损坏、误删除等需要从持久化数据恢复的故障时,最多接受最近约 5 分钟的数据无法恢复。若每分钟写入 2000 条关键记录,最坏情况下需要评估的业务损失约为 10000 条记录,而不能只写一句“允许少量丢失”。
RTO 约束多久恢复服务
RTO,Recovery Time Objective,表示故障发生后,业务从不可用状态恢复到约定服务能力所允许的最长时间。它覆盖的通常不只是 Redis 进程启动时间,还包括故障确认、实例准备、持久化文件检查、数据加载、业务校验和流量恢复。
假设目标是 RTO 15 分钟,可以拆成一份可执行预算:故障确认 2 分钟、准备可恢复实例 3 分钟、加载数据 5 分钟、数据与业务验证 3 分钟、恢复流量 2 分钟。任何一步经常超过预算,都说明当前方案虽然“能恢复”,但还没有满足恢复目标。
从业务语言转换成恢复指标
业务方常给出的要求并不是标准指标,例如“订单不能丢”“缓存坏了可以重建”“故障尽快恢复”。技术方案需要继续追问数据价值和恢复边界,再把答案写成可验收的数值。
| 业务表述 | 可执行目标示例 | 技术含义 |
|---|---|---|
| 支付状态几乎不能丢 | RPO ≤ 1 秒 | 需要非常低的数据丢失窗口,并考虑持久化之外的数据保护 |
| 推荐结果可以重新计算 | RPO ≤ 30 分钟 | 可以接受较宽松的持久化或备份周期 |
| 核心接口很快要恢复 | RTO ≤ 10 分钟 | 必须控制数据加载、验证和切流总耗时 |
| 离线任务可以稍后恢复 | RTO ≤ 2 小时 | 可以接受更长的恢复窗口,优先平衡成本与恢复速度 |
同一个 Redis 实例如果混放了不同价值的数据,应优先按最严格目标设计,或者拆分实例。否则低价值缓存可能被迫承担昂贵的耐久性成本,高价值数据又可能被宽松策略拖累。
用目标反推保护方案
明确 RPO 和 RTO 后,再讨论 RDB、AOF、备份和恢复流程才有判断标准。RPO 主要影响“持久化数据多久落下来、多久复制或备份一次”;RTO 主要影响“恢复文件有多大、加载要多久、是否已有备用环境以及验证步骤能否自动完成”。
可以把目标写成一份最小恢复契约:关键数据 RPO 不超过 1 分钟,核心读取能力 RTO 不超过 10 分钟;每次恢复演练记录最后可恢复时间点、实际丢失窗口和完整恢复耗时。只有实际测量值持续落在目标内,才算真正达标。
恢复目标最终应成为后续持久化选型和演练的验收门槛,而不是文档里的抽象数字。