
Redis 与缓存 / 系统课时
规划 Redis Cluster 数据恢复
规划 Redis Cluster 数据恢复
Redis Cluster 把数据分散到多个主节点,每个主节点只负责一部分哈希槽,因此恢复不能把整个集群当成一个单文件数据库处理。本课建立按分片、节点和哈希槽规划备份与恢复的方法,并给出节点恢复后的核验步骤。
学习目标
- 按哈希槽和主节点识别 Redis Cluster 的数据恢复责任
- 规划节点级持久化文件、备份和重新加入集群的流程
- 在恢复后验证槽位、复制关系和关键数据是否完整
Cluster 恢复的基本单位是分片
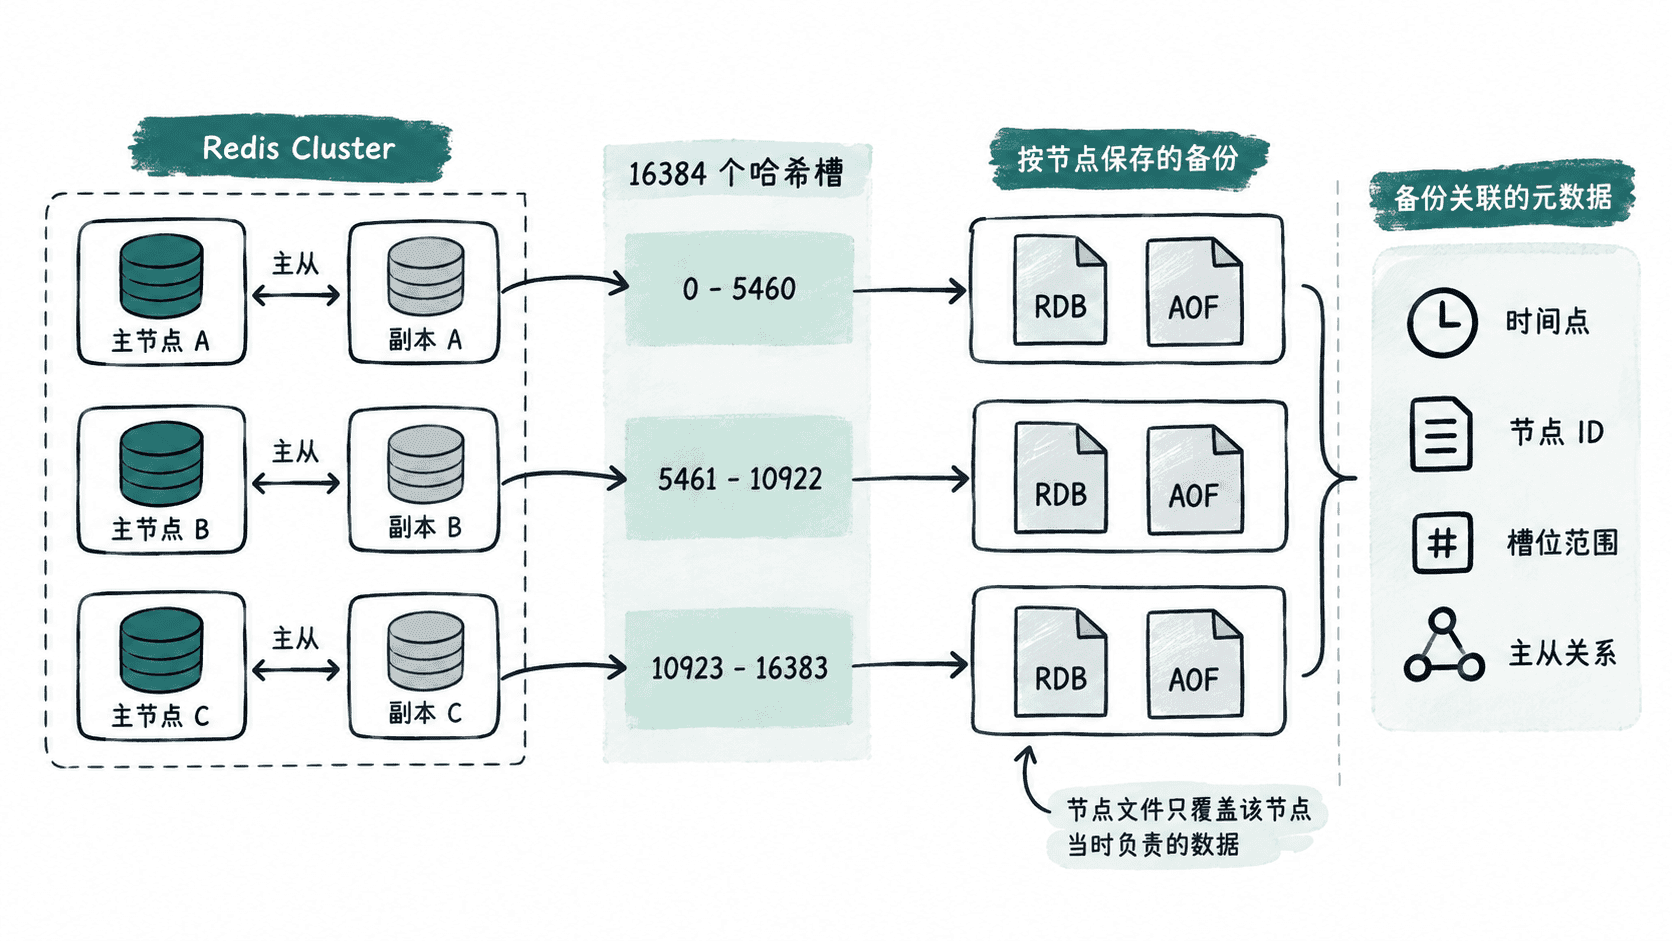
Redis Cluster 通常由多个主节点分别持有一部分哈希槽,并由各自副本提供冗余。某个节点上的 RDB 或 AOF 只包含该节点当时负责的数据,而不是整个 Cluster 的完整数据集。
因此,备份方案至少要记录三个维度:备份来自哪个节点、备份时该节点负责哪些槽位、备份对应什么时间点。只保存一份节点文件,却没有保存拓扑和槽位信息,恢复时很难判断这份数据究竟属于哪个分片。
Redis 7.0 及以上规划新的 Cluster 拓扑读取逻辑时,应优先使用 CLUSTER SHARDS。CLUSTER SLOTS 自 Redis 7.0 起已标记为 deprecated,可用于兼容旧实现,但不应作为新代码的首选。
redis-cli -p <PORT> CLUSTER SHARDS预期结果会按分片返回 slots 和 nodes 信息。下面只展示一个可核对的 RESP2 简化结构,实际返回通常还会包含节点端口、IP、角色、复制偏移量和健康状态等字段:
1) 1) "slots"
   2) 1) 1) (integer) 0
         2) (integer) 5460
2) 1) "nodes"
   2) 1) 1) 1) "id"
            2) "<ID>"
         2) 1) "endpoint"
            2) "<IP>:<PORT>"
         3) 1) "role"
            2) "master"
实际结果会包含完整分片和节点信息。备份清单应把槽位范围与节点备份关联起来。发生重新分片后,旧备份仍然对应备份时刻的旧槽位责任,不能直接按当前拓扑推断其内容。
节点级备份要和拓扑信息一起保存
生产备份不应只复制 dump.rdb 或 AOF 文件。除了每个主分片的数据文件,还应保存足够的恢复元数据,例如备份时间、节点标识、节点角色、槽位范围以及当时的主从关系。
可以使用 CLUSTER NODES 保存节点配置快照。它更适合管理员排查和记录节点状态,而面向客户端的槽位到节点映射,新实现应优先采用 CLUSTER SHARDS。
redis-cli -p <PORT> CLUSTER NODES预期结果中,每行对应一个节点,字段依次包含节点 ID、地址、flags、master ID、ping-sent、pong-recv、config-epoch、连接状态以及槽位信息:
<ID> <IP>:<PORT>@<PORT> master - <TIME> <TIME> <VALUE> connected 0-<VALUE>
<ID> <IP>:<PORT>@<PORT> slave <ID> <TIME> <TIME> <VALUE> connected
实际节点 ID、时间、端口和槽位范围都会变化。建议在生成数据备份的同一批次保存这份拓扑快照,这样恢复人员能够知道文件属于哪个分片,而不是只凭文件名猜测。
恢复单节点前先判断数据是否仍有健康副本
某个主节点故障时,第一选择通常不是立即从离线备份恢复,而是先判断它的副本是否仍然保存完整数据。如果健康副本已经被提升为新主,业务数据可能仍在线,此时重点是补充新的副本和恢复冗余,而不是把旧备份强行覆盖到当前分片。
只有当该分片没有可用副本、数据已经损坏,或者必须回到历史时间点时,才进入持久化文件恢复流程。恢复前要先停止目标 Redis 实例,把对应分片的 RDB 或 AOF 放回该实例配置的数据目录,再启动实例并核验本地数据。
例如恢复后可以先确认节点是否正常响应:
redis-cli -p <PORT> PING
redis-cli -p <PORT> DBSIZE
预期结果类似:
PONG
(integer) <VALUE>
DBSIZE 只能说明当前节点存在多少键,不能证明槽位和业务数据完整,因此它只是基础存活检查。
重新接入 Cluster 时不要混淆数据恢复与槽位恢复
把数据文件恢复到 Redis 进程,只完成了“节点本地数据重新可读”。该节点是否属于正确的 Cluster、是否承担预期槽位、是否应该成为主节点或副本,是另一层问题。
恢复节点启动后可以检查:
redis-cli -p <PORT> CLUSTER INFO健康集群的关键结果通常应包含:
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_fail:0
如果槽位未全部覆盖,或者部分槽位处于失败状态,不应仅因为 Redis 进程可以 PING 就宣布恢复完成。此时需要依据现存集群拓扑重新建立节点复制关系或槽位责任,而不是机械恢复旧拓扑。
尤其要避免把历史备份中的旧数据节点直接作为当前槽位主节点上线。备份之后如果分片已经发生写入或重新分片,这样做可能把旧数据重新暴露给客户端,造成数据回退。
用槽位和业务数据完成最终验收
Cluster 恢复后的验收应同时覆盖集群层和数据层。集群层确认所有 16384 个槽位均有正常责任节点、主从关系符合预期、没有失败槽位;数据层则检查该分片中的关键键以及跨分片业务对象。
可以用键计算其槽位,确认恢复数据落在预期分片:
redis-cli -p <PORT> CLUSTER KEYSLOT order:1001预期结果为一个 0 到 16383 之间的槽位编号:
(integer) <VALUE>随后应在能够路由 Cluster 的客户端上读取关键业务键,并与备份清单、权威数据库或业务审计记录核对。对于使用 hash tag 的多键业务,还应额外确认相关键仍被映射到设计好的同一槽位。
Redis Cluster 的恢复方案本质上不是“找到一份 RDB 然后启动 Redis”,而是同时恢复数据文件、分片身份和集群拓扑。生产备份只有能够回答“这个文件属于哪个时间点、哪个节点、哪些槽位,以及恢复后如何重新验证责任边界”,才真正具备可恢复性。