
Redis 与缓存 / 系统课时
认识 Redis 数据丢失路径
认识 Redis 数据丢失路径
本课从故障来源出发梳理 Redis 数据为什么会丢、能丢多少,以及不同故障下恢复点为何不同。读完后,你能用“内存、持久化、存储、操作”四层视角判断数据风险。
学习目标
- 识别进程退出、主机故障、磁盘异常和人为操作四类主要丢失路径
- 区分“数据尚未落盘”和“已有备份但被覆盖”这两类不同风险
- 能根据故障类型初步判断可恢复的数据范围
从 Redis 的内存状态开始看风险
Redis 对外提供的数据首先存在于内存中。只要数据尚未可靠写入持久化介质,进程或主机发生故障时,这部分数据就可能无法从当前实例恢复。
因此,“客户端已经收到写入成功”不等于“这条数据已经进入可长期恢复的介质”。数据是否能够恢复,取决于当前启用的持久化机制、刷盘时机以及是否存在独立副本。
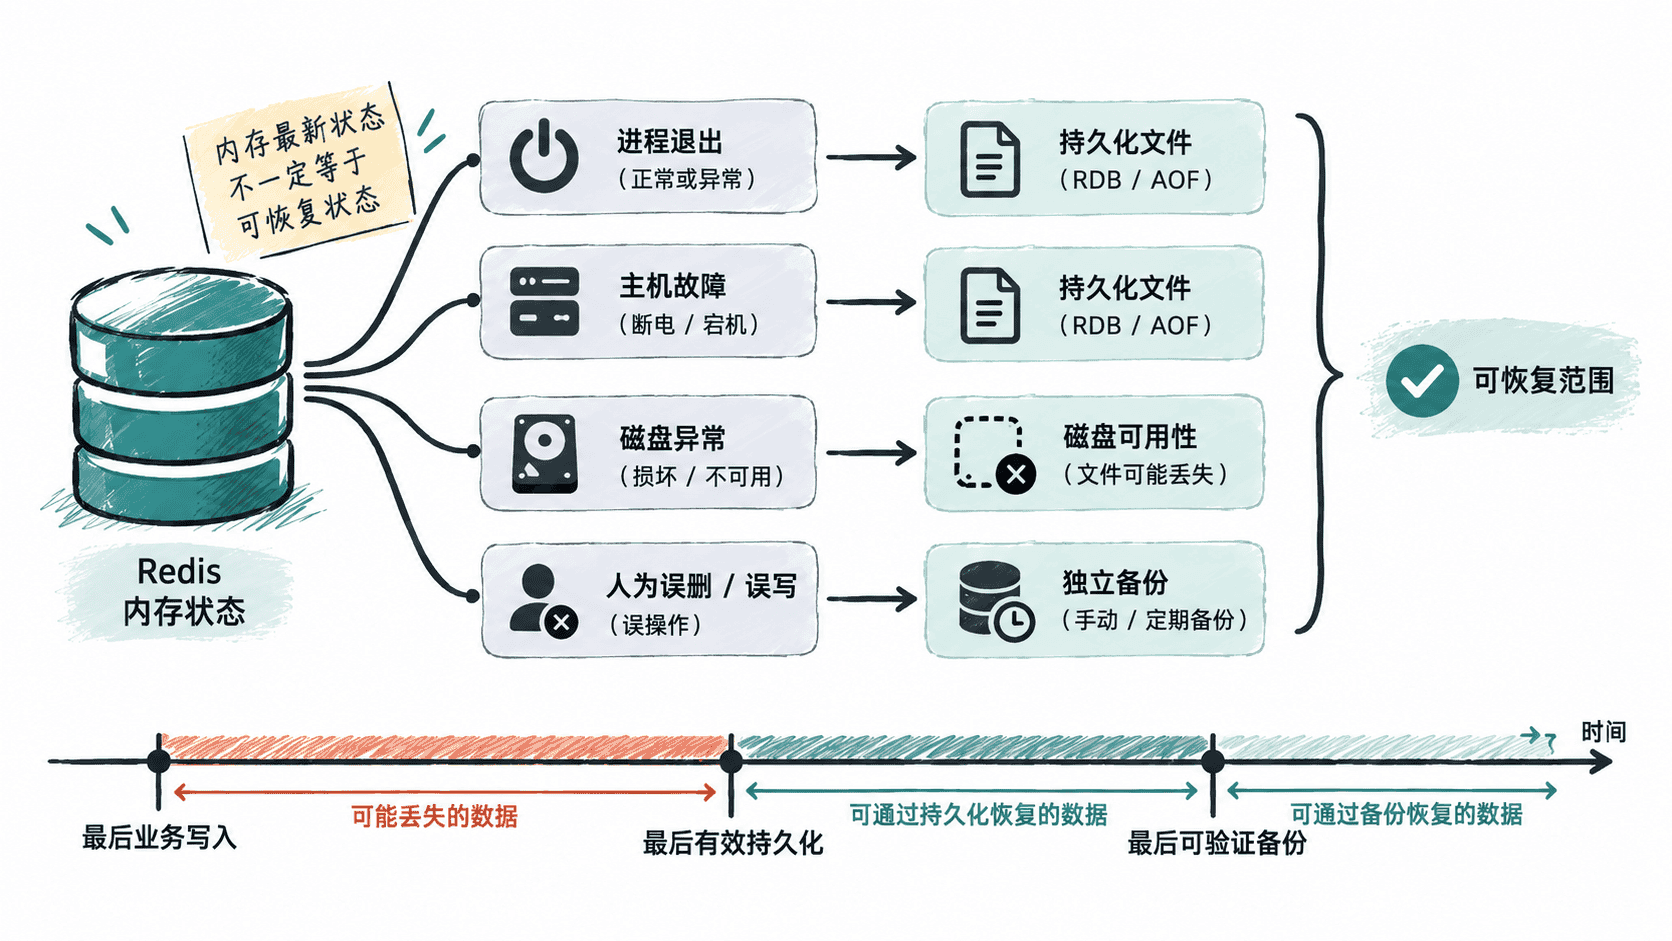
进程退出并不等于同一种风险
正常重启、进程崩溃和强制终止的影响并不完全相同,但判断逻辑是一致的:先看故障发生时内存中的最新状态是否已经写入可重新加载的数据载体,再看这些持久化内容是否仍然可用。
若实例只依赖内存状态,没有可用持久化文件,那么进程退出后最新数据无法从该实例重建。若已经启用 RDB 或 AOF,则恢复时可以从对应持久化内容重新构造内存数据集,但恢复点仍可能早于最后一次成功写入。
主机故障与磁盘异常会扩大影响范围
主机故障通常不仅影响 Redis 进程,还可能同时影响本机数据盘上的 RDB、AOF 文件。此时即使实例配置正确,也不能假设本机持久化文件一定可用。
磁盘空间不足、文件系统只读、I/O 错误或持久化文件损坏,都会让“理论上启用了持久化”与“实际存在可恢复数据”之间产生差距。判断风险时,应同时检查数据文件是否存在、是否完整,以及是否有独立副本。
人为操作可能导致逻辑数据丢失
误执行 DEL、批量覆盖、错误脚本或错误数据导入,与进程崩溃不同:Redis 可能仍然健康运行,持久化也可能正常工作,但被错误修改的数据已经被记录进新的状态。
这类故障最容易误判。重新启动 Redis 通常只会恢复“已经持久化的错误状态”,因此处理误删或误写时,真正有价值的恢复来源往往是故障发生前的 RDB、AOF 时间点或独立备份。
用“故障时刻”界定丢失范围
判断数据丢失范围时,不要只问“有没有持久化”,而要问三个时间点:最后一次业务写入、最后一次有效持久化、最后一份可验证备份。它们之间的时间差决定了可能丢失的数据窗口。
最终可以把 Redis 数据风险理解为:故障决定哪一层失效,持久化决定本机能回到哪里,独立备份决定在本机不可用时还能回到哪里。