
Redis 与缓存 / 系统课时
处理复制与故障转移后的数据风险
处理复制与故障转移后的数据风险
Redis 复制能够提高可用性,但异步复制意味着“客户端收到写入成功”不等于“副本已经拥有这条数据”。本课从故障时间窗口出发,判断主从切换可能丢失哪些写入,以及持久化、复制和故障转移分别能解决什么问题。
学习目标
- 解释异步复制为什么会在故障转移时形成数据丢失窗口
- 区分持久化、复制和自动故障转移各自承担的职责
- 用复制状态和故障演练验证生产方案的数据风险
先看清异步复制的数据窗口
Redis 主节点处理写命令后,会把复制数据继续发送给副本,但客户端响应、复制传输和副本应用并不是一个原子事务。因此在某个瞬间,主节点可能已经确认写入,而副本仍未接收到或应用这条更新。
如果主节点此时永久故障,故障转移系统只能从现存副本中选择新主节点。尚未复制过去的那部分写入不会因为“完成了主从切换”而自动出现,这就是复制场景中的数据风险窗口。
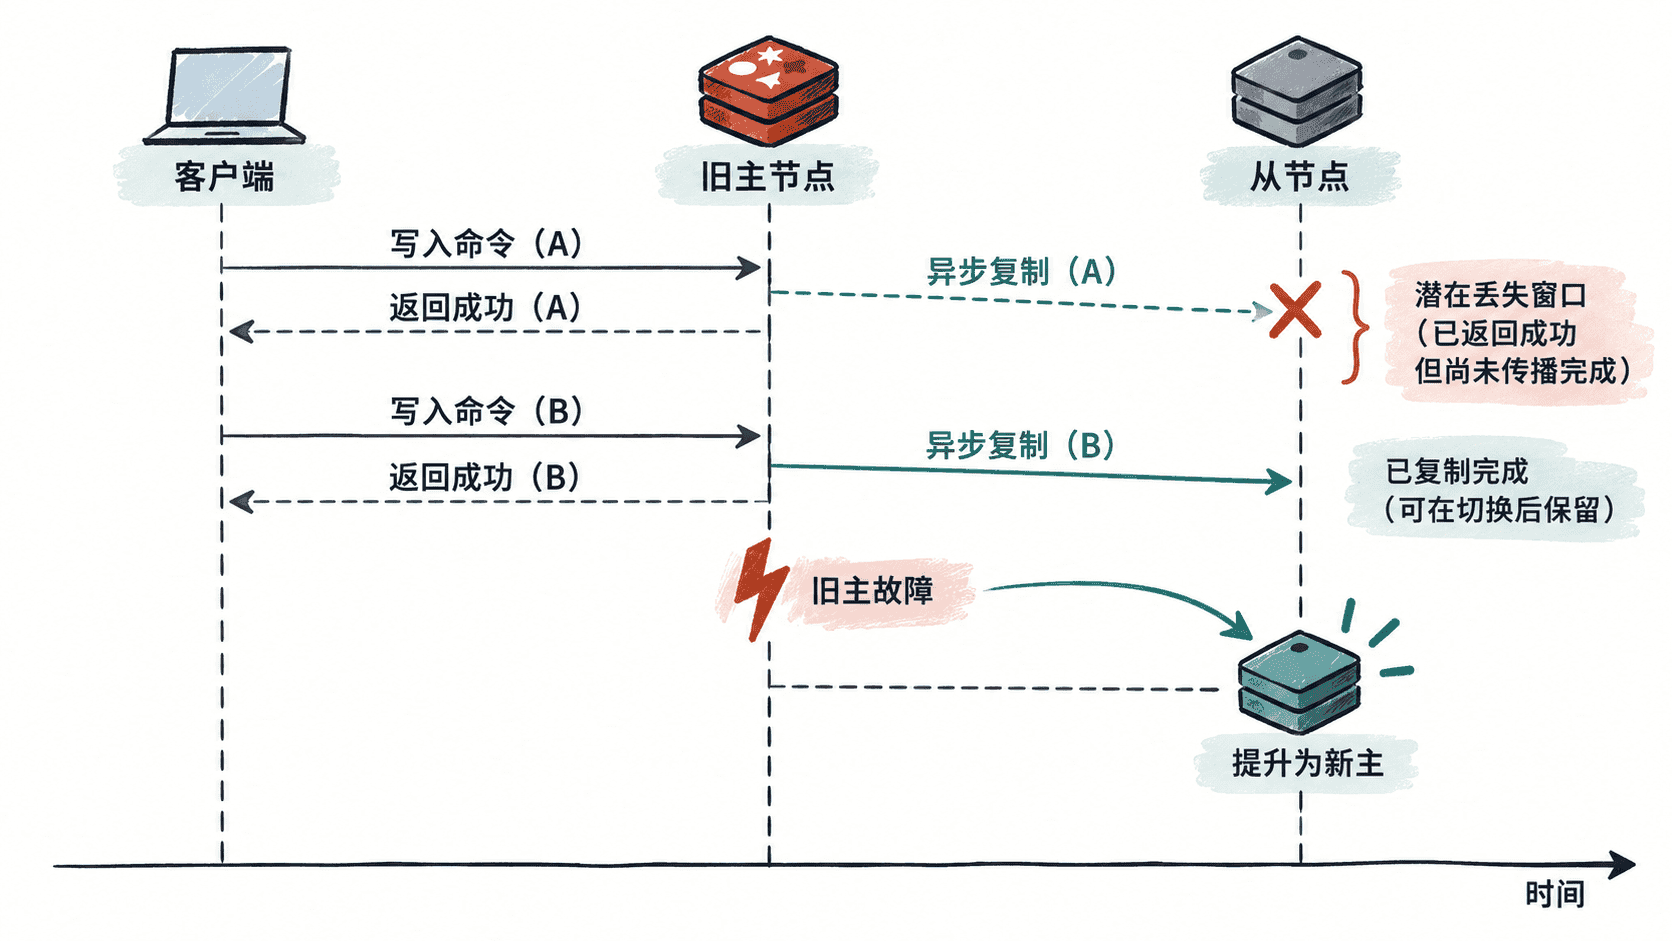
可以先在主节点查看复制角色和副本状态:
redis-cli -p <PORT> INFO replication预期输出中的具体偏移量、IP 和端口会因环境不同而变化:
# Replication
role:master
connected_slaves:<VALUE>
master_repl_offset:<VALUE>
slave0:ip=<IP>,port=<PORT>,state=online,offset=<VALUE>,lag=<VALUE>
其中主节点的复制偏移量与各副本偏移量之间存在差距时,说明仍有复制进度尚未追平。偏移量差距能反映复制积压,但不能单独证明业务已经达到所要求的 RPO,还要结合故障发生时机和写入模式判断。
持久化不能消除复制窗口
RDB 和 AOF 解决的是节点重启后如何从本地磁盘恢复数据。复制解决的是把数据传播到其他节点。两者可以组合,但不能互相替代。
例如,主节点启用了 AOF,某条写入已经落到主节点磁盘,却还没有复制到副本。如果主机只是 Redis 进程崩溃且磁盘完好,可以从主节点 AOF 恢复这条数据;如果主机和磁盘一起永久丢失,而系统直接提升旧副本,那么新主仍然缺少这条尚未复制的数据。
反过来,如果副本已经收到最新数据,但副本自身没有可靠持久化,之后又发生节点重启,也可能失去本地数据。因此生产方案通常需要同时考虑节点级持久化、跨节点复制以及备份,而不是只选择其中一种机制。
WAIT 能降低风险但不是事务提交协议
对少数必须降低复制丢失概率的写入,可以在写命令后使用 WAIT,要求指定数量的副本确认已经接收到此前的写入。例如:
redis-cli -p <PORT> SET order:1001 paid
redis-cli -p <PORT> WAIT 1 1000
预期结果可能是:
OK
(integer) 1
1 表示在等待时间内至少有一个副本确认了复制进度。如果返回 0,说明超时时仍没有满足要求的副本数量。
WAIT 可以缩小“成功响应后尚未复制”的窗口,但不能把 Redis 异步复制变成分布式强一致事务。副本确认之后仍可能发生更复杂的网络分区、故障选主或多节点失效,因此不要把它理解为永久数据安全承诺。
故障转移后先核验再恢复写流量
发生主从切换后,不应只确认新主能够连接,还要验证角色、复制拓扑和关键业务数据。首先检查当前节点角色:
redis-cli -p <PORT> ROLE新主节点的预期结果类似:
1) "master"
2) (integer) <VALUE>
3) 1) 1) "<IP>"
      2) "<PORT>"
      3) "<VALUE>"
实际副本数量和偏移量会不同。确认角色后,应抽查故障窗口前后的关键键、业务计数或幂等记录,并和上游数据库、消息系统或审计日志进行比对。若发现新主缺少已确认业务写入,需要先判断是否能够从旧主磁盘、备份或权威上游数据重新补齐,再决定是否全面恢复写流量。
生产设计中最重要的结论是:持久化负责节点本地恢复,复制负责冗余副本,故障转移负责可用性,备份负责应对更大范围的数据损坏和误操作。只有把这几层机制连起来,并明确每层仍存在的失败窗口,才能得到可执行的恢复方案。