
Redis 与缓存 / 系统课时
评估 RDB 的内存与磁盘代价
评估 RDB 的内存与磁盘代价
RDB 快照虽然由后台子进程写盘,但并不意味着对在线请求没有成本。真正需要评估的是 fork 延迟、写时复制带来的额外内存、快照写盘吞吐以及大数据集放大的持续时间。本课建立一套可直接观测这些代价的方法。
学习目标
- 解释
fork、写时复制和 RDB 写盘之间的资源关系 - 使用 Redis 指标观察快照期间的内存与持久化状态
- 判断大数据集和高写入流量何时会放大快照风险
快照期间发生了什么
执行 BGSAVE 时,Redis 主进程先 fork 出子进程。操作系统最初不会立即复制全部内存页,而是让父子进程共享原有页面;之后如果主进程继续修改某个页面,写时复制机制会为被修改的页面创建副本。
因此,快照的额外内存并不是简单等于数据集大小,而更取决于快照持续时间内有多少内存页被写入。数据集越大,通常 fork 要处理的页表越多;写入越频繁,写时复制产生的额外物理内存也越多。
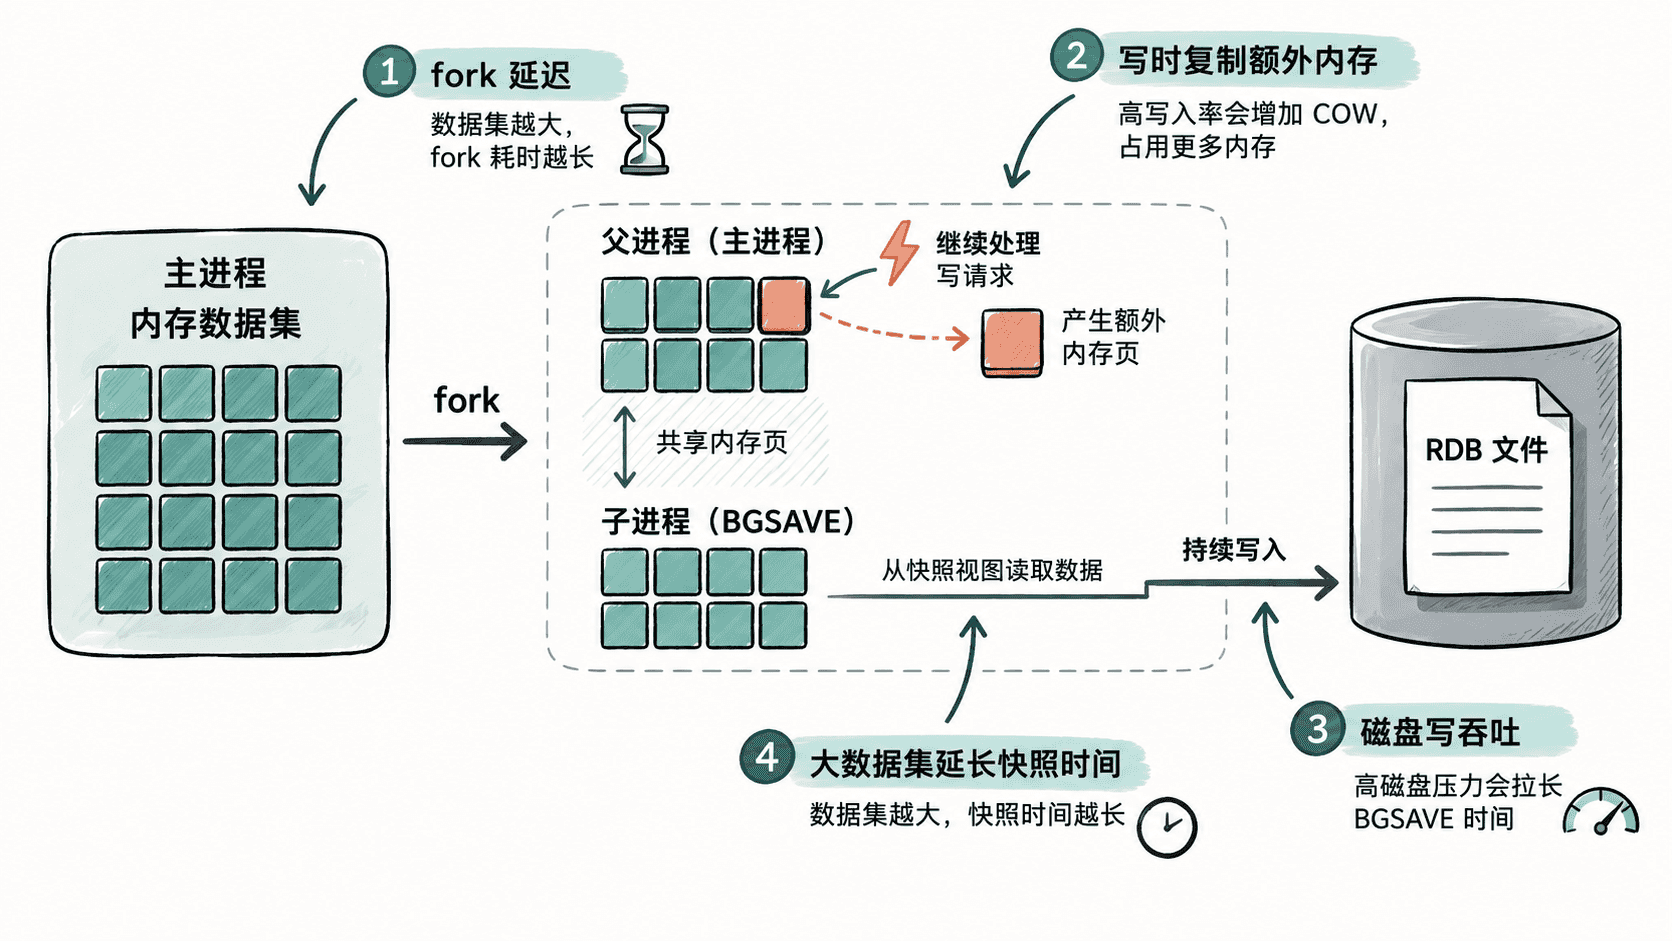
磁盘侧的影响同样重要。子进程必须遍历数据并把序列化结果写入 RDB 文件。如果磁盘吞吐不足,后台保存持续时间会增加,父子进程共同存在的时间也会变长,从而进一步扩大写时复制和内存压力。
观察 fork 与写时复制指标
可以在一次 BGSAVE 前后采集 INFO persistence 和 INFO memory。下面的命令用于实验或受控维护窗口,实际字段值会随数据规模、Redis 版本和运行环境变化。
redis-cli INFO persistence
redis-cli INFO memory
redis-cli BGSAVE
redis-cli INFO persistence
redis-cli INFO memory预期结果:能够看到后台保存状态以及内存指标。BGSAVE 的命令返回表示后台保存已启动或已处于保存状态;随后的 INFO 结果应以当前实例实际暴露的字段为准。
rdb_bgsave_in_progress:<VALUE>
rdb_last_bgsave_status:ok
latest_fork_usec:<VALUE>
used_memory:<VALUE>
used_memory_rss:<VALUE>
latest_fork_usec 表示最近一次 fork 的耗时;used_memory 反映 Redis 内存使用,used_memory_rss 反映操作系统视角的常驻集大小。与 COW 直接相关的统计项在不同 Redis 版本和构建中可能有所差异,因此示例只展示常见字段,分析时必须先以当前实例实际 INFO 输出为准,不要假定未暴露的字段一定存在。
识别高风险组合
RDB 的风险通常不是某一个因素单独触发,而是多个条件叠加。大数据集会增加 fork 和序列化工作量;高写入流量会触发更多写时复制;慢磁盘又会让子进程存活更久,使 COW 累积时间继续延长。
重点关注这些组合:
- 数据集很大,同时机器剩余内存很少
- 快照期间写入频繁,RSS 明显上涨
latest_fork_usec持续升高,并与请求延迟尖峰重合- RDB 保存持续时间明显变长,同时磁盘利用率或 I/O 等待升高
内存容量规划不能只按稳定状态下的 used_memory 贴着上限配置。对于高写入实例,还应为快照期间的 COW、内存碎片以及操作系统自身占用保留安全余量。
用系统指标补充 Redis 视角
Redis 自身能说明快照状态和内存使用,但磁盘瓶颈需要结合操作系统指标判断。在 Linux 上可以在实验期间使用 vmstat 观察 CPU、内存和 I/O 等待变化。
vmstat 1 5预期输出:连续采样系统状态;具体数值取决于机器负载。若快照期间 wa 明显升高,应进一步检查块设备吞吐和延迟,而不是仅从 Redis 内部寻找原因。
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
<VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE>
如果快照引起明显延迟,优化方向通常不是简单取消 RDB,而是缩短快照时间、降低同盘 I/O 竞争、为 COW 保留足够内存,并避免在业务写入峰值触发快照。评估 RDB 成本时应同时看内存、CPU、磁盘和业务延迟,而不是只确认 BGSAVE 最终是否返回成功。