
Redis 与缓存 / 系统课时
建立恢复决策与止损流程
建立恢复决策与止损流程
Redis 故障恢复的第一步不是立即重启或覆盖数据,而是先阻止损失继续扩大。本课建立一套可执行的决策顺序:确认故障类型和副本状态,再结合 RPO、业务是否仍在写入,选择隔离实例、停止写入、切换副本或进入数据恢复。
学习目标
- 能根据故障类型、可用副本和数据新鲜度选择恢复路径
- 能在恢复前执行隔离与停止写入等止损动作
- 能用 Redis 状态命令验证当前实例是否适合继续参与恢复
先保护现场再决定恢复方式
生产故障发生后,最危险的动作是让一个状态未知的实例继续接受写入。若故障属于误删、错误覆盖或应用持续写坏数据,新的写入还会不断扩大逻辑损失;若实例磁盘或持久化文件异常,反复启动也可能改变现场。
因此先完成三件事:限制业务写入、保留当前持久化文件、记录主从与持久化状态。只有确认现场被保护后,才进入恢复决策。
收集决定恢复路径的证据
先在仍可访问的 Redis 实例上读取角色、复制和持久化状态。下面的命令只读取状态,不修改数据。
redis-cli -h <IP> -p <PORT> INFO replication
redis-cli -h <IP> -p <PORT> INFO persistence
redis-cli -h <IP> -p <PORT> CONFIG GET dir
redis-cli -h <IP> -p <PORT> CONFIG GET dbfilename
预期输出中应能确认当前角色、复制链路和持久化状态,具体地址、偏移量与路径会因环境不同而变化。
# Replication
role:master
connected_slaves:<VALUE>

# Persistence
rdb_last_bgsave_status:ok
aof_enabled:<VALUE>
aof_last_write_status:ok

dir
<PATH>
dbfilename
dump.rdb
如果实例已经不可访问,应从监控、编排平台和磁盘副本获取同样的信息,不要为了执行这些命令而强行拉起一个可能损坏的节点。
用四个问题选择止损动作
恢复决策可以按固定顺序进行。首先判断故障是节点不可用,还是数据已经发生逻辑错误;其次确认是否存在健康且更新的数据副本;然后比较可用恢复点与业务 RPO;最后确认业务是否还在向受影响数据集写入。
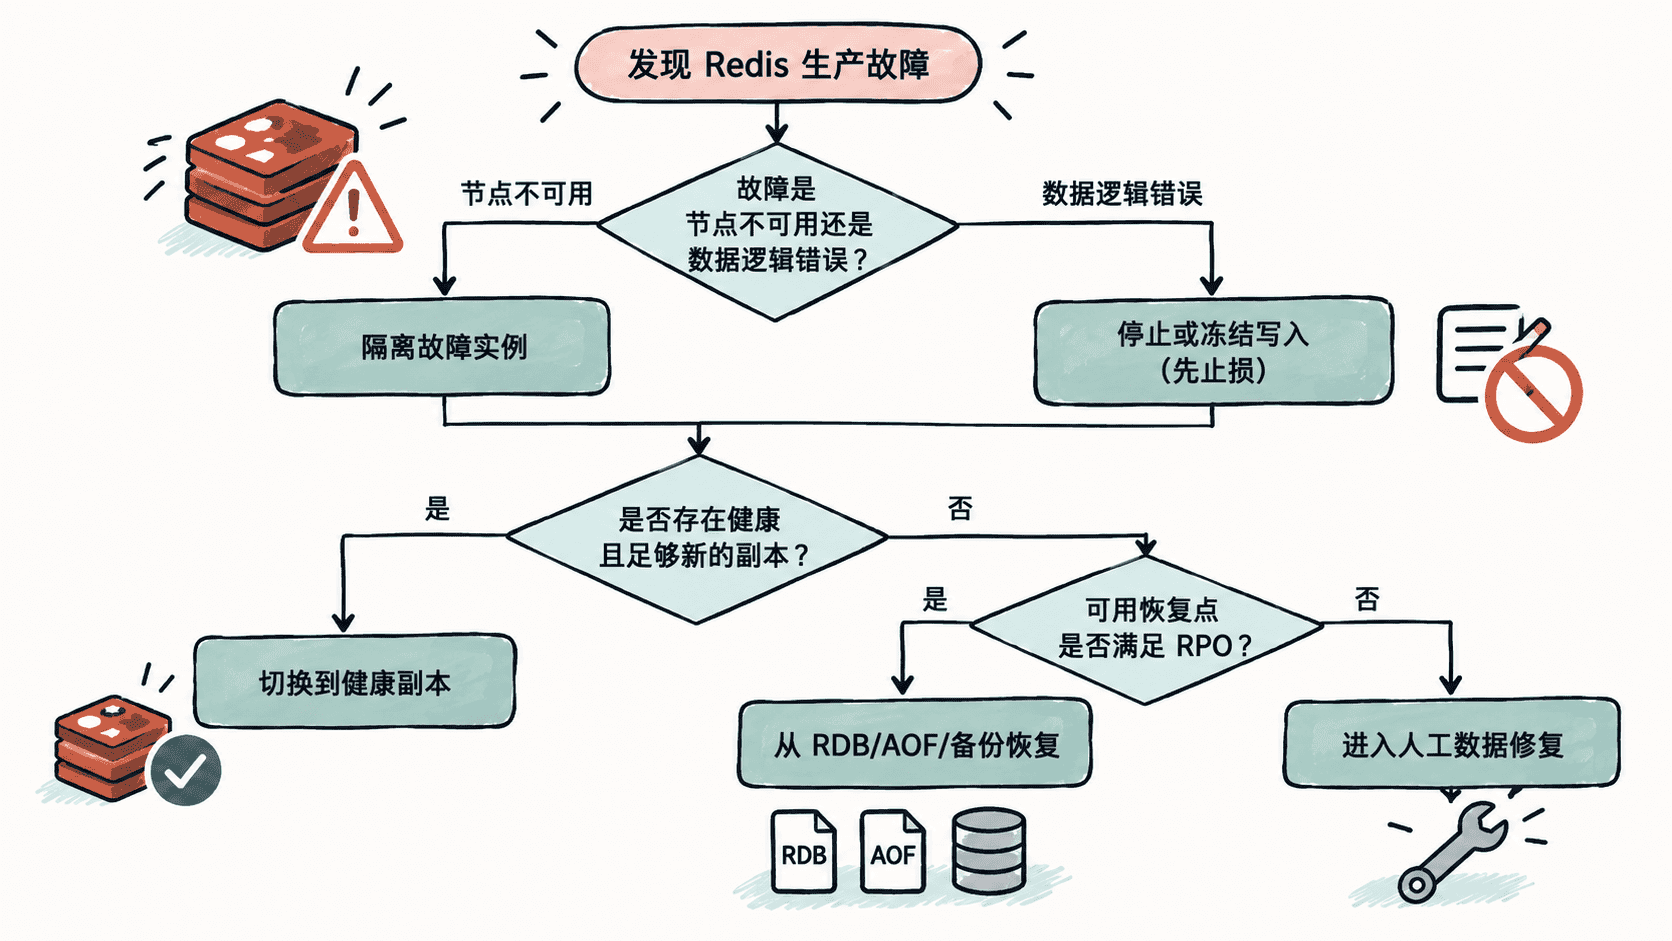
节点故障但副本健康时,通常优先利用健康副本恢复服务,而不是先做离线备份恢复。数据误删或错误写入时,即使主节点仍然在线,也应先停止相关写入,否则恢复出的正确数据可能再次被错误逻辑覆盖。
如果没有足够新的副本,就要把可用的 RDB、AOF 或外部备份时间点与 RPO 比较。恢复点早于允许的数据丢失窗口时,不能把“成功启动 Redis”视为恢复成功,而应进入业务补偿或其他数据源重建流程。
执行实例级隔离
在可控演练环境中,可以用 Redis 的只读保护模拟停止普通客户端写入。对于主节点,临时将实例改为只读不是 Redis 原生通用的主节点写保护方案,因此生产环境更可靠的做法通常是在代理、应用、网络或编排层停止写流量。
若需要从 Redis 侧快速让一个待检查副本不再跟随上游,可在确认演练目标后解除复制关系:
redis-cli -h <IP> -p <PORT> REPLICAOF NO ONE
redis-cli -h <IP> -p <PORT> INFO replication
预期结果是该实例角色变为独立主节点。此操作会改变复制拓扑,只应在明确的演练或切换步骤中执行。
OK
role:master给恢复动作设置门禁
真正进入恢复前,应至少满足三个门禁:故障实例不再接收会扩大损失的写入;待使用的副本或备份已经标明时间点和来源;恢复后的目标实例与生产流量保持隔离,直到数据校验完成。
当这三个条件都满足后,再执行切换、文件恢复或数据补偿。这样即使后续恢复失败,仍然保留原始现场和重新选择恢复点的能力,而不会因为一次仓促操作把可恢复故障变成不可逆的数据损失。