
PostgreSQL / 系统课时
排查慢查询
排查慢查询
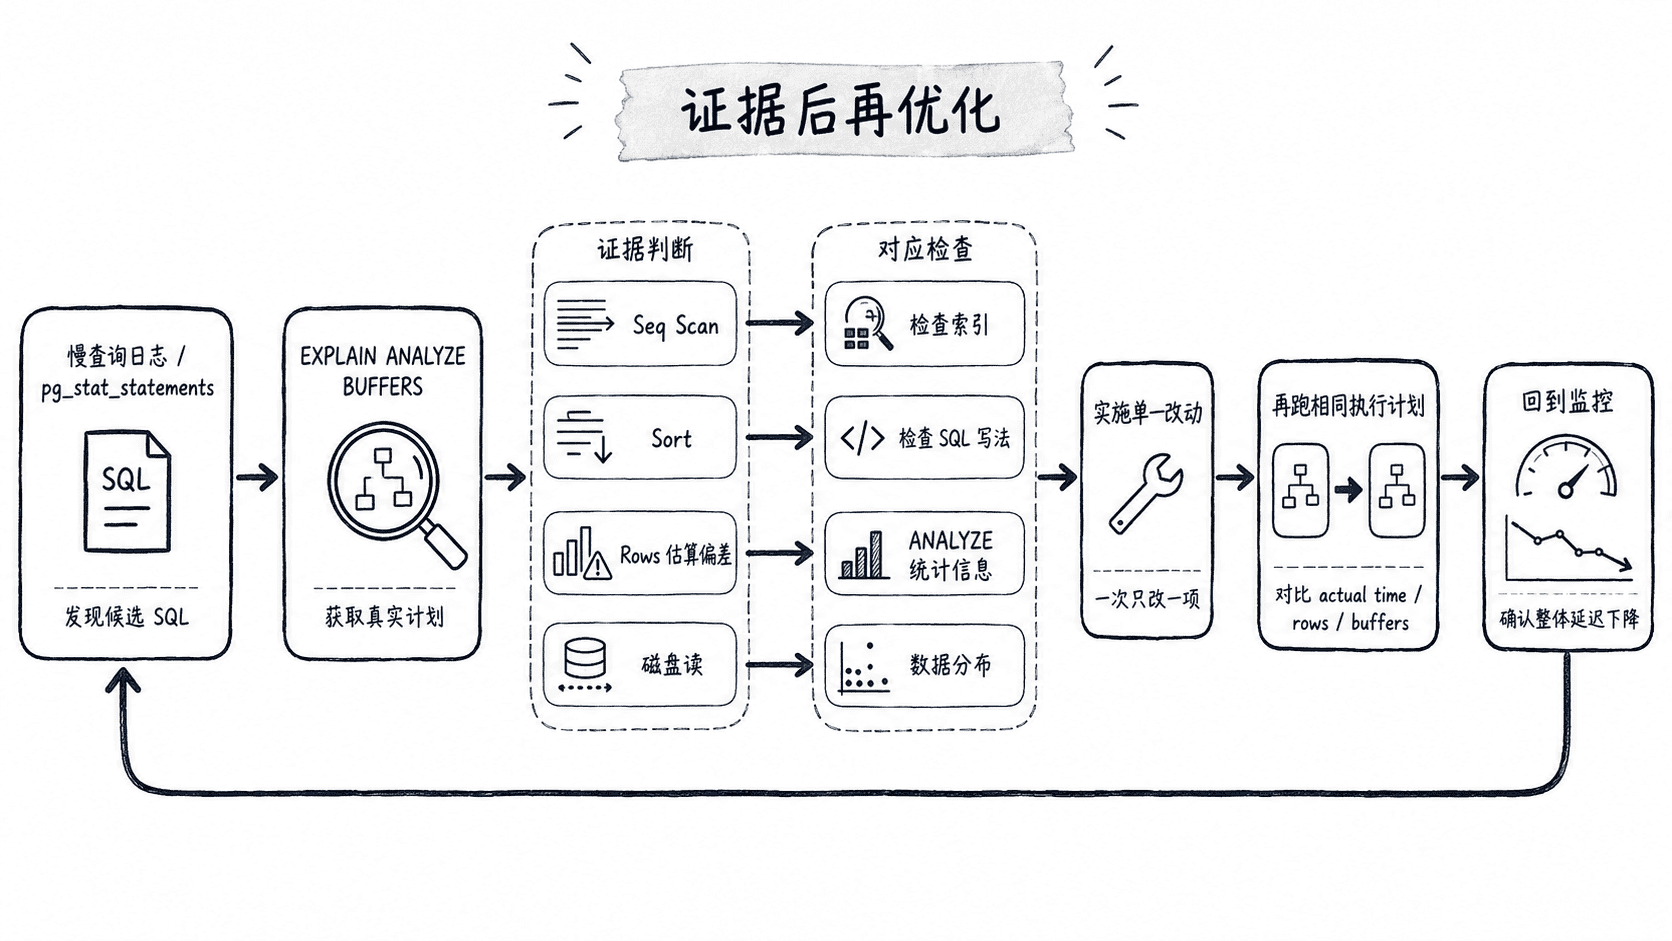
慢查询排查的目标不是“看到慢就加索引”,而是先找出最值得优化的 SQL,再用真实执行计划确认时间花在哪里,并结合统计信息判断优化器为何做出当前选择。本课用一套可复现示例完成发现、解释、修复和回归验证。
学习目标
- 从慢查询日志或
pg_stat_statements找到高耗时 SQL - 用
EXPLAIN (ANALYZE, BUFFERS)判断扫描、排序和 I/O 是否是瓶颈 - 结合统计信息与索引设计验证优化是否真正降低执行成本
先找到值得分析的 SQL
生产环境先从日志中的持续时间和 SQL 文本定位单次异常;若已启用 pg_stat_statements,还可以按累计执行时间找出长期消耗最大的语句,避免只盯住偶发的一次慢请求。
SELECT
    queryid,
    calls,
    round(total_exec_time::numeric, 2) AS total_ms,
    round(mean_exec_time::numeric, 2) AS mean_ms,
    rows,
    left(query, 120) AS query_sample
FROM pg_stat_statements
WHERE calls > 0
ORDER BY total_exec_time DESC
LIMIT 10;
预期输出
 queryid | calls | total_ms | mean_ms | rows   | query_sample
---------+-------+----------+---------+--------+-----------------------------------------------
<ID> | 8421 | 39125.84 | 4.65 | 168420 | SELECT id, created_at FROM orders WHERE ...<ID>、次数和耗时取决于实际负载。如果扩展未启用,就从数据库慢查询日志选出候选 SQL,再进入执行计划分析;不要为了临时排查直接修改生产实例的预加载配置。
用可复现实验读懂执行计划
下面创建一个临时订单表,模拟按客户查询最近订单。临时表会在当前会话结束后自动消失,不会污染业务表。先不建索引,观察 PostgreSQL 为何必须扫描大量数据。
CREATE TEMP TABLE demo_order (
    id bigint PRIMARY KEY,
    customer_id integer NOT NULL,
    created_at timestamptz NOT NULL,
    amount numeric(10,2) NOT NULL
);

INSERT INTO demo_order (id, customer_id, created_at, amount)
SELECT
    g,
    (g % 1000) + 1,
    now() - g * interval '1 minute',
    (g % 5000) / 10.0
FROM generate_series(1, 100000) AS g;

ANALYZE demo_order;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at
FROM demo_order
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
预期结果
Limit
  ->  Sort
        Sort Key: created_at DESC
        ->  Seq Scan on demo_order
              Filter: (customer_id = 42)
              Rows Removed by Filter: <VALUE>
Planning Time: <TIME> ms
Execution Time: <TIME> ms具体成本、时间和缓冲区数字会随机器变化,<VALUE> 与 <TIME> 代表动态值。这里最关键的证据是 Seq Scan:为了找出极少量目标行,执行器仍需检查大量记录,并额外执行排序。
用统计信息解释估算偏差
执行计划同时包含优化器估算行数和实际行数。两者差距很大时,即使索引存在,优化器也可能选错路径。大批量导入、数据分布明显变化后,应先更新统计信息,再判断是否真的是索引问题。
ANALYZE demo_order;

SELECT
    attname,
    n_distinct,
    null_frac
FROM pg_stats
WHERE tablename = 'demo_order'
  AND attname IN ('customer_id', 'created_at')
ORDER BY attname;
预期输出
   attname    | n_distinct | null_frac
--------------+------------+-----------
 created_at   |         -1 |         0
 customer_id  |    <VALUE> |         0
n_distinct 的精确值受采样影响;负值表示唯一值数量按表行数比例估算。重点是确认统计信息已经存在,并结合计划中的 estimated rows 与 actual rows 判断估算是否可信。
建索引后用同一查询回归
当前过滤条件是 customer_id = ?,同时要求按 created_at DESC 取最近记录,因此复合索引可以同时支持过滤和排序。只改一个变量,再执行完全相同的查询,才能知道收益来自哪里。
CREATE INDEX demo_order_customer_created_idx
    ON demo_order (customer_id, created_at DESC);

ANALYZE demo_order;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at
FROM demo_order
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
预期结果
Limit
  ->  Index Scan using demo_order_customer_created_idx on demo_order
        Index Cond: (customer_id = 42)
Planning Time: <TIME> ms
Execution Time: <TIME> ms
计划通常会从全表扫描加排序变为索引扫描,但 PostgreSQL 仍会根据表大小、选择性和缓存状态自主选择路径,所以不要把某一种节点名称当成唯一成功标准。真正要比较的是相同参数、相似负载下的执行时间、实际扫描行数和缓冲区访问量。
慢查询修复完成后,还要回到原来的日志或 pg_stat_statements 观察一段真实负载,确认平均与高分位延迟、调用量和总耗时确实改善。索引只是可能的手段;统计信息失真、返回数据过多、排序聚合、锁等待以及存储 I/O 都可能让查询变慢。