
PostgreSQL / 系统课时
验证备份可恢复性
验证备份可恢复性
备份文件存在并不等于真正可恢复。可靠的备份策略必须定期把备份恢复到隔离环境,确认归档可读、数据库能完整重建、关键数据可查询、应用依赖可运行,并记录实际恢复耗时。这样才能在事故发生前发现损坏、缺对象或操作流程失效的问题。
学习目标
- 区分“备份文件可读取”和“数据库可恢复”这两个不同层次的验证。
- 在隔离数据库中执行一次完整恢复演练,并用客观检查项验收结果。
- 记录恢复点和恢复耗时,形成可重复执行的恢复演练流程。
先定义恢复演练的通过标准
恢复演练应在与生产隔离的实例或临时数据库中完成,禁止直接覆盖现有业务库。至少要验证四件事:备份归档能读取、恢复命令完整成功、关键对象与数据可用、应用账号具备所需权限。若团队承诺了 RPO 和 RTO,还要记录备份时间点与实际恢复耗时,确认演练结果是否满足目标。
仅执行 pg_restore --list 只能证明自定义格式归档的目录可以读取,不能证明全部表数据都能成功恢复。真正的可恢复性验证必须走完“创建空库→恢复→检查→清理”的闭环。
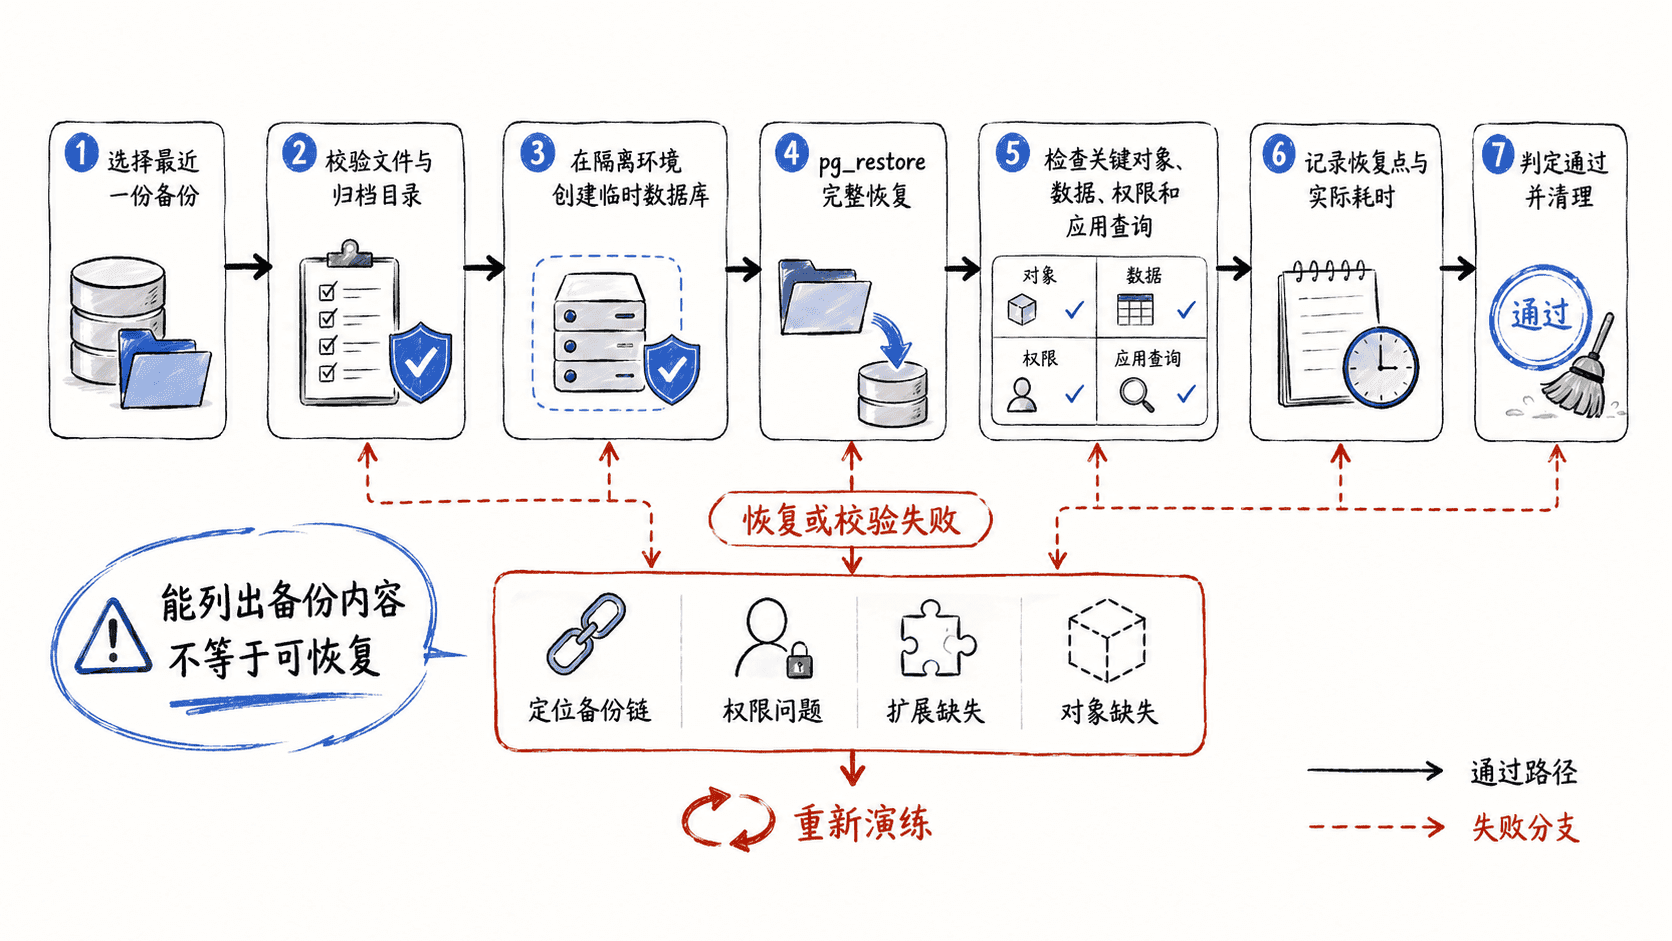
执行完整恢复而不是只看备份文件
下面示例验证一个由 pg_dump --format=custom 生成的逻辑备份。演练应在专用测试实例执行,并通过标准 libpq 环境变量 PGHOST、PGPORT、PGUSER 和受控凭据指向隔离环境。
set -euo pipefail
BACKUP_FILE="backups/app.dump"
VERIFY_DB="restore_verify_<ID>"

pg_restore --list "$BACKUP_FILE" > /tmp/restore_verify.toc
createdb "$VERIFY_DB"
START_EPOCH=$(date +%s)
pg_restore --exit-on-error --no-owner --dbname="$VERIFY_DB" "$BACKUP_FILE"
END_EPOCH=$(date +%s)
echo "restore_seconds=$((END_EPOCH - START_EPOCH))"
预期输出
restore_seconds=<SECONDS><ID> 应替换为本次演练的唯一标识,<SECONDS> 为实际恢复秒数。pg_restore 成功时没有统一固定输出,因此必须同时检查命令退出码;示例中的 set -e 会在任何一步失败时立即终止脚本,避免把半恢复状态误判为成功。
用数据和对象检查证明恢复可用
恢复结束后应执行固定的验收查询,而不是临时“随便看几张表”。检查项应覆盖关键业务表、最近数据时间、约束或索引以及应用所依赖的扩展。示例假设数据库中存在 app_user 和 orders 两张核心表。
SELECT to_regclass('public.app_user') AS app_user_table;
SELECT count(*) AS app_user_count FROM public.app_user;
SELECT max(created_at) AS latest_order_time FROM public.orders;
SELECT count(*) AS extension_count FROM pg_extension;
预期结果
 app_user_table
----------------
 app_user

 app_user_count
----------------
 <COUNT>

 latest_order_time
-------------------
 <TIME>

 extension_count
-----------------
 <COUNT>
<COUNT> 和 <TIME> 应与备份时点及事先记录的源库基线相符。对关键表不能只看行数,还应加入业务不变量,例如“订单总额不能为负”或“外键引用不存在孤儿记录”;这些规则比简单抽样更能发现恢复后的结构或数据异常。
验证应用账号和最小业务链路
管理员能够查询不代表应用一定能运行。恢复演练还要使用真实的应用角色连接临时数据库,执行一条只读查询和一条可回滚写入,确认 schema、表、序列和函数权限齐全。对于依赖特定事务隔离级别、扩展函数或触发器的系统,也应把这些行为纳入固定检查脚本。
如果团队有自动化测试,可以把数据库连接临时指向恢复实例,执行最小 smoke test,而不是整套高成本回归。核心目标是证明“应用使用自己的凭据可以完成最关键的读写路径”。
记录 RPO、RTO 和失败原因
恢复演练至少记录备份生成时间、演练开始时间、恢复完成时间、验收完成时间和最终结论。备份生成时间到故障时刻之间可能丢失的数据窗口对应 RPO;从开始恢复到服务具备可用条件的实际耗时可用于评估 RTO。若恢复时间持续变长,应提前优化备份格式、并行恢复参数、网络路径或实例规格。
恢复失败时不要只重新跑一次。归档无法读取要检查文件损坏和传输链;对象创建失败要检查扩展、版本和权限;数据恢复失败要定位具体表和错误;应用验收失败则重点检查角色授权、默认权限、序列和函数执行权。每次失败都应留下原因和修复动作,下一轮演练要验证问题确实消失。
演练结束且结果已记录后,再删除临时数据库:
dropdb "restore_verify_<ID>"预期结果
退出码:0;无标准输出dropdb 成功时通常不打印文本。若演练数据库需要保留给后续排查,不要立即删除,但必须明确生命周期和负责人,避免测试库长期占用存储。
真正可靠的备份策略以“定期恢复成功”作为证据,而不是以“备份任务显示成功”作为证据。只有恢复、数据校验、权限验证和耗时记录都能重复通过,备份才具备可验证的灾难恢复价值。