
PostgreSQL / 系统课时
排查锁等待与慢事务
排查锁等待与慢事务
锁等待往往不是“数据库突然变慢”,而是某个事务长期占有锁,后续会话只能排队。本课用系统视图定位等待者、阻塞者和长事务,再按风险从取消语句到终止会话逐级处理,并用超时策略降低再次发生的概率。
学习目标
- 用
pg_stat_activity与pg_blocking_pids()找到等待会话和直接阻塞源 - 识别长事务与
idle in transaction会话,判断它们是否仍持有锁 - 选择取消、提交回滚或终止会话,并验证阻塞已经解除
先确认真正的阻塞链
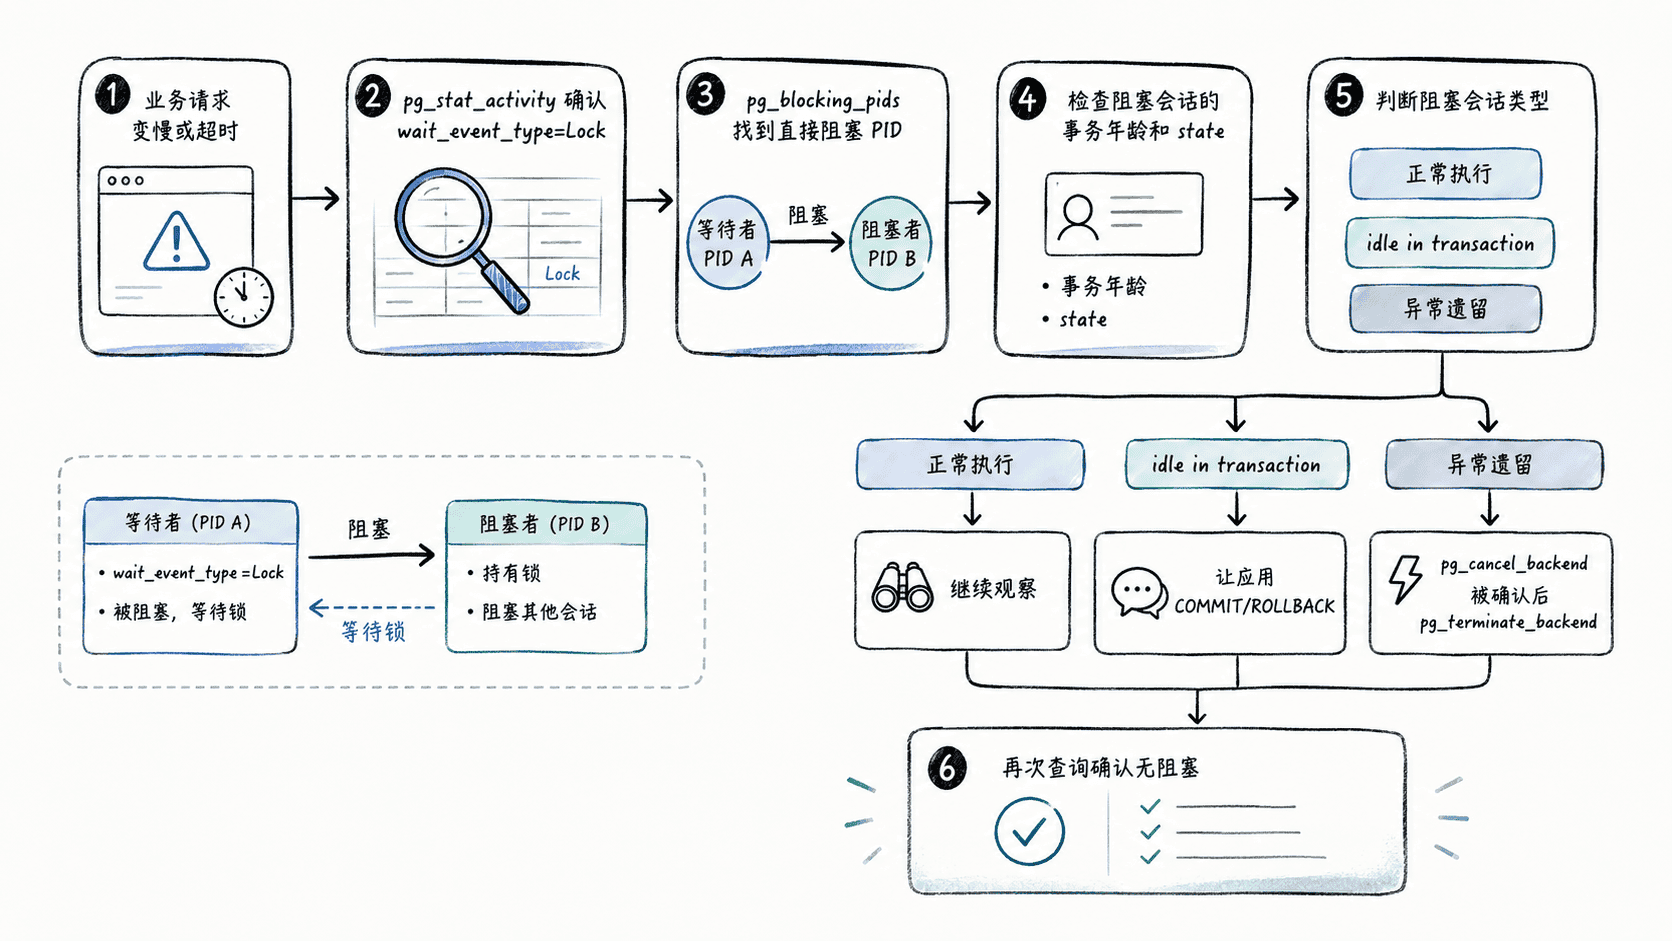
看到接口超时后,不要先重启数据库。pg_stat_activity 能看到会话状态,pg_blocking_pids(pid) 会返回直接阻塞指定会话的后端 PID。下面的查询只列出当前确实被其他会话阻塞的连接。
SELECT
    w.pid AS waiting_pid,
    w.usename AS waiting_user,
    now() - w.query_start AS waiting_for,
    b.pid AS blocking_pid,
    b.usename AS blocking_user,
    now() - b.xact_start AS blocking_xact_age,
    left(w.query, 80) AS waiting_query,
    left(b.query, 80) AS blocking_query
FROM pg_stat_activity AS w
JOIN LATERAL unnest(pg_blocking_pids(w.pid)) AS p(blocking_pid) ON true
JOIN pg_stat_activity AS b ON b.pid = p.blocking_pid
ORDER BY waiting_for DESC;
预期输出
 waiting_pid | waiting_user | waiting_for | blocking_pid | blocking_user | blocking_xact_age | waiting_query                  | blocking_query
-------------+--------------+-------------+--------------+---------------+-------------------+--------------------------------+-----------------------------
<PID> | app_user | 00:00:12 | <PID> | app_user | 00:03:41 | UPDATE account SET ... | UPDATE account SET ...<PID>、持续时间和 SQL 文本会随现场变化。重点不是等待者本身,而是 blocking_pid 对应的事务为什么一直没有结束。
再检查长事务与未提交会话
阻塞会话不一定正在执行 SQL。客户端执行过 BEGIN 后如果长时间停在 idle in transaction,事务仍未结束,可能继续持有锁和旧快照。先按事务开始时间排序,优先检查最老的会话。
SELECT
    pid,
    usename,
    application_name,
    state,
    now() - xact_start AS xact_age,
    now() - state_change AS state_age,
    wait_event_type,
    wait_event,
    left(query, 100) AS last_query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;
预期输出
 pid   | usename  | application_name | state               | xact_age | state_age | wait_event_type | wait_event | last_query
-------+----------+------------------+---------------------+----------+-----------+-----------------+------------+----------------------
 <PID> | app_user | api              | idle in transaction | 00:08:17 | 00:08:02  | Client          | ClientRead | UPDATE account SET ...
如果 xact_age 很长且 state 为 idle in transaction,应先到应用侧确认事务边界:正常业务应尽快 COMMIT 或 ROLLBACK,而不是让连接带着未提交事务回到连接池。
按破坏性从低到高处理
首先确认阻塞 PID 属于哪个应用、正在处理什么业务以及事务是否允许中断。能从应用侧正常提交或回滚时,优先让应用自己结束事务。若只是某条正在执行的语句失控,可先取消当前语句;只有确认会话已经异常遗留时,再终止整个后端连接。
-- 将 <PID> 替换为已核实的阻塞会话 PID。
SELECT pg_cancel_backend(<PID>);

-- 若取消无效且确认可以回滚整个会话,再执行:
SELECT pg_terminate_backend(<PID>);
预期输出
 pg_cancel_backend
-------------------
 t

 pg_terminate_backend
----------------------
 t
返回 t 表示信号已成功发送,不等于业务一定无损。pg_terminate_backend 会断开目标连接,未提交事务会回滚;执行者还必须具备对目标后端发送信号的权限。
验证并减少复发
处理后重新运行阻塞链查询。若返回零行,说明当前已没有被其他后端直接阻塞的会话;同时观察业务延迟是否恢复,避免只消掉一个表象。
SELECT count(*) AS blocked_sessions
FROM pg_stat_activity AS w
WHERE cardinality(pg_blocking_pids(w.pid)) > 0;
预期输出
 blocked_sessions
------------------
                0
长期治理应放在事务边界和超时策略上:应用在异常路径也要回滚事务;连接池归还连接前不能留下未提交事务;对交互式或在线业务可评估 idle_in_transaction_session_timeout、lock_timeout 和 statement_timeout,但应先按角色或业务场景设置合理阈值,避免全局“一刀切”误杀合法长任务。