
PostgreSQL / 系统课时
理解备份与恢复目标
理解备份与恢复目标
本篇先不讨论“该选哪条备份命令”,而是把数据丢失风险转化为两个可验收指标:RPO 决定最多能丢多久的数据,RTO 决定业务最多能停多久。明确这两个目标后,才能反推备份频率、恢复链路和演练标准。
学习目标
- 用 RPO 和 RTO 描述可接受的数据损失与停机时间
- 根据误删、磁盘损坏和整库故障等场景选择恢复目标
- 区分“已经生成备份”与“能够在目标时间内恢复”这两件事
先定义要防的损失场景
备份方案必须从故障场景出发。误删一批行时,重点是回到错误发生前的时间点;主机或存储损坏时,重点是把整个实例恢复到可运行状态;如果备份本身与生产环境同时受损,还需要独立故障域中的副本。
同一套系统往往需要同时覆盖多种场景。只保留每天一次逻辑备份,也许能处理部分误操作,却未必能满足“最多丢 5 分钟数据”的目标,更无法自动证明跨区域故障时能按时恢复。
用 RPO 和 RTO 描述恢复目标
RPO(Recovery Point Objective,恢复点目标)回答“恢复后最多允许缺失多长时间的数据”。如果 RPO 是 15 分钟,发生故障时应至少能恢复到故障前 15 分钟以内的某个有效状态。
RTO(Recovery Time Objective,恢复时间目标)回答“从中断到恢复服务最多允许多久”。它不只包含执行恢复命令的时间,还包括发现故障、决策、准备资源、恢复数据、校验和切流。
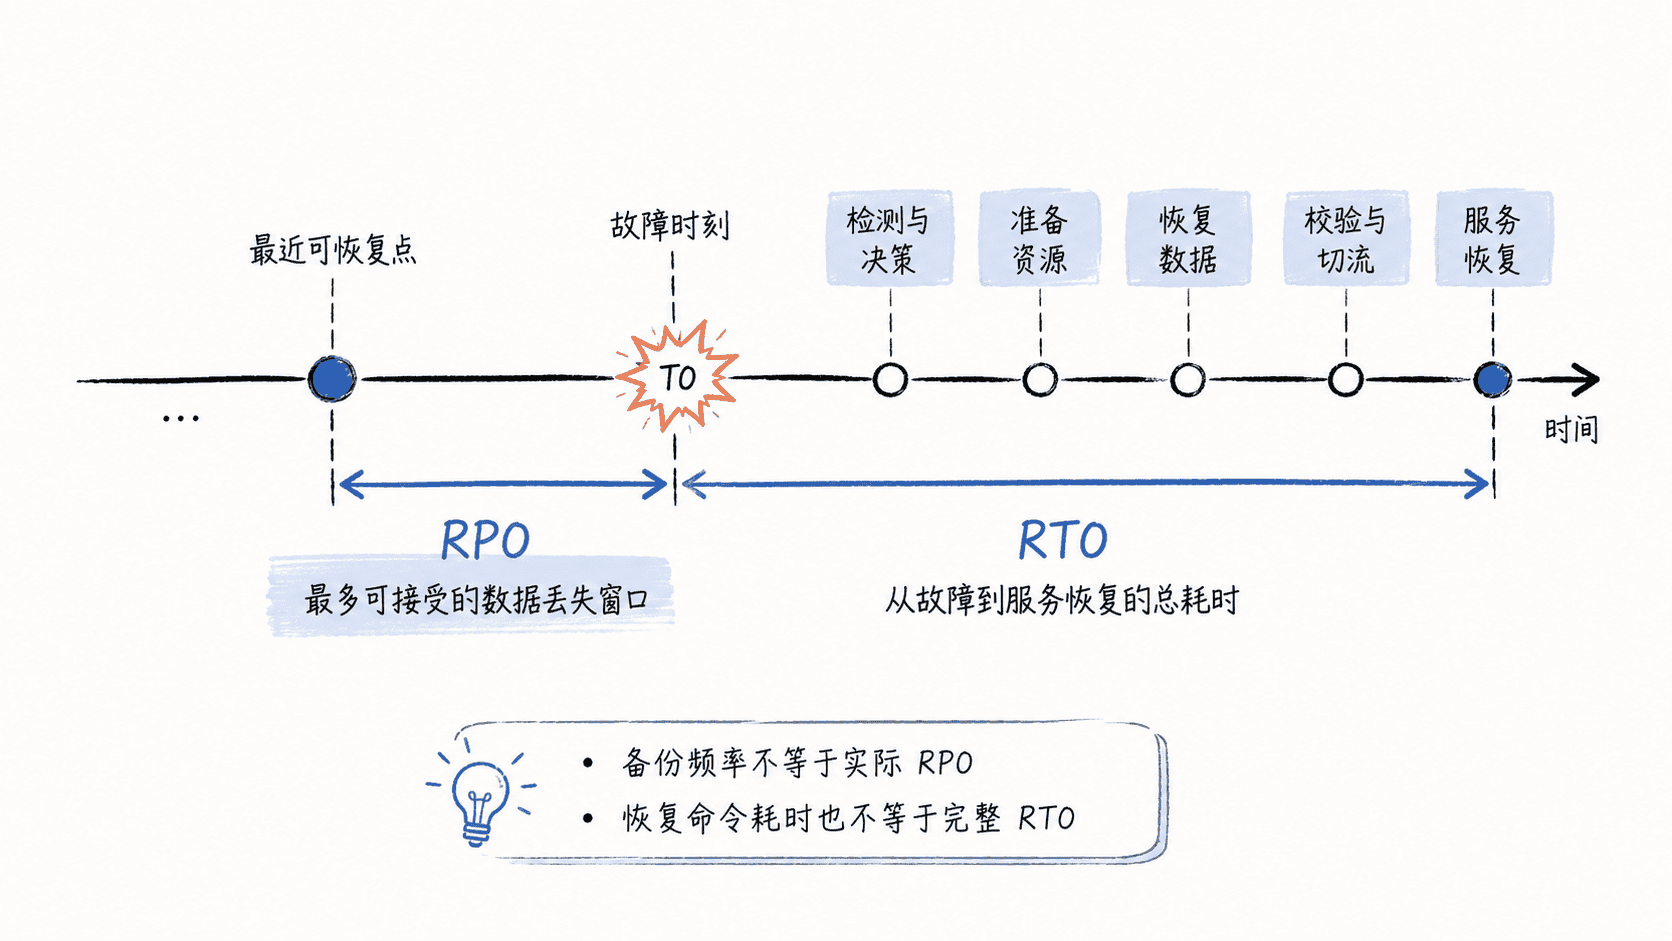
例如业务要求 RPO 5 分钟、RTO 30 分钟,那么“每天 02:00 做一次备份”显然不满足数据损失目标;即使拥有连续 WAL 归档,如果恢复演练实际需要 50 分钟,也仍然不满足 RTO。
把目标反推成备份策略
恢复目标要能落到具体机制和验收条件上。常见对应关系如下:
| 目标 | 需要考虑的机制 | 验收重点 |
|---|---|---|
| 较宽松 RPO,如 24 小时 | 定期逻辑备份或基础备份 | 最近备份是否完整、可读取 |
| 较小 RPO,如 5 分钟 | 基础备份配合持续 WAL 归档或其他连续保护 | 最近可恢复时间点与归档延迟 |
| 较小 RTO | 预置恢复环境、自动化恢复、清晰切流流程 | 从告警到服务恢复的总耗时 |
| 同时防站点级故障 | 备份复制到独立故障域 | 生产站点失效后备份仍可访问 |
用最小实验区分备份存在与可恢复
下面的命令只验证“逻辑备份文件确实生成且非空”。它不能证明 RPO 或 RTO 达标,但适合作为恢复体系的第一层检查。运行前需保证 pg_dump 能连接到 appdb。
BACKUP_FILE="./appdb-backup.dump"
pg_dump -Fc -d appdb -f "$BACKUP_FILE"
test -s "$BACKUP_FILE" && echo "backup-created"
预期输出
backup-created下一步还必须在隔离环境执行恢复并计时,例如记录从开始处置到数据库通过校验、应用重新接流的总时间。若备份每 5 分钟生成一次,但最近三个文件都损坏,实际 RPO 就不是 5 分钟;若数据 10 分钟恢复完成但审批、校验和切流又耗时 25 分钟,实际 RTO 至少是 35 分钟。
把目标写成可验收的承诺
一个可执行的恢复目标应同时包含范围、指标和证据。例如:“核心订单库在单机存储故障时,RPO 不超过 5 分钟,RTO 不超过 30 分钟;每月从独立备份副本完成一次恢复演练,并记录最近可恢复时间点和端到端恢复耗时。”
这样的目标才能指导后续选择 pg_dump、物理基础备份、WAL 归档、时间点恢复或高可用方案。先明确允许丢多少数据、允许停多久,再选择工具,才能避免“备份很多,却不知道是否真的能恢复”的工程盲区。