
PostgreSQL / 系统课时
迁移数据库到新环境
迁移数据库到新环境
数据库迁移不是把一个备份文件“搬过去”就结束,而是要把版本、对象、数据、角色权限和应用连接一起完成交接。本篇采用停写窗口内的逻辑迁移流程:先核对兼容性,再备份与恢复,最后做权限修复、业务校验和连接切换。
学习目标
- 核对源端与目标端 PostgreSQL 版本、扩展、编码和关键参数是否兼容。
- 使用
pg_dump、pg_dumpall和pg_restore完成可回滚的逻辑迁移。 - 在切换应用连接前验证对象、数据、权限与写入能力,并明确回退条件。
迁移前先冻结边界
最稳妥的基础迁移方式是安排短暂维护窗口:先让应用停止写入,再做最终备份并恢复到新环境。这样切换点清晰,不会出现“旧库继续产生新数据,而新库已经开始服务”的双写分叉。若业务无法停写,应改用逻辑复制或专用迁移服务持续同步,本篇不把一次性 pg_dump 伪装成零停机方案。
迁移前至少确认四类信息:源端和目标端主版本、数据库编码与排序规则、扩展及其版本、目标环境是否允许创建所需角色和扩展。跨大版本迁移时,优先使用与目标端同版本或更高版本的 pg_dump 客户端连接源库;旧版客户端不能转储版本高于自身主版本的 PostgreSQL 服务器。
先核对最小环境基线:
psql "$SOURCE_URL" -Atc "select current_setting('server_version'), current_setting('server_encoding'), current_setting('lc_collate');"
psql "$TARGET_URL" -Atc "select current_setting('server_version'), current_setting('server_encoding'), current_setting('lc_collate');"
psql "$SOURCE_URL" -Atc "select extname || '=' || extversion from pg_extension order by 1;"
预期输出
<SOURCE_VERSION>|UTF8|<SOURCE_COLLATION>
<TARGET_VERSION>|UTF8|<TARGET_COLLATION>
<EXTENSION>=<VERSION>
版本、排序规则和扩展列表会因环境不同而变化。若目标端缺少源库依赖的扩展,或排序规则差异会影响索引和文本排序结果,应先处理兼容性问题,再进入停写窗口。
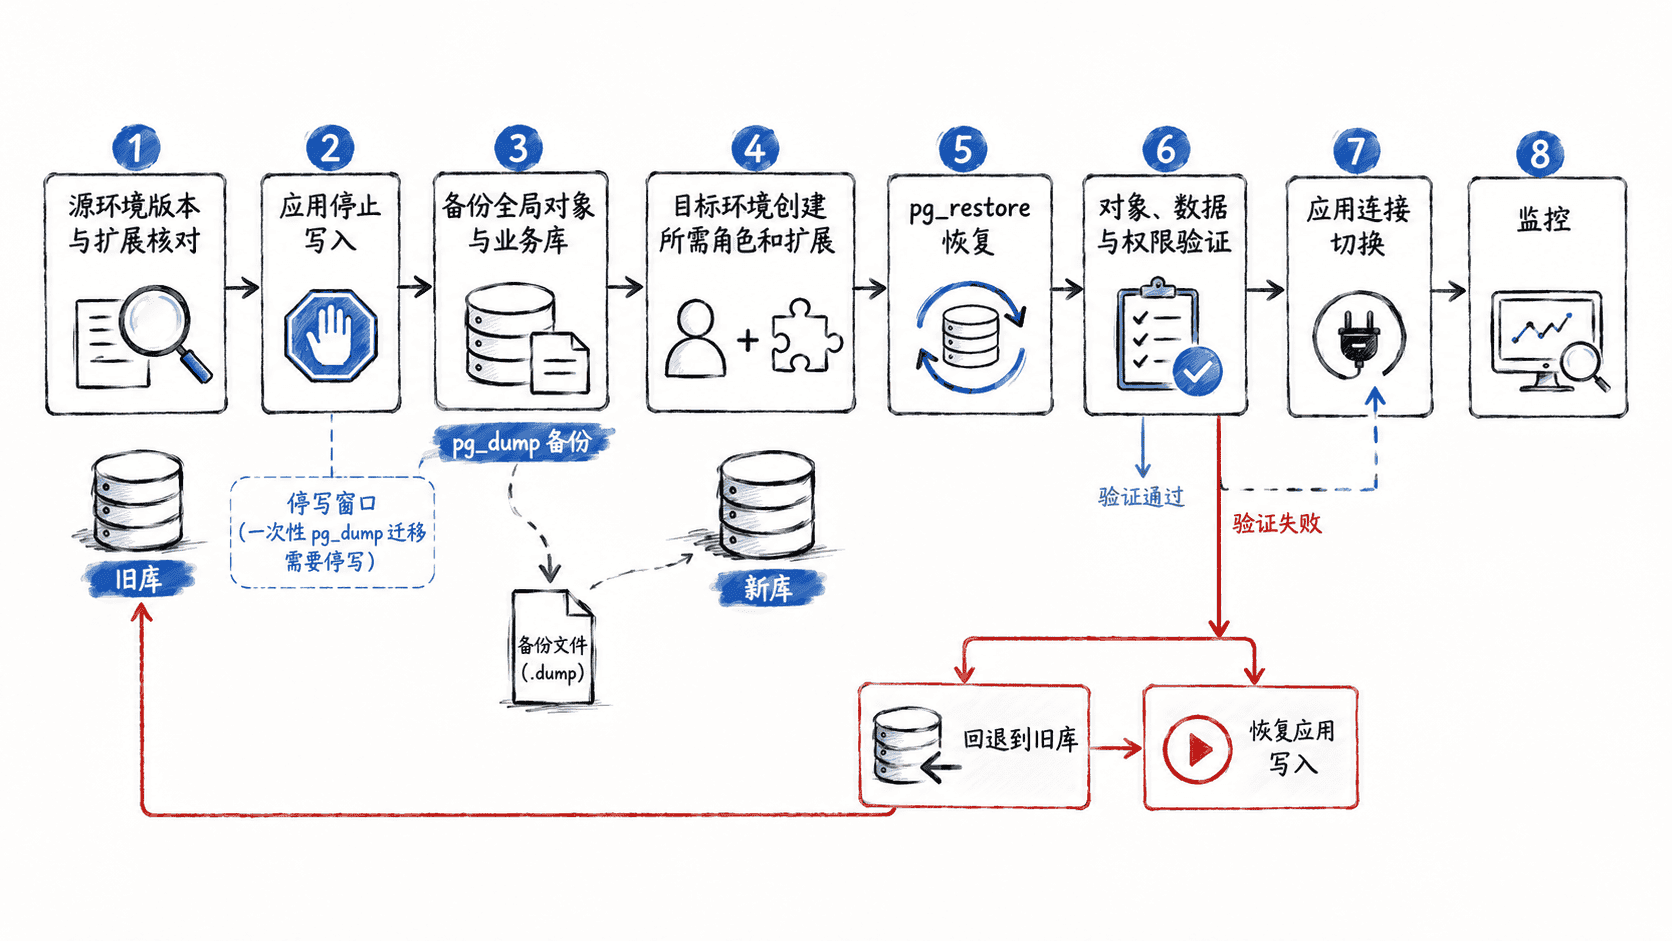
备份全局对象和业务数据库
pg_dump 只负责单个数据库,不包含角色等集群级对象。迁移前先导出全局对象清单,再用自定义格式备份业务数据库。示例使用 --no-role-passwords,避免把角色密码哈希写入迁移文件;目标环境若需要密码,应通过密钥系统或受控运维流程重新设置。
mkdir -p migration
pg_dumpall --dbname="$SOURCE_ADMIN_URL" --globals-only --no-role-passwords > migration/globals.sql
pg_dump --dbname="$SOURCE_URL" --format=custom --file=migration/app.dump
pg_restore --list migration/app.dump > migration/app.toc
wc -c migration/app.dump
预期输出
<BYTES> migration/app.dump<BYTES> 是备份文件实际字节数。pg_restore --list 能读取目录,说明归档结构可解析,但它不能替代真正的恢复演练。正式切换前还应把 migration 目录放到受控存储,并记录备份时间、源库标识和操作者。
在目标环境恢复并修复权限
目标端先创建业务依赖的扩展和角色,再恢复数据库对象。托管 PostgreSQL 往往不允许恢复源端的超级用户属性,因此不要盲目执行整个 globals.sql;应先审查文件,只迁移确实需要的角色和角色成员关系。
下面示例假设目标端已经创建空数据库,并由 TARGET_OWNER 作为统一对象所有者。--no-owner 避免源环境所有者不存在导致恢复失败,--role 让恢复过程通过目标业务所有者创建对象。
pg_restore --dbname="$TARGET_URL" --no-owner --role="$TARGET_OWNER" --exit-on-error migration/app.dump
psql "$TARGET_URL" -v ON_ERROR_STOP=1 -c "GRANT USAGE ON SCHEMA public TO app_runtime;"
psql "$TARGET_URL" -v ON_ERROR_STOP=1 -c "GRANT SELECT, INSERT, UPDATE, DELETE ON ALL TABLES IN SCHEMA public TO app_runtime;"
psql "$TARGET_URL" -v ON_ERROR_STOP=1 -c "GRANT USAGE, SELECT ON ALL SEQUENCES IN SCHEMA public TO app_runtime;"
预期输出
GRANT
GRANT
GRANT
pg_restore 成功时通常不输出固定文本,应以退出码 0 为成功标准;--exit-on-error 会在首个 SQL 错误时终止恢复。真实权限模型可能包含专用 schema、函数和默认权限,应按应用实际需要补齐,而不是简单给运行账号超级用户权限。
切换前做数据与写入验收
恢复完成后,至少验证关键表是否存在、行数是否合理、应用账号能否读写,以及业务依赖的序列和约束是否正常。不要只比较“数据库能连接”,因为权限缺失、序列未授权或扩展缺失往往会在第一笔写请求才暴露。
下面的写入探针属于片段示例,前提是目标库已经存在专用的 migration_probe(note text) 测试表;若没有这类表,应改用业务允许回滚的真实写入路径。
SELECT current_database(), current_user;
SELECT count(*) AS users_count FROM app_user;
BEGIN;
INSERT INTO migration_probe(note) VALUES ('cutover-check');
ROLLBACK;
预期结果
 current_database | current_user
------------------+--------------
 <DATABASE>       | <USER>

 users_count
-------------
 <COUNT>

BEGIN
INSERT 0 1
ROLLBACK<DATABASE>、<USER> 和 <COUNT> 以目标环境实际值为准。事务回滚探针可以验证写权限和约束,同时不留下测试数据;如果失败,应在连接切换前修复角色、schema、表或序列授权。
执行连接切换并保留回退点
验收通过后再修改应用的数据库连接配置,滚动重启或重新部署应用,并观察错误率、连接数、慢查询和关键写请求。切换后不要立刻销毁旧环境,应保持旧库只读并保留原备份,直到业务确认新库稳定。
回退条件应在切换前写清楚,例如关键接口连续失败、核心表校验不一致或权限问题无法在维护窗口内修复。一旦触发回退,应立即停止新环境写入,把应用连接恢复到旧库;如果新库已经接受了业务写入,就不能直接切回,否则会丢失这些新数据,此时必须先评估差异并制定反向同步方案。
一次可靠迁移的完成标志不是“pg_restore 没报错”,而是源端停止写入后形成了唯一切换点,目标端对象和数据可用,应用账号权限正确,业务请求通过验证,并且回退路径在切换前已经明确。