
PostgreSQL / 系统课时
完成索引治理综合演练
完成索引治理综合演练
本课把慢查询与索引膨胀放进同一故障场景:先采集可验证证据,再区分查询计划问题和物理膨胀问题,最后选择低风险治理动作并复盘验证。完成后,你应能把“SQL 很慢”还原成一条可审计的治理链路,而不是直接重建索引。
学习目标
- 能按固定顺序采集慢查询、索引使用和索引体积证据
- 能判断性能瓶颈究竟来自访问路径、索引膨胀还是并发资源压力
- 能在治理前后用同一组指标验证收益,并记录回滚与复盘依据
建立统一的故障判断框架
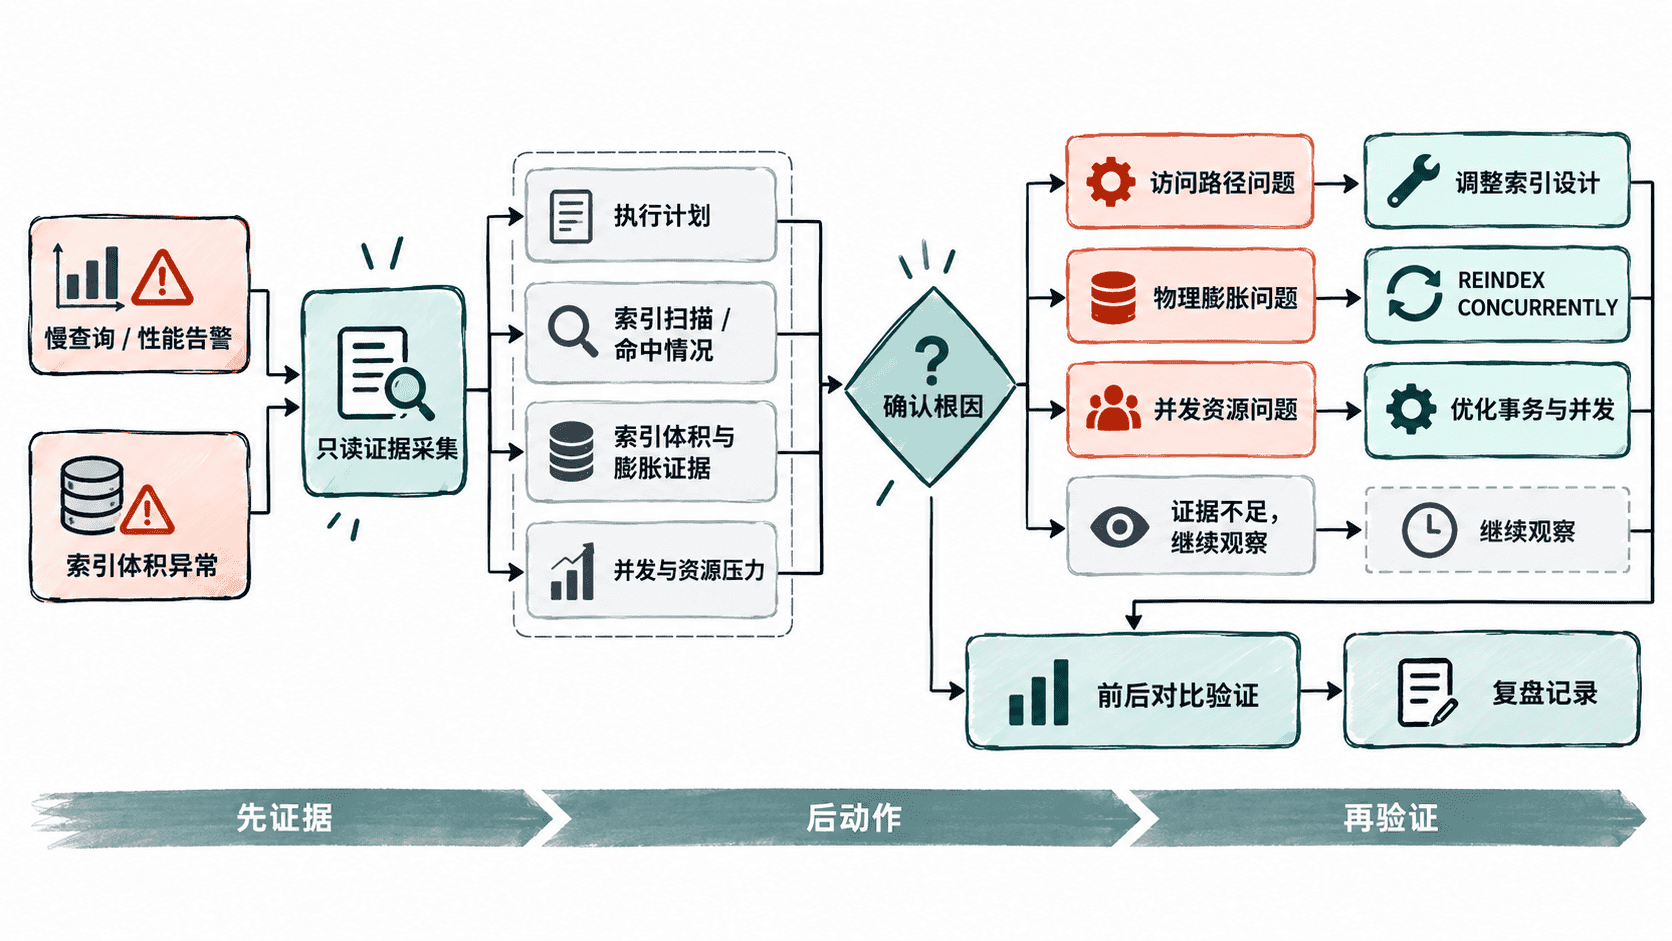
综合演练最容易犯的错误,是看到索引很大就立刻执行 REINDEX。正确做法是先证明两个事实:当前慢查询确实存在,并且目标索引存在异常体积、低利用率或其他支持治理的证据。两类证据同时出现,也不能直接证明“膨胀就是慢查询唯一根因”,还要结合执行计划、过滤条件和并发环境判断。
本次演练按“现象 → 证据 → 判断 → 治理 → 验证”推进。证据阶段尽量先做只读采集;治理阶段才执行会改变索引结构的操作,并提前确认业务窗口、并发影响和回退方案。
采集故障前证据
先固定观察窗口,避免治理前后拿不同时间段的数据比较。最小证据集包括慢查询的执行次数与耗时、目标索引的扫描统计、索引和表的物理大小。若环境启用了 pg_stat_statements,优先从聚合后的语句统计定位高成本 SQL;它比只看单次 EXPLAIN ANALYZE 更能反映线上真实负载。
下面示例只读取系统视图和统计信息,不执行修复动作。pg_stat_statements 需要提前安装并启用;如果实例没有该扩展,可以先用应用慢日志或其他现有监控代替,不要为了演练临时修改生产参数。
SELECT
    s.queryid,
    left(s.query, 120) AS query_sample,
    s.calls,
    round(s.total_exec_time::numeric, 2) AS total_exec_ms,
    round(s.mean_exec_time::numeric, 2) AS mean_exec_ms,
    round(s.rows::numeric, 0) AS rows_returned
FROM pg_stat_statements AS s
WHERE s.calls > 0
ORDER BY s.total_exec_time DESC
LIMIT 10;

SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size,
    pg_size_pretty(pg_relation_size(relid)) AS table_size
FROM pg_stat_user_indexes
ORDER BY pg_relation_size(indexrelid) DESC
LIMIT 20;
预期结果
 queryid | query_sample | calls | total_exec_ms | mean_exec_ms | rows_returned
---------+--------------+-------+---------------+--------------+--------------
 <ID>    | <SQL文本>    | <VALUE> | <VALUE>      | <VALUE>      | <VALUE>

 schemaname | table_name | index_name | idx_scan | index_size | table_size
------------+------------+------------+----------+------------+-----------
 <SCHEMA>   | <TABLE>    | <INDEX>    | <VALUE>  | <VALUE>    | <VALUE>
这里不要把“大索引”直接等同于“严重膨胀”。索引大可能只是数据量大、索引键宽、覆盖列较多,或者本身设计就要求较大空间。真正的治理判断需要继续观察执行计划、索引访问模式,以及能够直接测量物理膨胀的指标。
区分访问路径与物理膨胀
针对已经定位的慢 SQL,在低风险测试环境先执行 EXPLAIN (ANALYZE, BUFFERS)。重点观察实际扫描行数、返回行数、访问算子和缓冲区命中情况。若估算行数与实际行数长期偏离,优先考虑统计信息或查询条件问题;若计划已经合理,却伴随异常大的索引体积、较高维护代价或明确的膨胀证据,才进入索引物理治理。
生产环境不要因为“诊断需要”就随意对超大查询运行 EXPLAIN ANALYZE,因为它会真正执行 SQL。生产排查可以先用 EXPLAIN 获取计划,再结合既有慢查询数据判断。
对膨胀的判断应采用专门的测量工具或既有运维指标。例如实验环境安装 pgstattuple 后,可以对目标索引进一步测量;这一步属于诊断增强,不应替代前面的线上统计证据。
执行治理动作并控制风险
当证据表明索引确有物理治理价值时,在线业务优先评估 REINDEX INDEX CONCURRENTLY。它的主要价值是降低重建期间对普通读写的阻塞风险,但并不等于“没有资源成本”:重建过程仍会消耗 I/O、CPU 和额外磁盘空间,并可能产生更长的维护时间。
因此,演练中的执行门禁至少包含业务低峰期、磁盘余量、目标索引对象确认,以及并发资源监控。若根因其实是索引设计不合理,例如条件没有利用现有索引、列顺序不匹配或返回大量无效行,仅重建索引通常只能改善物理状态,不能消除查询本身的问题。
REINDEX INDEX CONCURRENTLY <SCHEMA>.<INDEX>;预期结果
REINDEX上面的 <SCHEMA> 和 <INDEX> 是实际环境中的对象名占位符;正式执行前必须替换为已经完成证据确认的目标索引。若使用 psql,执行结束后应重新检查索引大小、扫描统计以及原慢查询指标,而不是只看 REINDEX 返回成功。
用同一组指标完成验收
治理完成后,重复前面的证据采集,并尽量保持相同观察窗口、相同业务负载和相同 SQL。验收至少看四个方向:查询延迟是否下降,执行计划是否符合预期,目标索引物理状态是否改善,以及系统资源压力是否出现新的回归。
不要把“索引尺寸变小”作为唯一成功标准。有些重建只是回收空间,却没有改变访问路径;也有些查询延迟下降来自缓存状态变化,而不是索引治理本身。最可信的结论是多个信号同时改善,并且能与治理动作建立时间上的对应关系。
复盘时记录原始症状、关键证据、根因假设、执行门禁、实际操作、前后指标和异常分支。若最终发现真正的问题是索引设计而不是膨胀,应把治理结论转化为索引设计规则或监控项,避免下一次故障继续依赖人工猜测。
一次合格的综合演练,不是成功执行一次 REINDEX,而是能够证明“为什么要动、动了什么、风险如何受控、结果如何被验证”。当慢查询、索引体积和并发压力同时出现时,坚持先证据后治理,才能避免把一个可定位的问题扩大成新的线上事故。