
PostgreSQL / 系统课时
处理在线索引治理风险
处理在线索引治理风险
本课解决线上重建索引最容易失控的几个环节:什么时候可以做、做之前看什么、执行中观察什么、失败后如何止损,以及完成后如何确认业务没有受到持续影响。
学习目标
- 能在重建前检查索引状态、体量、锁等待和磁盘余量。
- 能使用
REINDEX CONCURRENTLY配合运行时观察,控制线上维护风险。 - 能识别失败后残留的无效索引,并完成安全验证与清理。
重建前先判断风险
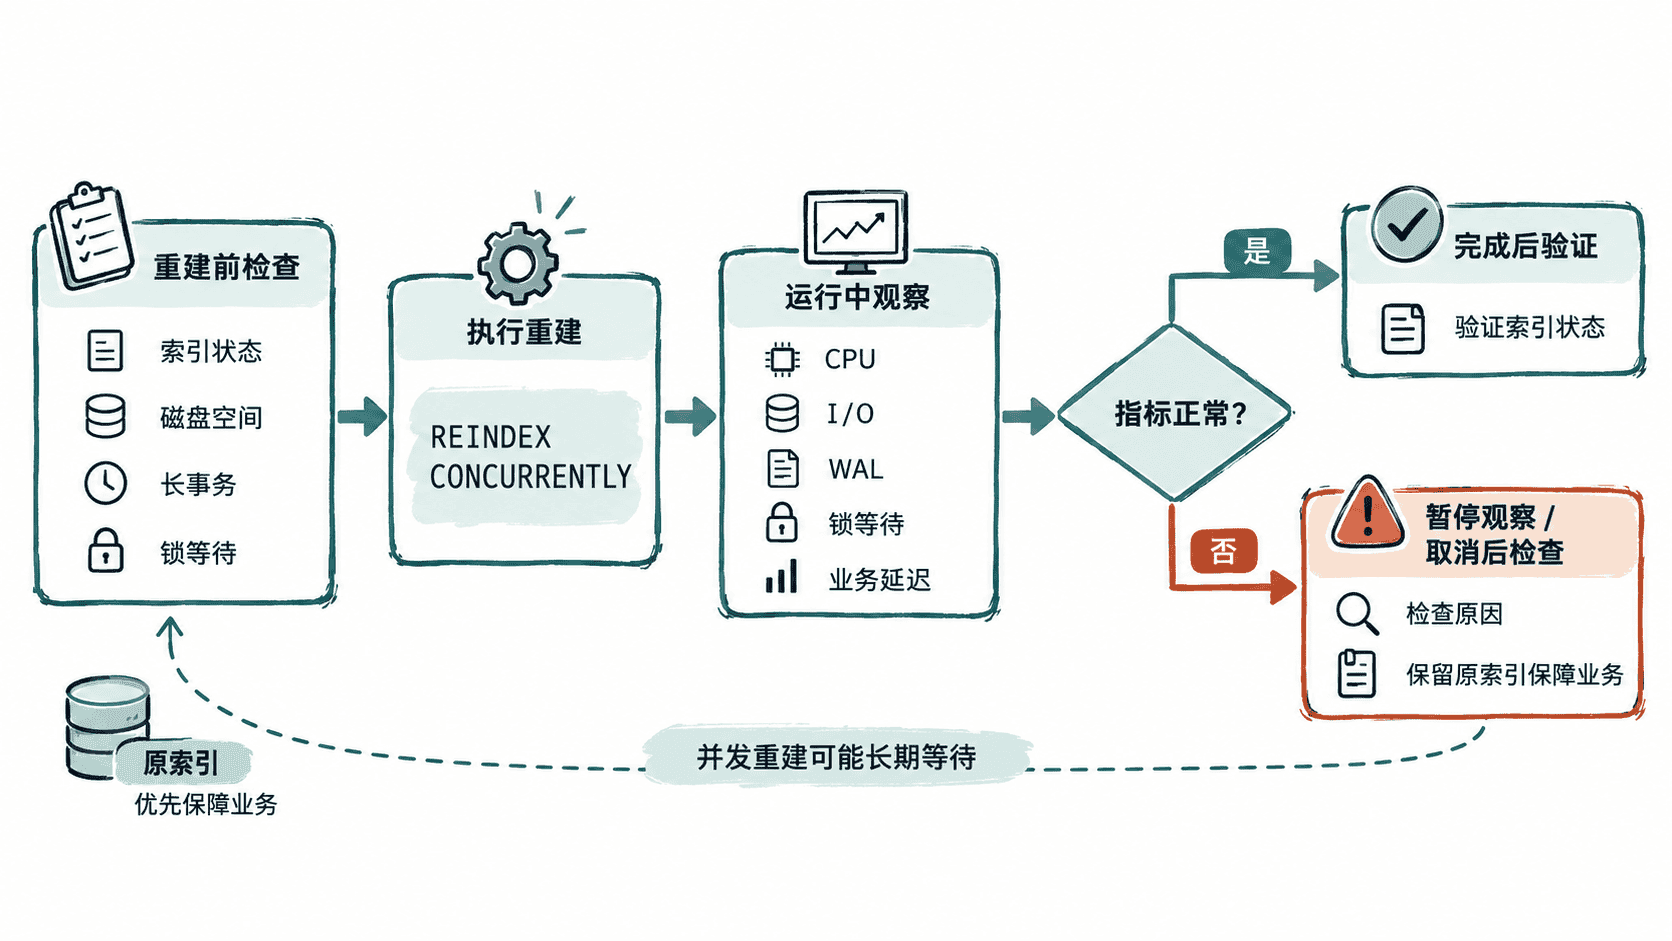
在线索引治理不是“加一个 CONCURRENTLY 就安全”。执行前至少要确认目标索引状态正常、数据库有足够的临时空间、没有持续的锁阻塞,并估算维护期间可能增加的 I/O 与 WAL 压力。
索引体量可以先从系统目录确认。下面的查询同时给出索引大小、是否有效,以及是否处于可用状态;其中 indisvalid=false 特别值得优先处理,因为它表示该索引不能作为正常查询路径使用。
SELECT
    c.oid::regclass AS index_name,
    pg_size_pretty(pg_relation_size(c.oid)) AS index_size,
    i.indisvalid,
    i.indisready
FROM pg_class AS c
JOIN pg_index AS i ON i.indexrelid = c.oid
WHERE c.relkind = 'i'
  AND c.oid::regclass::text = '<INDEX_NAME>';
预期结果
 index_name        | index_size | indisvalid | indisready
-------------------+------------+------------+------------
 <INDEX_NAME>      | <SIZE>     | t          | t
如果状态不是 indisvalid=true 且 indisready=true,不要直接把“重建成功”当成治理完成;先确认是不是已有失败的并发创建或重建留下了异常状态。
执行前检查锁与资源
并发重建仍然需要获得特定锁,并可能在切换阶段等待其他会话。因此,真正危险的往往不是重建命令本身,而是长事务、长查询或批量变更让重建长期卡在等待状态。
可以先检查当前数据库中是否存在明显的活跃阻塞链,同时观察正在进行的索引创建进度。
SELECT
    pid,
    usename,
    state,
    wait_event_type,
    wait_event,
    now() - xact_start AS transaction_age,
    query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;

SELECT
    pid,
    datname,
    relid::regclass AS table_name,
    index_relid::regclass AS index_name,
    phase,
    lockers_total,
    lockers_done,
    blocks_total,
    blocks_done,
    tuples_total,
    tuples_done
FROM pg_stat_progress_create_index;
预期结果
 pid  | datname   | table_name | index_name    | phase              | lockers_total | lockers_done
------+-----------+------------+---------------+--------------------+---------------+-------------
 <PID> | <DATABASE> | <TABLE>    | <INDEX_NAME>  | building index      | <N>           | <N>
没有正在执行的索引任务时,第二个查询可以返回 0 行;重建开始后再执行,它才会出现对应进度。实际阶段和计数会随版本及执行阶段变化,不应把某个固定阶段名当成验收条件。
在线重建与运行时观察
确认窗口和资源条件后,可优先采用并发重建。它的目标是尽量减少对正常读写的阻塞,但代价是维护时间更长、资源消耗更高,并且过程需要额外空间来构建新的索引版本。
REINDEX INDEX CONCURRENTLY <INDEX_NAME>;预期结果
REINDEX执行期间不要只看客户端是否返回成功,还应持续观察 CPU、磁盘 I/O、WAL 增长、锁等待,以及业务侧查询延迟。对于高峰期系统,真正的暂停条件应提前定义,例如锁等待持续超阈值、磁盘剩余空间快速下降或核心接口延迟显著升高。
失败时先保护业务状态
在线重建失败时,第一原则不是立刻再次执行同一条命令,而是确认原索引是否仍然可用,以及是否产生了无效索引对象。并发重建过程中可能留下无法正常参与规划的临时结果,需要单独识别。
下面的查询专门寻找无效索引:
SELECT
    c.oid::regclass AS index_name,
    i.indisvalid,
    i.indisready
FROM pg_class AS c
JOIN pg_index AS i ON i.indexrelid = c.oid
WHERE c.relkind = 'i'
  AND (NOT i.indisvalid OR NOT i.indisready);
预期结果
 index_name          | indisvalid | indisready
---------------------+------------+------------
 <FAILED_INDEX>      | f          | f
如果返回异常索引,不要仅凭名称判断它是不是刚刚失败留下的对象。先核对执行日志、创建时间和对应表,再决定是否删除。清理前必须确认另一个有效索引仍承担原有查询能力;不要为了“目录干净”而先删除唯一可用副本。
重建后的验证门禁
重建完成后至少验证三个层面。第一是索引本身仍然有效;第二是核心查询仍能获得合理的执行计划;第三是维护没有把系统资源推入危险区。
对关键查询应重复执行与变更前一致的 EXPLAIN 检查,而不是只确认命令返回 REINDEX。如果计划已经改变,需要继续判断是统计信息、数据分布还是索引定义变化造成的,而不能默认“新索引一定更好”。
最后确认索引大小与业务延迟是否回到预期范围。线上治理真正的完成标志不是“维护命令成功”,而是“对象状态正常、业务计划可接受、系统资源恢复稳定、失败残留已处置”。