
PostgreSQL / 系统课时
认识 PostgreSQL 索引结构
认识 PostgreSQL 索引结构
本课用 PostgreSQL 默认最常见的 B-tree 索引建立一个可操作的结构模型:索引页保存按键组织的索引项,索引项关联堆表中的 TID。理解这条关系后,才能进一步解释回表、索引大小和膨胀。
学习目标
- 区分索引页、键值、索引项、TID 与堆表元组
- 理解 B-tree 从根页到叶页定位键值的大致过程
- 能用系统目录确认一个索引属于哪张表并查看其物理大小
先限定到 B-tree
PostgreSQL 支持多种索引访问方法,例如 B-tree、Hash、GiST、SP-GiST、GIN 和 BRIN。它们的物理结构和适用场景并不相同,因此这里只讨论默认、通用性最强的 B-tree,不把下面的结构描述推广到所有索引类型。
B-tree 可以看成按索引键组织的多层页结构。查询从较高层页开始定位到合适的子页,最终到达叶页,在叶页中找到满足搜索条件的索引项。索引项不仅保存用于排序和定位的键,还关联能够定位堆表元组的 TID。
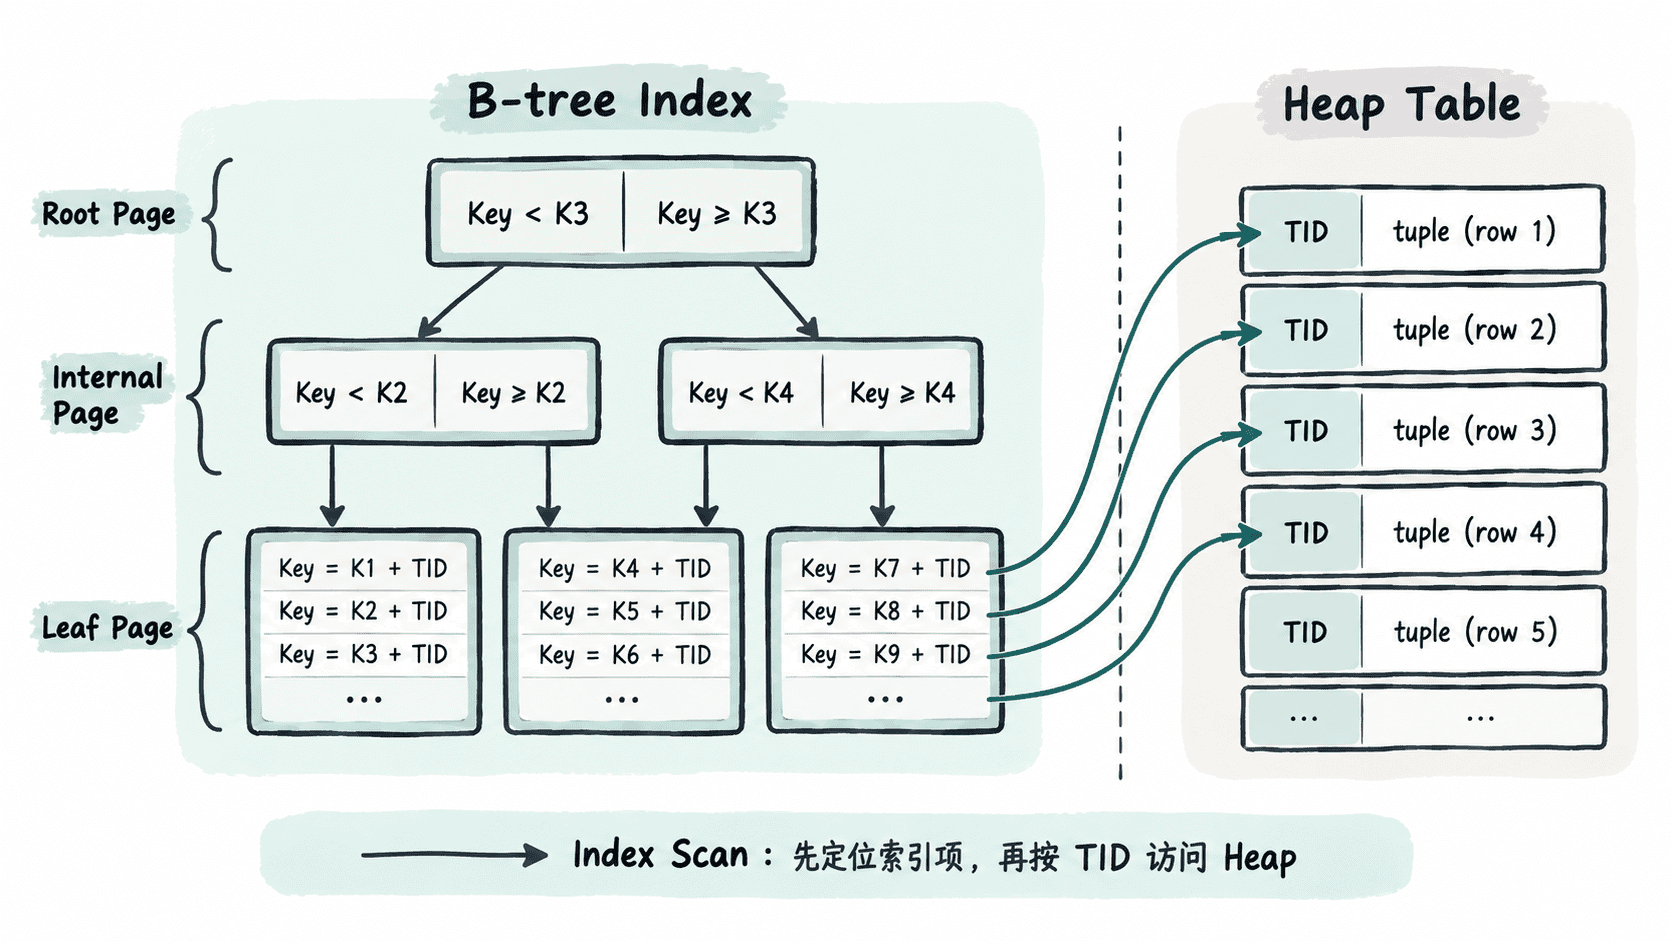
索引页、索引项与堆表是什么关系
索引页是索引关系的物理存储单位之一。B-tree 会把树结构拆分到多个页中,而查询沿树向下搜索时,本质上是在这些页中逐层缩小键值范围。
索引项是页中用于组织搜索的数据单元。对 B-tree 来说,核心信息可以理解为“键值用于排序和查找,TID 用于定位对应堆表元组”。这里的 TID 是 PostgreSQL 内部定位堆表行版本的位置标识,而不是业务主键。
因此,主键值和 TID 不能混为一谈。一个索引可以按 email 建立,业务主键却可能是 id;此时索引项的搜索键是 email,而找到候选项后仍需要通过 TID 找到实际堆表元组。
用系统目录观察索引
可以先创建一个最小表和 B-tree 索引,再通过 pg_index 与 pg_class 查询索引和堆表之间的关系。这个示例不依赖特定业务数据。
CREATE TABLE customer_demo (
    id bigint PRIMARY KEY,
    email text NOT NULL
);

CREATE INDEX idx_customer_demo_email
ON customer_demo (email);

SELECT
    index_class.relname AS index_name,
    table_class.relname AS table_name,
    pg_size_pretty(pg_relation_size(index_class.oid)) AS index_size
FROM pg_index AS i
JOIN pg_class AS index_class
  ON index_class.oid = i.indexrelid
JOIN pg_class AS table_class
  ON table_class.oid = i.indrelid
WHERE index_class.relname = 'idx_customer_demo_email';
预期结果应返回刚创建的索引名称、所属堆表名称以及索引当前占用的关系大小。具体大小会受到 PostgreSQL 版本、页大小以及当前数据量影响;由于表此时没有业务数据,结果通常仍是一个很小的索引关系。
      index_name       |   table_name   | index_size
-----------------------+----------------+------------
 idx_customer_demo_email | customer_demo | <small size>
<small size> 表示实际服务器上的格式化大小,不应把它理解成固定字节数。
从一次索引扫描理解回表
当查询只使用 email 条件,却还需要返回未存放在该索引项中的列时,典型的 Index Scan 流程是:先在 B-tree 叶页找到匹配键,再取得对应 TID,随后访问堆表元组获取完整行。
这就是常说的回表。回表次数与匹配行数、数据物理分布和可见性检查等因素共同影响成本。也正因为索引不仅有“能不能找到”的问题,还有“找到后要付多少堆访问成本”的问题,后续做索引设计时不能只关注单列是否建过索引。
理解到这里,后面的索引选择与膨胀治理就有了统一基础:索引是独立的物理关系,拥有自己的页和存储空间;它通过键值组织搜索,并通过 TID 与堆表元组建立定位关系。