
PostgreSQL / 系统课时
对比优化前后执行计划
对比优化前后执行计划
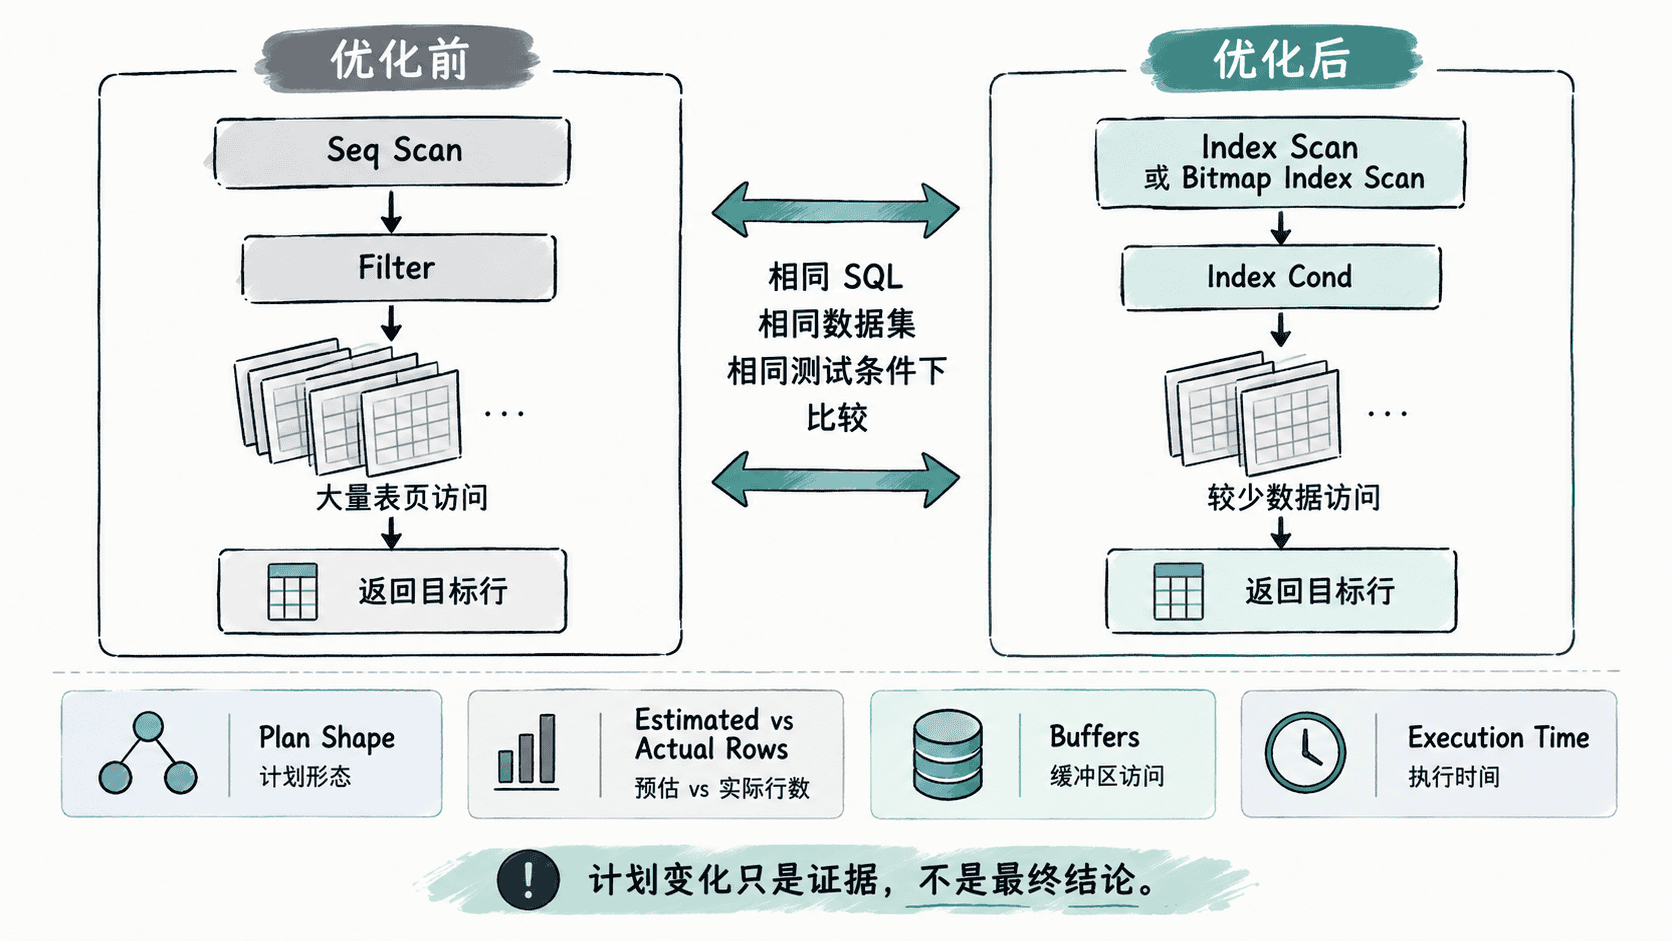
索引优化不能只看“从 Seq Scan 变成了 Index Scan”。真正可验收的结果是:相同数据、相同查询条件下,计划是否改善,估算与实际是否更接近,扫描与缓冲区访问是否减少,以及真实执行时间是否稳定下降。本课用一次可重复实验建立这个比较方法。
学习目标
- 能在相同数据和查询下采集优化前后的执行计划
- 能比较计划节点、估算行数、实际行数、Buffers 与执行时间
- 能识别“计划看起来更高级但实际没有收益”的假优化
固定实验条件
执行计划比较必须先控制变量。最少保持数据集、SQL、参数、会话环境和测试方式一致。测试前应执行 ANALYZE,否则优化前后的统计信息状态不同,计划变化可能来自统计刷新,而不是索引本身。PostgreSQL 官方文档也提醒,ANALYZE 生成的统计信息是近似值,重新分析后成本和估算可能出现小幅变化。:contentReference[oaicite:7]{index=7}
下面使用同一张表先测试无索引状态,再创建索引并重复完全相同的查询。数据量、过滤条件和返回列均保持不变。
DROP TABLE IF EXISTS customer_events_plan_demo;

CREATE TABLE customer_events_plan_demo (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id bigint NOT NULL,
    event_type text NOT NULL,
    created_at timestamptz NOT NULL,
    payload text NOT NULL
);

INSERT INTO customer_events_plan_demo (customer_id, event_type, created_at, payload)
SELECT
    1 + (g % 20000),
    CASE WHEN g % 20 = 0 THEN 'login' ELSE 'view' END,
    now() - (g || ' seconds')::interval,
    repeat('x', 40)
FROM generate_series(1, 200000) AS g;

ANALYZE customer_events_plan_demo;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, customer_id, created_at
FROM customer_events_plan_demo
WHERE customer_id = 10001;

CREATE INDEX idx_customer_events_plan_demo_customer_id
    ON customer_events_plan_demo (customer_id);

ANALYZE customer_events_plan_demo;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, customer_id, created_at
FROM customer_events_plan_demo
WHERE customer_id = 10001;
预期结果
优化前:计划通常以 Seq Scan 为主,节点中出现 Filter,并扫描较多表数据。

优化后:计划通常改为 Index Scan 或 Bitmap Heap Scan + Bitmap Index Scan,
        并出现与 customer_id 条件对应的 Index Cond;实际扫描的数据范围通常更小。
不要把上面的 Index Scan 文字当成硬编码答案。具体访问方法取决于表大小、数据分布、缓存和 PostgreSQL 版本;EXPLAIN 本身就是用来展示规划器对当前环境生成的实际计划。:contentReference[oaicite:8]{index=8}
按四层证据比较
第一层看计划结构。重点确认过滤条件是否进入 Index Cond,还是仅出现在 Filter。Index Cond 表示扫描索引时用于定位候选项的条件,而单纯的 Filter 说明记录已经被上层节点取出后才进行过滤。相比只看“有无索引节点”,这个区别更能解释索引为什么真正带来了收益。
第二层看估算与实际。EXPLAIN ANALYZE 会把执行统计附加到计划节点上,可以比较估算行数与实际行数;若优化后 rows 估算明显接近实际,说明统计信息和选择率模型也更可信。反之,如果估算仍偏离几个数量级,即使当前查询变快,也不应把问题标记为彻底解决。:contentReference[oaicite:9]{index=9}
第三层看Buffers。对于相同查询,比较共享缓冲区命中、读取和写入等统计,比单独比较一次耗时更有解释力。缓存状态变化会影响时间,但访问页面数量的变化通常更能说明索引是否减少了不必要的数据访问。
第四层看Execution Time。真实耗时是最终业务指标,但单次执行容易受到缓存、后台负载、并发和系统抖动影响。因此应至少重复运行多次,再看中位数或稳定区间,而不是拿一次最快成绩作为验收依据。EXPLAIN ANALYZE 自身也会增加测量开销,所以其耗时不能机械等同于应用真实耗时。:contentReference[oaicite:10]{index=10}
用固定查询形成验收记录
线上索引变更最好把执行计划保存成可审计的前后证据,而不是只截一张客户端截图。对于需要自动比较的流程,可以使用机器可读格式,例如 FORMAT JSON;官方文档说明,JSON、XML 和 YAML 等格式更适合交给程序进一步分析。:contentReference[oaicite:11]{index=11}
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT id, customer_id, created_at
FROM customer_events_plan_demo
WHERE customer_id = 10001;
预期结果
[
  {
    "Plan": {
      "Node Type": "...",
      "Plans": []
    },
    "Execution Time": 0
  }
]
这里的字段值会随运行环境变化,重点是可以稳定取得计划树以及执行统计。自动验收时应重点抽取节点类型、估算行数、实际行数、Buffers 和执行时间,而不是比较整段文本是否逐字符一致。
识别看似优化、实际没有收益的结果
最典型的假优化是“计划从 Seq Scan 变成 Index Scan,但业务查询没有变快”。这通常说明查询返回的数据量仍然较大,或者索引扫描带来的随机访问成本抵消了定位收益。另一个常见情况是只改变了计划形态,却没有降低 Buffers 和实际工作量。
还要警惕只看成本值的误判。cost=... 是优化器内部的相对成本单位,核心用途是比较候选计划,而不是直接代表毫秒。一个新计划的成本更低只是说明优化器认为它更便宜,是否值得上线仍需结合实际执行统计和业务指标判断。:contentReference[oaicite:12]{index=12}
最终验收建议形成最小证据集:同一 SQL、同一数据快照、优化前计划、优化后计划、估算与实际行数、Buffers、重复测试后的耗时区间。只有这些证据同时支持收益时,索引变更才算完成;单纯看到计划里出现 Index Scan,不足以证明优化有效。