
PostgreSQL / 系统课时
制定自动维护策略
制定自动维护策略
本课把一次性的索引治理变成长期运行的维护策略:不按固定日期机械重建,而是根据写入模式、索引增长、实际访问和业务窗口决定何时观察、何时告警、何时执行维护,并为高风险操作设置明确门禁。
学习目标
- 能按表和索引的实际变化制定维护周期,而不是只按日历触发
- 能组合增长、使用和运行状态信号设计告警阈值
- 能建立自动发现、人工审批和自动执行之间的操作边界
不要把维护周期写死成“每周重建”
PostgreSQL 的日常自动维护主要依靠 autovacuum 与 ANALYZE;索引重建不是应该无差别、固定周期执行的普通保洁动作。自动维护策略应优先识别“增长快、持续被使用、已经出现治理信号”的索引,再决定是否进入评估或重建队列。官方文档也将 routine reindexing 作为需要根据实际维护需求设置的独立任务,而不是简单等同于 autovacuum。:contentReference[oaicite:5]{index=5}
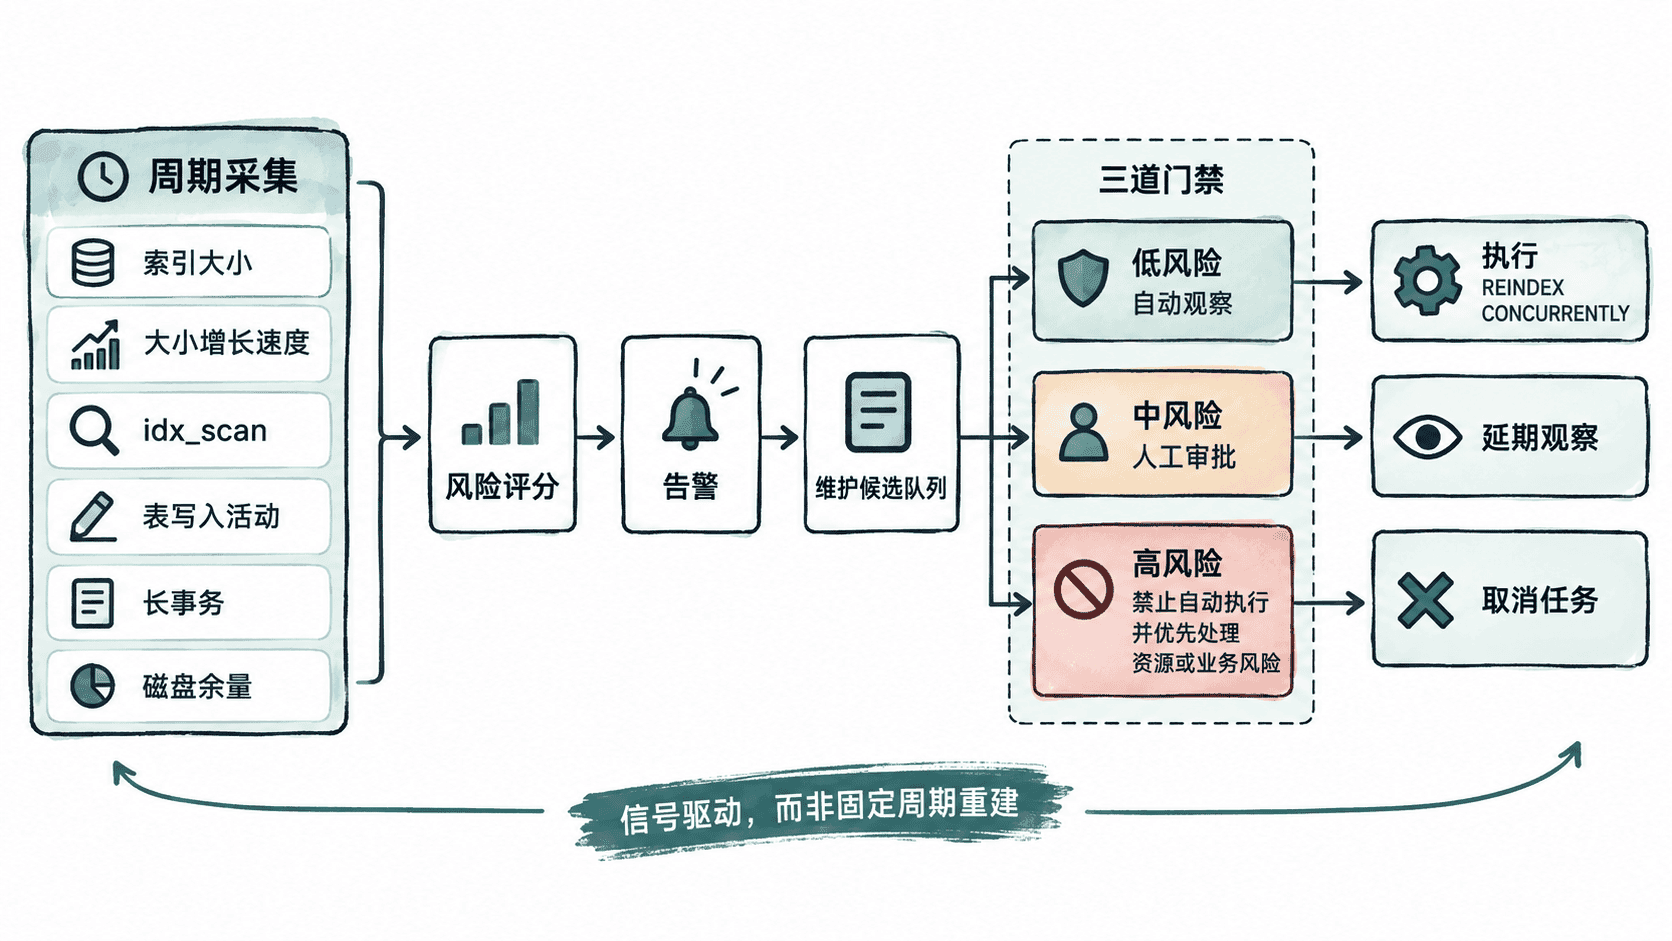
一个实用策略可以分成三层:日常采集指标,异常进入告警,只有满足执行门禁的对象才进入重建队列。这样既能避免漏掉持续增长的索引,也能避免因为一次短期增长就频繁重建。
建立可持续的监测信号
监测时不要只看“索引有多大”。大索引本身未必有问题,更有价值的是观察它是否持续增长、是否承担重要查询、是否与高写入表关联,以及当前数据库有没有足够的资源承受重建。
可以先建立一个低成本采集查询,把体积和访问次数作为长期趋势数据。pg_stat_user_indexes 会提供用户表索引的访问统计。:contentReference[oaicite:6]{index=6}
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    pg_relation_size(indexrelid) AS index_bytes,
    idx_scan,
    idx_tup_read,
    idx_tup_fetch
FROM pg_stat_user_indexes
WHERE schemaname NOT IN ('pg_catalog', 'information_schema')
ORDER BY pg_relation_size(indexrelid) DESC
LIMIT 20;
预期结果
 schemaname | table_name |       index_name        | index_bytes | idx_scan | idx_tup_read | idx_tup_fetch
------------+------------+------------------------+-------------+----------+--------------+---------------
 public     | orders     | idx_orders_customer_id  | 12884901888 | 1845321  | 49218321     | 48390211
这类采集结果适合保存成时间序列。真正的治理信号通常来自趋势,而不是某一天的孤立数字,例如连续多个采集周期快速增长、关键索引增长明显快于同表其他索引,或者索引已经很大且重建窗口越来越难安排。
把阈值设计成“分层动作”
不要设置一个阈值,一超过就自动 REINDEX。更稳妥的做法是把阈值和动作绑定:达到观察阈值只记录趋势;达到告警阈值进入人工评估;只有同时满足资源、窗口和业务风险门禁时才执行重建。
例如,可以把策略定义成下面这种规则:
| 信号 | 观察动作 | 升级动作 |
|---|---|---|
| 索引大小持续增长 | 保留历史趋势 | 进入候选队列 |
| 索引增长明显快于基线 | 提高采样频率 | 触发告警 |
| 业务关键索引且增长持续 | 标记高优先级 | 安排维护窗口 |
| 磁盘余量不足 | 暂停自动任务 | 禁止重建 |
| 存在长事务或冲突 DDL | 延后执行 | 人工处理 |
阈值不应该脱离环境照搬,例如直接规定“超过 10 GB 就重建”。不同业务的表大小、I/O 能力、写入模式和可接受维护窗口都不同。更可靠的阈值通常是相对增长、持续时间与业务重要性的组合。
设计自动执行的安全边界
自动化最容易出问题的地方不是“发现候选对象”,而是“自动执行高成本动作”。建议让自动任务只负责采集、计算和入队;真正执行前再检查数据库版本、索引对象、磁盘余量、活跃长事务、并发 DDL 和业务窗口。
自动任务至少需要具备三种结果:执行、延期、禁止。延期表示条件暂时不满足,下一周期重新评估;禁止表示已经出现明确风险,例如资源不足,此时不能靠不断重试来解决问题。
一个简单的执行前检查可以写成片段示例,用于任务脚本或运维程序的上下文中:
SELECT
    current_database() AS database_name,
    pg_size_pretty(pg_database_size(current_database())) AS database_size,
    count(*) FILTER (WHERE state = 'active') AS active_sessions,
    count(*) FILTER (WHERE state = 'active' AND now() - xact_start > interval '15 minutes') AS long_transactions
FROM pg_stat_activity;
预期结果
 database_name | database_size | active_sessions | long_transactions
---------------+---------------+-----------------+------------------
 appdb         | 620 GB        |              47 |                 2
这条查询只提供门禁所需的基础信号,不代表可以仅凭这些字段决定执行。生产系统还应结合磁盘可用空间、当前 I/O、是否存在冲突 DDL 和业务窗口做最终判断。
形成周期与回顾机制
维护周期可以按“采集频率”和“执行频率”分开设计。指标采集应足够高频,以便看到增长趋势;重建则应低频、按风险触发,并在每次执行后记录持续时间、资源消耗、是否发生等待以及重建后的对象大小。
这样形成的闭环是:持续采集 → 发现增长 → 风险分级 → 告警或入队 → 门禁检查 → 执行并发重建 → 验证结果 → 回写基线。维护策略成熟后,重点就不再是“多久重建一次”,而是“什么信号说明值得重建、当前条件是否允许重建”。