
PostgreSQL / 系统课时
处理索引未命中的情况
处理索引未命中的情况
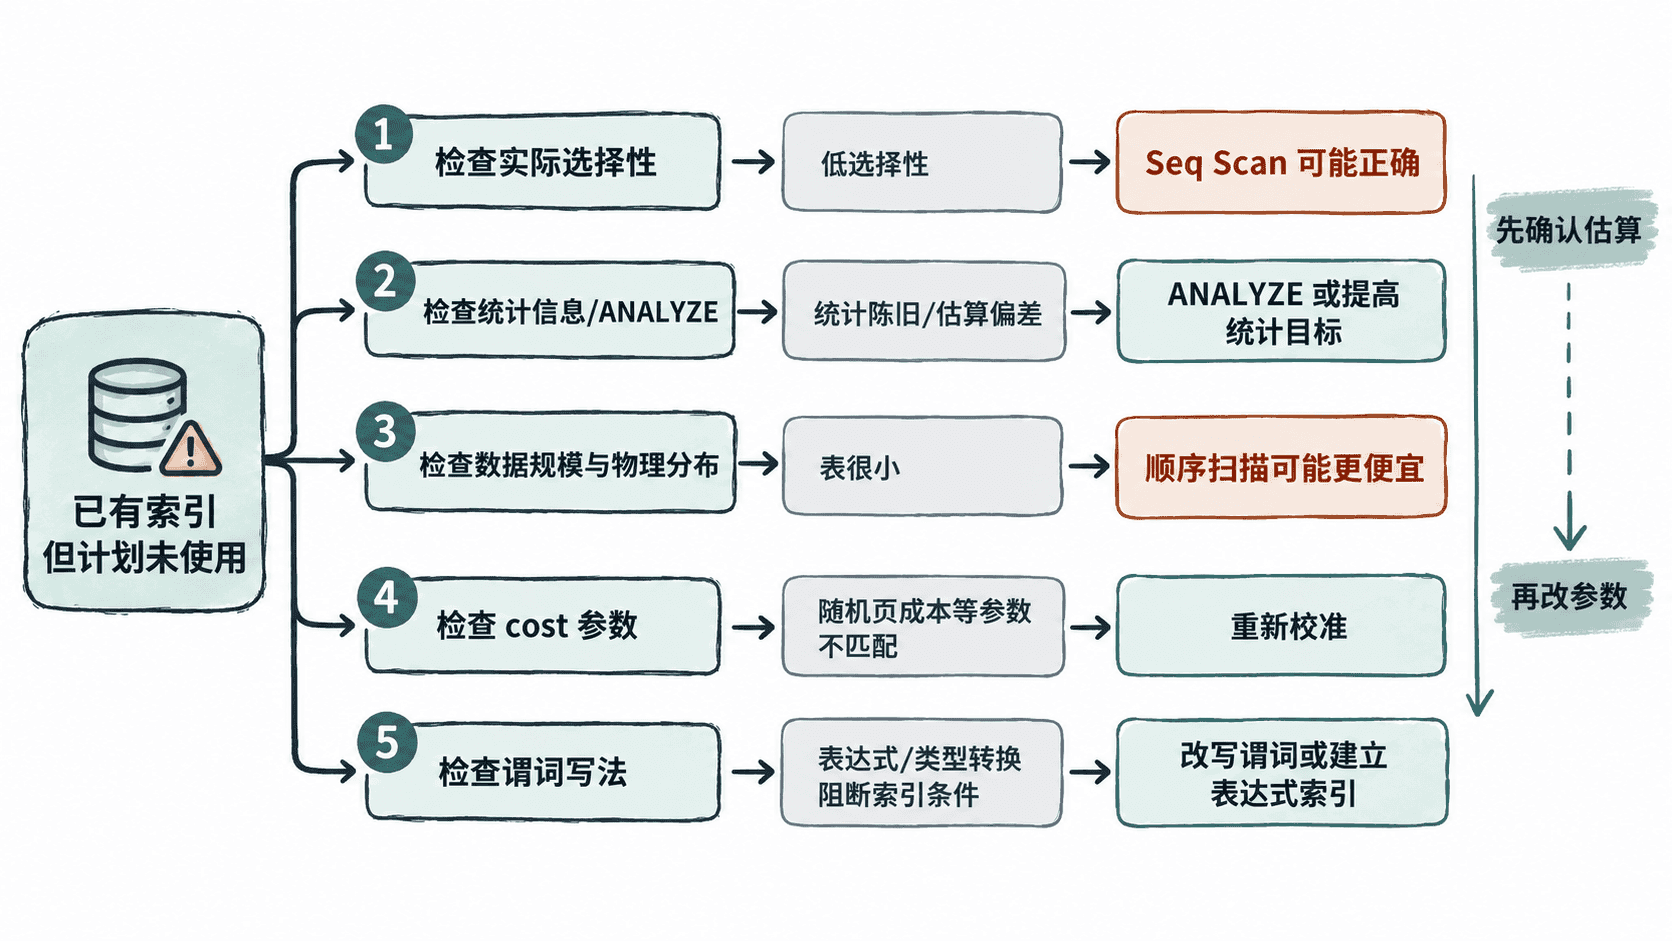
索引已经创建却没有出现在执行计划里,并不等于 PostgreSQL 忽略了索引。应先确认选择性、统计信息、数据规模、代价模型和谓词写法,再判断是计划正确还是信息失真。本课给出一套可重复的定位顺序。
学习目标
- 能从执行计划判断优化器为什么更偏向顺序扫描
- 能使用
ANALYZE、pg_stats和扩展统计定位基数估算问题 - 能区分真实的低收益索引与代价参数、谓词写法造成的误判
先确认“没用索引”到底是什么意思
先不要通过 enable_seqscan 之类的开关强行制造索引计划。优化器选择的是估算总成本更低的方案,而不是“有索引就优先用索引”。当条件命中表中很大比例的行时,顺序扫描可能本来就是更合理的方案;反过来,若实际只返回很少的行,却估算成大量行,就应继续追查统计信息或谓词。
用下面的实验建立一个典型的低选择性场景。status='paid' 占绝大多数,因此即使存在索引,顺序读取整张表也可能更便宜。
DROP TABLE IF EXISTS orders_index_demo;

CREATE TABLE orders_index_demo (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    status text NOT NULL,
    customer_id bigint NOT NULL,
    created_at timestamptz NOT NULL
);

INSERT INTO orders_index_demo (status, customer_id, created_at)
SELECT
    CASE WHEN g <= 190000 THEN 'paid' ELSE 'pending' END,
    100000 + (g % 1000),
    now() - (g || ' minutes')::interval
FROM generate_series(1, 200000) AS g;

CREATE INDEX idx_orders_index_demo_status
    ON orders_index_demo (status);

ANALYZE orders_index_demo;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, customer_id, created_at
FROM orders_index_demo
WHERE status = 'paid';
预期结果
QUERY PLAN
Seq Scan on orders_index_demo
  Filter: (status = 'paid'::text)
  Rows Removed by Filter: ...
Planning Time: ... ms
Execution Time: ... ms
具体行数、成本、耗时和扫描缓冲区会随 PostgreSQL 版本、机器和缓存状态变化;关键观察点是该查询是否采用 Seq Scan,以及实际返回行数是否占表中大部分。EXPLAIN 的 cost 是优化器用于比较方案的抽象成本,并不等同于真实毫秒数。:contentReference[oaicite:0]{index=0}
检查选择性与实际行数
第一层检查是“这个条件到底有多挑剔”。如果一个谓词会返回表中很大比例的记录,索引扫描需要先访问索引,再访问大量表数据;当这些访问无法显著减少工作量时,顺序扫描完全可能胜出。不要把“索引没出现”直接判定为优化器错误。
更有价值的是比较估算行数和实际行数。若 EXPLAIN (ANALYZE) 显示 rows= 的估算值与实际输出差异很大,后续应优先调查统计信息,而不是先调整索引定义。EXPLAIN 中的 rows 是节点预计输出的行数,不是该节点扫描过的总行数。:contentReference[oaicite:1]{index=1}
检查统计信息是否可信
PostgreSQL 使用 pg_statistic 保存选择率估算所需的信息,人工排查时通常查看更易读的 pg_stats。这些统计由 ANALYZE 更新,而且本质上是近似值;大表使用采样,因此数据发生明显变化后,旧统计信息可能使优化器产生错误的基数估算。:contentReference[oaicite:2]{index=2}
先重新采样,再观察目标列的统计特征:
ANALYZE orders_index_demo;

SELECT
    schemaname,
    tablename,
    attname,
    n_distinct,
    most_common_vals,
    histogram_bounds
FROM pg_stats
WHERE tablename = 'orders_index_demo'
  AND attname = 'status';
预期结果
 schemaname | tablename           | attname | n_distinct | most_common_vals | histogram_bounds
------------+---------------------+---------+------------+------------------+------------------
 ...        | orders_index_demo   | status  | ...        | {paid,pending}   | ...
这里重点不是某个固定数字,而是确认统计信息已经存在并能反映 status 的倾斜分布。若列分布高度不均、估算仍不稳定,可以只提高关键列的统计目标,而不是盲目提高整个数据库的默认值。PostgreSQL 18 中默认 default_statistics_target 为 100,列级 ALTER TABLE ... SET STATISTICS 可以做更精细的调整。:contentReference[oaicite:3]{index=3}
ALTER TABLE orders_index_demo
ALTER COLUMN status SET STATISTICS 500;

ANALYZE orders_index_demo;
预期结果
ALTER TABLE
ANALYZE
提高统计目标的代价是 ANALYZE 需要处理更多统计信息,规划与存储开销也会增加,因此应针对真正造成误判的列使用,而不是把数值统一调到很高。:contentReference[oaicite:4]{index=4}
检查多列相关性与谓词写法
单列统计无法完整表达多个列之间的相关性。例如查询同时约束 country 和 city,但两者并非独立分布时,优化器可能把两个选择率简单组合,最终低估或高估结果集规模。对于这类情况,可以使用 CREATE STATISTICS 建立多变量统计信息,再执行 ANALYZE。:contentReference[oaicite:5]{index=5}
另一类常见原因是谓词写法改变了索引可利用的条件。例如普通索引建在 email 上,却写成对列做函数运算的条件;此时要检查计划中的 Index Cond 与 Filter,确认真正用于定位索引项的部分是什么。必要时应考虑改写谓词,或者建立与表达式匹配的表达式索引,而不是机械增加普通索引。
最后才检查代价参数
如果统计信息准确、选择性合理、谓词也能形成有效的索引条件,但计划仍长期明显偏向不合理方案,再检查 random_page_cost、seq_page_cost 等代价参数。它们描述的是优化器的成本模型,而不是“索引一定应该更快”的开关。
特别不要把 SET enable_seqscan = off 当生产修复。这个设置适合做诊断实验:它可以帮助你观察“如果不用顺序扫描,优化器会选择什么”,但 PostgreSQL 官方文档明确把这类 enable/disable 开关定位为粗粒度的诊断手段。:contentReference[oaicite:6]{index=6}
因此,处理索引未命中时应遵循“先验证实际行数与估算是否一致,再判断选择性和数据规模;确认统计信息后再看谓词,最后才校准成本模型”的顺序。很多所谓的“索引失效”,最后并不是缺索引,而是优化器有充分理由认为它不划算,或者掌握了过时、失真的数据分布信息。