
PostgreSQL / 系统课时
设计组合索引顺序
设计组合索引顺序
组合索引不是把常用列简单拼在一起,而是要让最常见的查询尽可能沿着索引的有序结构完成筛选、定位和排序。本课用一个订单查询场景说明等值、范围、排序和连接条件如何共同决定多列索引顺序。
学习目标
- 能根据查询条件判断组合索引的候选列顺序。
- 能解释等值列、范围列和排序列改变顺序后为什么访问路径会不同。
- 能用
EXPLAIN验证索引是否真正服务于目标查询。
先确定查询最需要索引解决什么
以订单表为例,常见查询可能同时出现租户过滤、状态过滤、时间范围和排序。设计时不要先问“哪一列选择性最高”,而应先观察查询在索引中的访问形态:先做连续的等值定位,再处理范围扫描,最后尽量让索引顺序与排序方向一致。
CREATE TABLE orders (
    id bigint PRIMARY KEY,
    tenant_id bigint NOT NULL,
    status text NOT NULL,
    created_at timestamptz NOT NULL,
    customer_id bigint NOT NULL,
    total_amount numeric(12, 2) NOT NULL
);

CREATE INDEX idx_orders_tenant_status_created
    ON orders (tenant_id, status, created_at DESC);

EXPLAIN (COSTS OFF)
SELECT id, customer_id, total_amount
FROM orders
WHERE tenant_id = 42
  AND status = 'PAID'
  AND created_at >= timestamptz '2026-01-01'
ORDER BY created_at DESC
LIMIT 20;
预期结果
Limit
  -> Index Scan using idx_orders_tenant_status_created on orders
       Index Cond: ((tenant_id = 42) AND (status = 'PAID') AND (created_at >= '2026-01-01 00:00:00+00'::timestamp with time zone))
具体计划文字可能因 PostgreSQL 版本、统计信息和数据分布不同而变化,但应能看到该组合索引参与访问;若实际数据很少,优化器也可能选择其他路径。
为什么顺序通常先等值、后范围
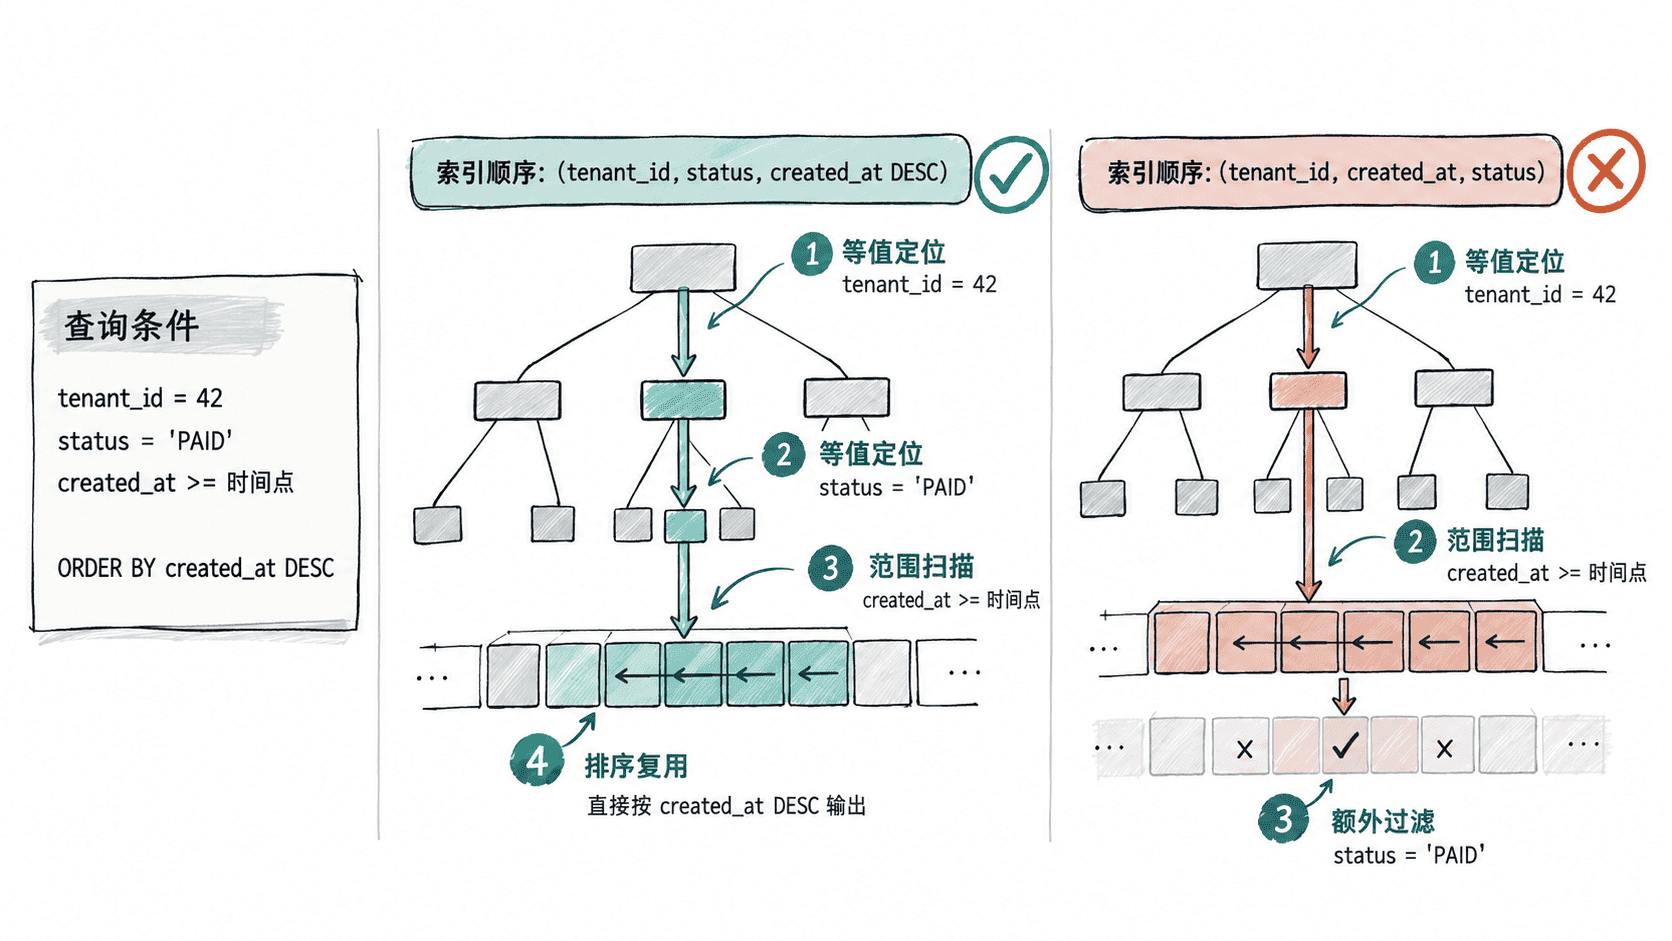
组合 B-tree 索引会按列顺序形成有序键空间。tenant_id = 42 和 status = 'PAID' 都能把搜索空间压缩成较小的连续区域,随后 created_at >= ... 在这个区域内继续做范围扫描。因此 (tenant_id, status, created_at) 很适合这类查询。
一旦把范围列提前,例如 (tenant_id, created_at, status),查询仍可能使用索引,但 status = 'PAID' 很难继续作为同一层级的有效索引边界;执行器可能需要在 created_at 范围内过滤状态。也就是说,“索引可用”不等于“索引把所有条件都高效地变成索引定位”。
还要注意,经验法则不是绝对规则。若实际工作负载大量只按 tenant_id + created_at 查询,或者排序需求决定了另一种顺序,那么应以真实查询集合和 EXPLAIN (ANALYZE, BUFFERS) 验证,而不是机械套公式。
排序与连接条件怎么纳入设计
排序不是额外的小优化。在查询结果主要按 created_at DESC 返回时,把 created_at 放在合适位置并使用相同方向,可能让执行器直接按索引顺序取结果,减少独立排序的需要。
连接条件也要从查询集合看。例如订单经常通过 customer_id 连接客户表,并且查询本身以 tenant_id 为固定过滤条件,那么 (tenant_id, customer_id) 可能比单独的 customer_id 更贴合业务访问路径。但不能因为“连接列重要”就固定把它放在第一位;没有租户条件的查询若很多,反而可能需要另一条索引。
设计组合索引时,可以把候选方案写成查询驱动的对照:
| 查询模式 | 常见候选顺序 | 主要收益 |
|---|---|---|
| 租户 + 状态 + 时间范围 | tenant_id, status, created_at |
等值定位后缩小时间范围 |
| 租户 + 时间范围 | tenant_id, created_at |
直接进入时间窗口 |
| 租户 + 客户连接 | tenant_id, customer_id |
先限制业务域,再定位连接键 |
| 时间倒序分页 | tenant_id, created_at DESC |
兼顾过滤和索引顺序 |
用执行计划而不是列偏好做最终判断
最终方案应来自真实 SQL、数据分布和执行计划。重点观察 Index Cond 是否包含关键索引边界,Filter 是否承担了大量本应由索引缩小的工作,以及是否出现明显的排序或大量扫描行。
对于高频查询,最好同时比较候选索引在代表性数据量下的执行时间、Buffers 和扫描行数。一个在小表上看起来优秀的索引,数据规模扩大后可能因为分布变化而失去优势。
组合索引顺序的核心不是追求“选择性最高的列放第一”,而是匹配实际查询如何连续缩小有序搜索空间。先从查询模式确定候选顺序,再用执行计划验证,才能避免“看起来能用、实际上扫很多”的索引。