
PostgreSQL / 系统课时
排查索引导致的慢查询
排查索引导致的慢查询
本课解决“明明有索引,查询却仍然很慢”的排查问题。你将从慢查询开始,依次核对执行计划、实际索引访问、过滤效率与统计信息,最后判断瓶颈究竟来自索引、估算误差还是其他算子。
学习目标
- 能从
EXPLAIN (ANALYZE, BUFFERS)判断查询是否真正使用了预期索引。 - 能用选择性、估算行数与实际行数识别错误索引或过期统计信息。
- 能区分索引问题与排序、回表、过滤、I/O 等非索引瓶颈。
先确认慢在哪里
不要看到慢查询就直接 CREATE INDEX。第一步应记录 SQL、参数范围、返回行数和执行时间,再用真实参数执行计划。排查的核心是回答三个问题:优化器选了什么、实际扫描了多少、时间耗在哪里。
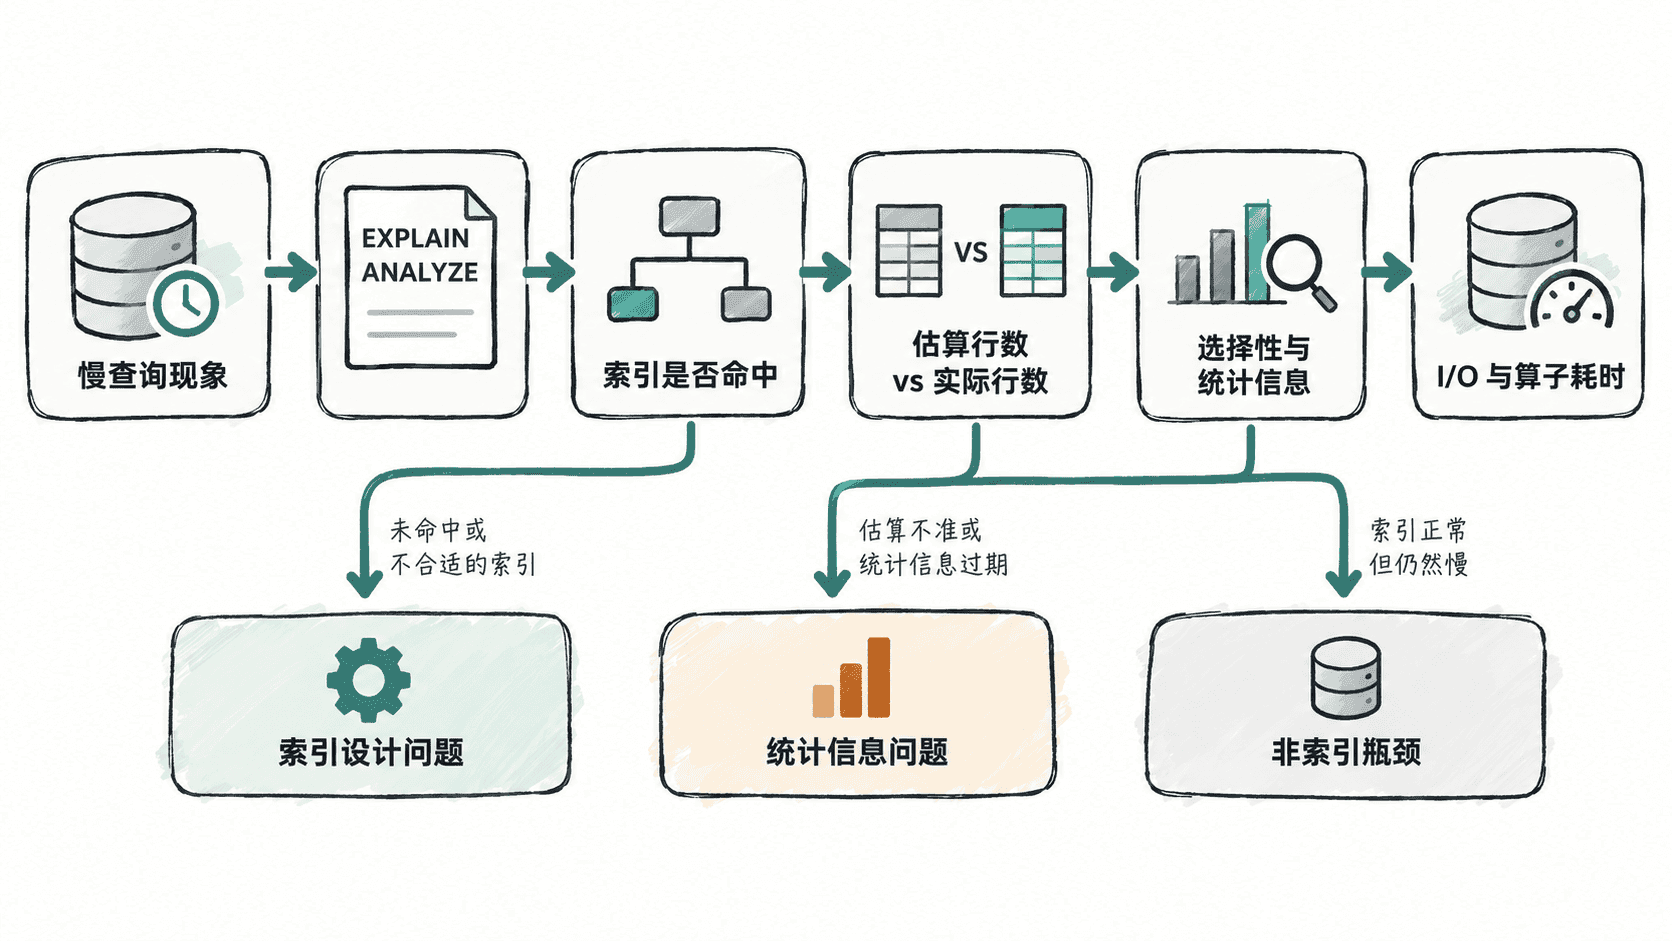
用实际执行计划定位索引访问
先不要只看 EXPLAIN 的预估成本,排查线上问题更适合加入 ANALYZE 和 BUFFERS,让计划展示实际行数与缓冲区访问。下面示例假设存在按状态筛选并按创建时间排序的订单表。
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, customer_id, created_at
FROM orders
WHERE status = 'PAID'
ORDER BY created_at DESC
LIMIT 50;
预期结果
Limit
  ->  Index Scan using orders_status_created_at_idx on orders
       Index Cond: (status = 'PAID'::text)
       Buffers: shared hit=<VALUE>
Execution Time: <VALUE> ms
关注 Index Scan、Bitmap Index Scan 和 Seq Scan 的差异。出现 Seq Scan 并不自动等于错误:当过滤条件返回大量数据时,顺序扫描可能比随机访问索引再取表页更便宜。真正需要警惕的是计划估算与实际执行严重不一致,或者索引扫描后仍过滤掉大量行。
判断选择性和估算误差
选择性可以粗略理解为“条件能缩小多少候选行”。例如一个只有两个值的布尔列,单独建立索引通常选择性较差;而高基数字段的等值条件往往更容易产生高选择性。最终仍要以数据分布和实际计划为准。
重点观察计划节点中的 rows= 与 actual rows=。如果优化器预计返回 10 行,实际却返回 100000 行,说明基数估算可能明显失真,这时继续加索引可能治错方向。可以先检查统计信息是否合理,并确认数据分布是否发生了突变。
检查统计信息
PostgreSQL 的优化器依赖列统计信息决定索引与其他访问路径。表数据大量变化后,统计信息若没有及时更新,可能造成错误估算。排查时可以先手工分析,再重新观察计划。
ANALYZE orders;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, customer_id, created_at
FROM orders
WHERE status = 'PAID'
ORDER BY created_at DESC
LIMIT 50;
预期结果
ANALYZE
Limit
  ->  Index Scan using orders_status_created_at_idx on orders
Planning Time: <VALUE> ms
Execution Time: <VALUE> ms
如果重新 ANALYZE 后计划或估算显著改善,根因更可能是统计信息问题,而不是索引缺失。生产环境还应结合自动 ANALYZE、数据变更频率以及异常列分布判断是否需要提高统计目标。
区分索引瓶颈与其他瓶颈
即使查询命中了索引,也可能因为回表次数很多、排序代价高、缓存命中低或返回数据量过大而变慢。看到 Index Scan 只能说明访问路径使用了索引,不能证明“索引已经优化完成”。
实战中优先比较 actual rows、Buffers、节点耗时和过滤比例。若索引扫描读取了大量页面但最终只返回很少结果,应继续检查索引列顺序与谓词;若索引访问本身很快而排序或聚合占据主要时间,就不要把治理目标错误地锁定在索引上。