
PostgreSQL / 系统课时
理解查询与索引访问链路
理解查询与索引访问链路
本课解决一个常见误区:SQL 写出来并不等于数据库已经决定如何读取数据。你将把解析、优化、索引访问、堆表读取和结果返回串成一条链,明确索引真正影响的是哪一段。
学习目标
- 说清 PostgreSQL 从 SQL 到结果返回的主要执行阶段
- 理解优化器如何把索引作为候选访问路径,而不是强制规则
- 能用
EXPLAIN判断查询是否实际采用索引
从 SQL 到执行计划
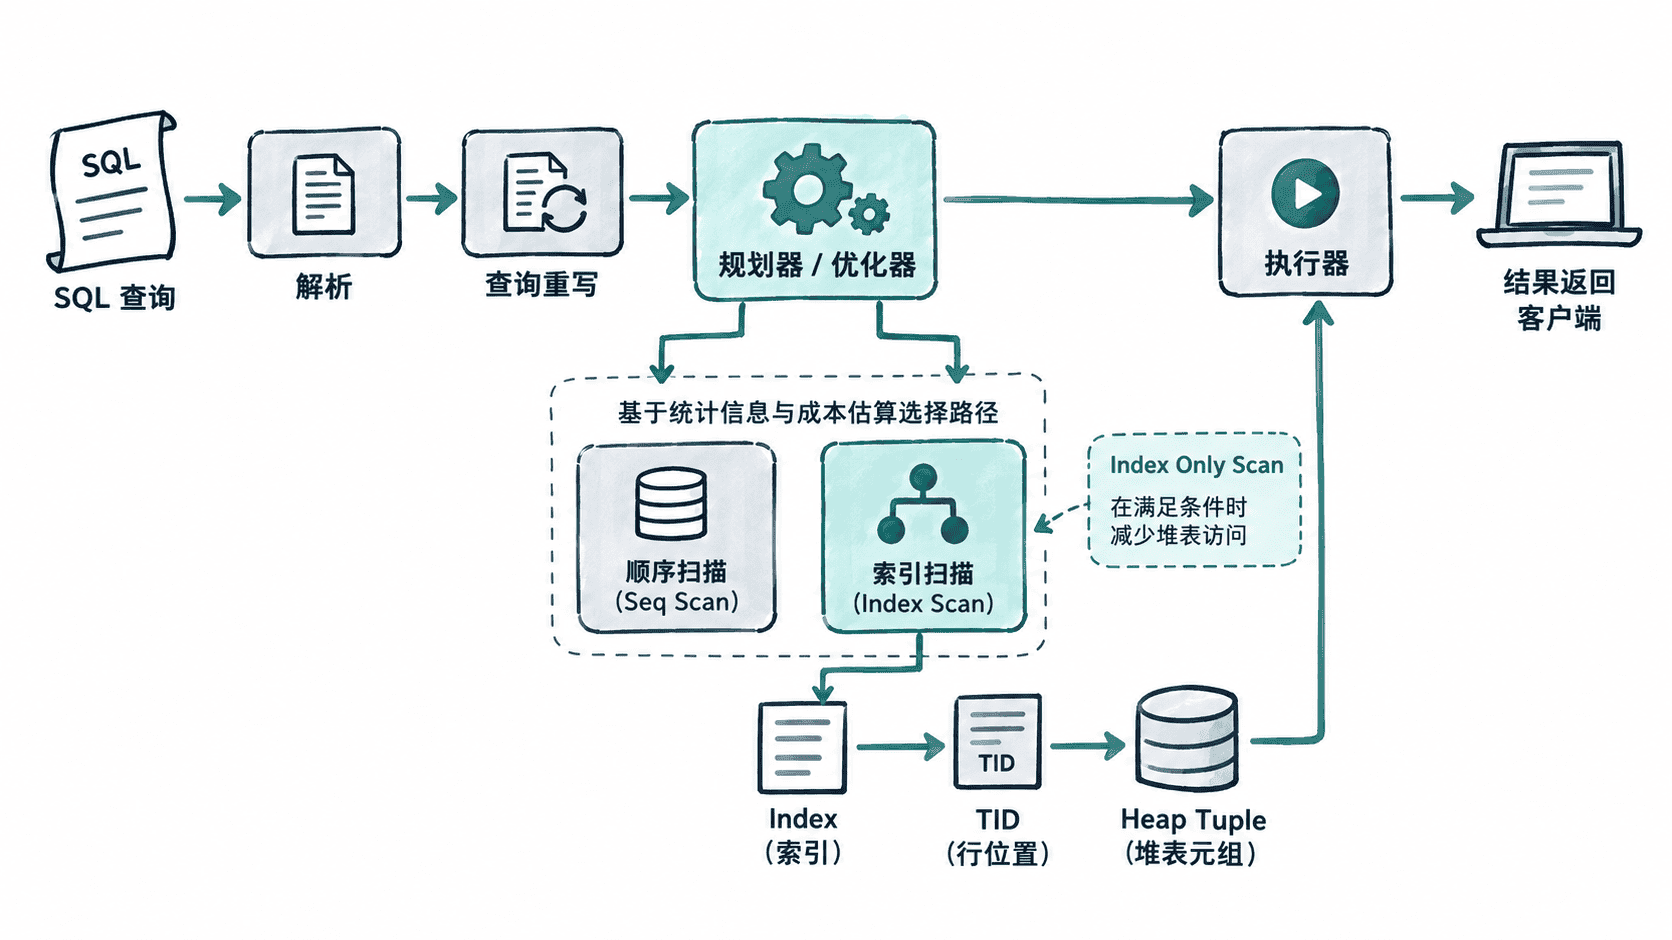
一条查询首先经过语法解析,随后进入查询重写和规划阶段。规划器会结合谓词、统计信息、可用索引以及估算成本,比较顺序扫描、索引扫描等候选路径,最终选择一个执行计划。
索引并不是执行器收到 SQL 后临时决定的“加速开关”。它更准确的角色是提供一种可供规划器选择的数据访问路径。因此,建了索引不代表每次查询都会使用它。
索引真正参与了什么
以 B-tree 索引为例,规划器判断某个条件适合索引访问后,执行器会通过索引定位可能匹配的索引项。索引项通常包含键值以及指向堆表行的 TID,随后根据 TID 访问堆表中的元组,并继续进行可见性等检查。
因此,一个常见的 Index Scan 并不是“只读索引就结束”,而是“先利用索引缩小候选范围,再访问堆表取行”。只有满足覆盖条件并且可见性映射允许时,Index Only Scan 才可能减少这部分堆访问。
用 EXPLAIN 验证访问路径
下面用一个最小示例观察规划器是否选择索引。示例使用较小数据量时可能因为顺序扫描成本更低而不走索引,所以先把数据量扩大到足以体现访问路径差异。
CREATE TABLE account_demo (
    id bigint PRIMARY KEY,
    email text NOT NULL,
    status text NOT NULL
);

INSERT INTO account_demo (id, email, status)
SELECT g,
       'user-' || g || '@example.com',
       CASE WHEN g % 10 = 0 THEN 'inactive' ELSE 'active' END
FROM generate_series(1, 100000) AS g;

CREATE INDEX idx_account_demo_email ON account_demo (email);

ANALYZE account_demo;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, email, status
FROM account_demo
WHERE email = 'user-50000@example.com';
预期结果中应看到 Index Scan 或在特定版本与统计状态下可出现其他等价访问路径,并能看到 idx_account_demo_email 被实际使用;ANALYZE 的作用是让规划器获得与当前数据分布对应的统计信息。
Index Scan using idx_account_demo_email on account_demo
  Index Cond: (email = 'user-50000@example.com'::text)
这里最值得关注的不是某个具体耗时,而是三个关系:查询条件是否能用于索引条件、规划器是否选择索引访问、执行器最终是否需要回到堆表取数据。
为什么“有索引”仍可能走顺序扫描
当查询返回大量行时,逐个通过索引定位再访问堆表可能比顺序读取整张表更贵;统计信息不准确时,规划器也可能错误估计匹配行数。此外,表达式或类型转换方式与索引定义不匹配,也可能让索引难以形成有效的索引条件。
所以性能分析时不要只看“有没有索引”,而要沿着谓词 → 计划 → 访问方式 → 实际行数 → 堆表访问逐层确认。索引设计真正要优化的,是让常见查询拥有合理、稳定且成本更低的访问路径。