
PostgreSQL / 系统课时
实施端到端在线迁移
实施端到端在线迁移
这一课把逻辑复制迁移从目标库准备一直做到最终切换:先同步兼容的 schema,再建立 Publication 与 Subscription,完成基线复制和持续追平,最后冻结旧源写入、同步序列并验收新主库。
学习目标
- 建立可执行的 Publication、Subscription 与初始数据同步链路
- 监控复制槽和订阅状态,判断目标库是否真正追平
- 完成停写、序列同步、连接切换和业务验收
准备目标库并建立复制通道
目标库必须先存在与发布表兼容的 schema。逻辑复制不会自动迁移 DDL,因此应先使用目标主版本的工具导出源库 schema,审查不兼容对象后再导入目标库。下面的命令假设目标库已经创建,且连接凭据通过环境或受控密码文件提供。
set -euo pipefail

pg_dump --schema-only --no-owner --no-privileges \
  -h <SOURCE_HOST> -p <PORT> -U <USER> -d <DBNAME> \
  > <PATH>/schema.sql

psql -h <TARGET_HOST> -p <PORT> -U <USER> -d <DBNAME> \
  -f <PATH>/schema.sql

echo "schema_loaded"
预期输出
schema_loaded实际 DDL 执行信息会随对象数量不同而变化。导入后要确认扩展版本、函数、排序规则和表定义均能在目标主版本正常创建,再继续复制。
源库还必须具备逻辑复制所需的 WAL 配置与可用复制槽资源。
SHOW wal_level;
SHOW max_replication_slots;
SHOW max_wal_senders;
预期输出
wal_level
logical

max_replication_slots
<VALUE>

max_wal_senders
<VALUE>
max_replication_slots 和 max_wal_senders 的实际值应覆盖现有复制任务和本次迁移链路,并保留余量。修改这些参数后是否需要重启,以对应 PostgreSQL 参数的生效规则为准。
创建 Publication 与 Subscription
在源库创建专用复制账号和 Publication。示例用 FOR ALL TABLES 覆盖当前数据库中的普通表,这种写法需要足够权限;权限模型受限时应显式列出迁移表,并在迁移窗口冻结 DDL,避免复制范围与目标 schema 发生漂移。
CREATE ROLE migration_repl
WITH LOGIN REPLICATION PASSWORD '<PASSWORD>';

GRANT CONNECT ON DATABASE <DBNAME> TO migration_repl;
GRANT USAGE ON SCHEMA public TO migration_repl;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO migration_repl;

CREATE PUBLICATION app_migration_pub FOR ALL TABLES;
预期结果
CREATE ROLE
GRANT
GRANT
GRANT
CREATE PUBLICATION
多 schema 数据库需要为每个发布 schema 授予相应 USAGE 和表 SELECT 权限。生产环境不要把复制密码写进共享脚本或终端历史。
目标库表应为空且结构兼容,然后创建 Subscription 触发初始数据复制,并在后续持续接收变更。
CREATE SUBSCRIPTION app_migration_sub
CONNECTION 'host=<SOURCE_HOST> port=<PORT> dbname=<DBNAME> user=migration_repl password=<PASSWORD> sslmode=require'
PUBLICATION app_migration_pub
WITH (
    copy_data = true,
    create_slot = true,
    enabled = true
);
预期结果
CREATE SUBSCRIPTION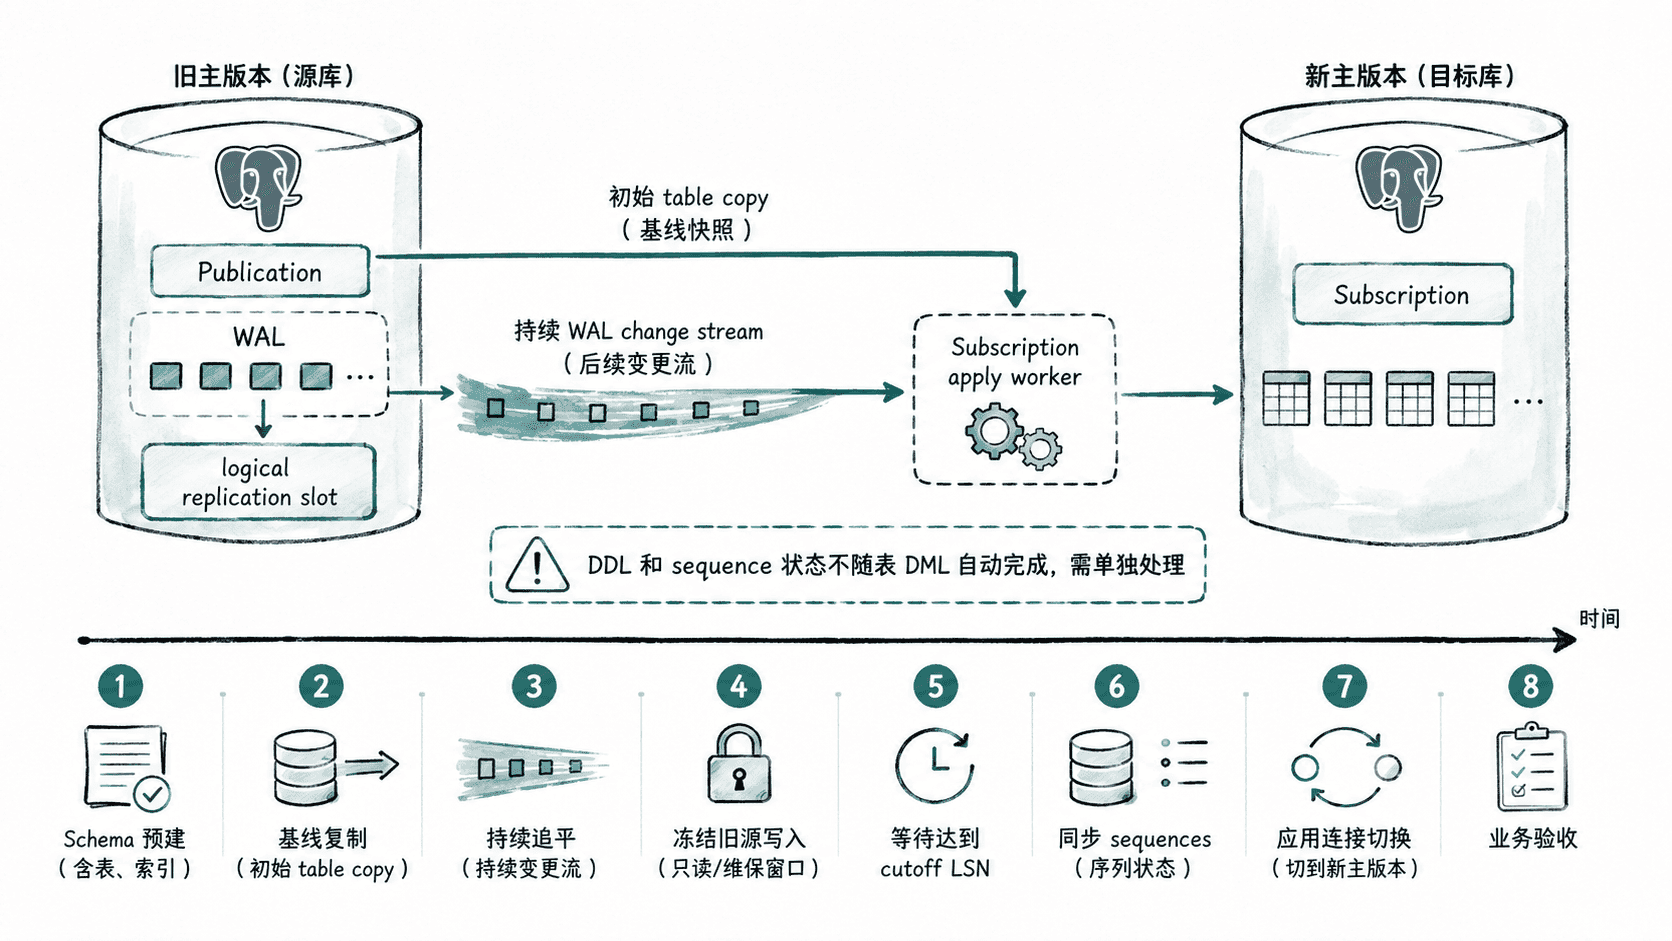
监控基线同步并持续追平
订阅建立后不要以“没有报错”作为完成标准。目标库要观察订阅 worker,源库要观察复制槽是否活跃,以及当前 WAL 与订阅已确认位置之间的差值是否在高峰负载下能够回落。
在目标库执行:
SELECT
    subname,
    pid,
    received_lsn,
    latest_end_lsn,
    latest_end_time
FROM pg_stat_subscription
WHERE subname = 'app_migration_sub';
预期结果
subname           | pid     | received_lsn | latest_end_lsn | latest_end_time
app_migration_sub | <PID>   | <VALUE>      | <VALUE>        | <TIME>
在源库执行:
SELECT
    slot_name,
    active,
    pg_size_pretty(
        pg_wal_lsn_diff(pg_current_wal_lsn(), confirmed_flush_lsn)
    ) AS pending_wal
FROM pg_replication_slots
WHERE slot_name = 'app_migration_sub';
预期结果
slot_name         | active | pending_wal
app_migration_sub | t      | <VALUE>
初始复制期间 lag 可以较大,但在停止新增写入后必须持续下降。若 pending_wal 长时间增长,应先处理目标端 I/O、锁等待、网络或 apply worker 问题,而不是直接进入切换。
冻结旧源写入并完成最终切换
进入切换窗口后,先通过业务维护开关、网关或数据库权限策略停止旧源上的业务写入,再记录一个明确的切换 LSN。任何仍能绕过维护开关写入旧源的后台任务,都必须在这个阶段停掉。
SELECT pg_current_wal_lsn() AS cutoff_lsn;预期结果
cutoff_lsn
<VALUE>
持续检查源库复制槽,直到 confirmed_flush_lsn 已达到或超过记录的 cutoff_lsn。这意味着订阅端已经确认处理到切换位置,才可以进入序列同步和连接切换。
逻辑复制不会替你保持普通 sequence 的当前位置。旧源已经冻结写入后,在源库生成 setval 语句,再到目标库执行,避免新主库开始写入后出现主键序列倒退。
SELECT format(
    'SELECT setval(%L, %s, true);',
    format('%I.%I', schemaname, sequencename),
    last_value
)
FROM pg_sequences
WHERE schemaname NOT IN ('pg_catalog', 'information_schema')
  AND last_value IS NOT NULL
ORDER BY schemaname, sequencename;
预期结果
SELECT setval('public.<SEQUENCE>', <VALUE>, true);把生成的语句在目标库执行成功后,再把应用连接指向目标库并恢复写入。序列允许出现间隙,迁移关注的是新值不能与已有键冲突。
用业务验收关闭迁移窗口
切换后先做最小业务验收:新建一条可追踪记录、读取刚写入的数据、执行一次更新,并确认异步任务、连接池、监控和告警都指向目标库。随后对关键表做行数、关键键范围和抽样业务数据核对;精确校验应优先使用能表达业务一致性的查询,而不是只比较总行数。
SELECT count(*) AS row_count
FROM <SCHEMA>.<TABLE>;
预期结果
row_count
<VALUE>
源库和目标库的 <SCHEMA>.<TABLE> 应在写入冻结点得到一致结果;对于允许后台维护改变统计信息但不改变业务数据的对象,应改用业务键或内容摘要校验。
目标库开始接受新业务写入后,旧源就不再是天然可直接切回的完整副本。若验收失败,需要按预先设计的回流或前滚修复方案处理;只有在目标尚未产生新写入时,才可以把“恢复旧源连接”作为简单回退路径。完成这些检查后,才能停止旧订阅、清理复制槽并进入旧库下线流程。