
PostgreSQL / 系统课时
设计低停机迁移总体流程
设计低停机迁移总体流程
低停机迁移的关键不是把“复制数据”和“切连接”连成一串命令,而是把持续写入期间的数据追平、短暂写冻结、目标端接管和可回滚窗口设计成可验证的阶段。最终切换应由门禁条件触发,而不是凭时间点拍板。
学习目标
- 把迁移拆成准备、基线复制、增量追平、切换、验证和收尾六个阶段。
- 为每个阶段定义可观察的进入条件、退出条件和主要风险。
- 设计写冻结、最终追平、序列同步与回滚边界,避免切换后双端分叉。
先分清数据线与流量线
低停机迁移同时存在两条线。数据线负责让目标 PostgreSQL 从“只有结构”变成“基线数据完整且持续追上增量”;流量线负责决定应用什么时候仍写源库、什么时候短暂停写、什么时候改连目标库。
只设计数据线会出现“目标已经追平,但应用还在持续产生新写入”的竞态;只设计流量线则会在切换时才发现表结构、序列或复制状态并未准备好。可靠方案必须在两条线之间设置明确门禁。
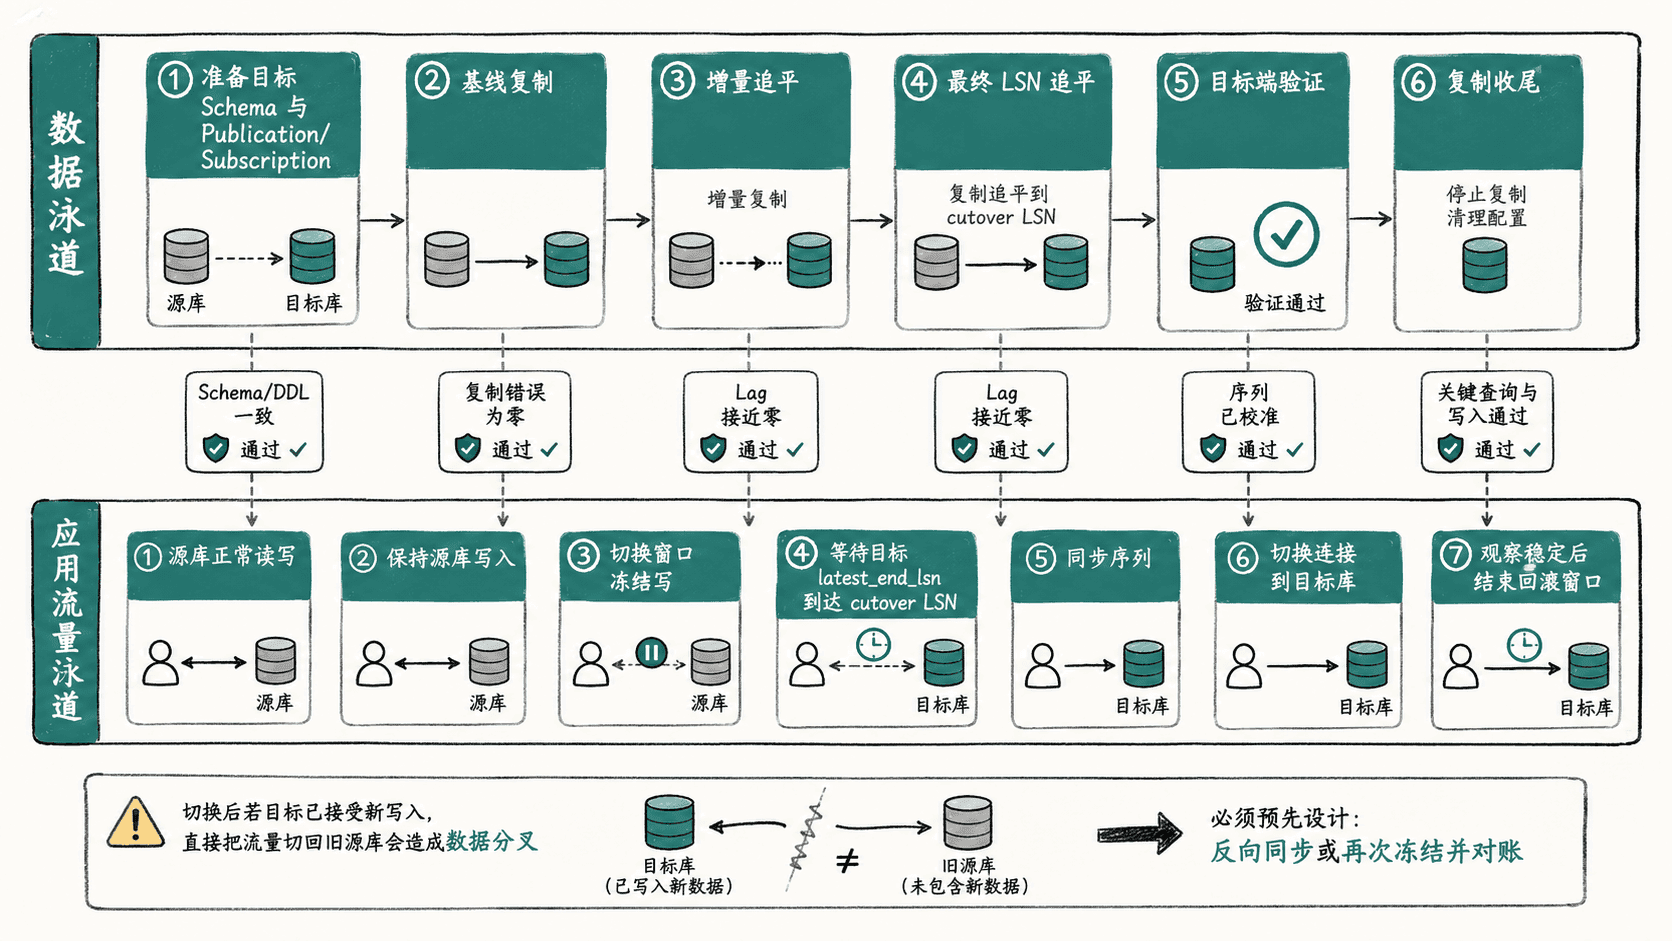
六个阶段分别解决什么
| 阶段 | 核心动作 | 退出门禁 | 主要风险 |
|---|---|---|---|
| 准备 | 盘点表、主键/replica identity、扩展、DDL、序列和不可复制对象;先在目标端准备兼容 Schema | 目标结构可承接复制数据,复制权限与容量就绪 | DDL 不一致、类型不兼容、遗漏对象 |
| 基线复制 | 复制已有表数据,同时允许源库继续服务 | 所有目标表完成初始同步 | 大表复制过慢、目标 I/O 被打满 |
| 增量追平 | 让逻辑复制持续消费基线期间及之后的新变更 | 复制稳定,Lag 可持续收敛到切换阈值 | 长事务、冲突、网络抖动、WAL 堆积 |
| 切换 | 冻结源端写入,记录最终 LSN,等待目标追平,同步序列后切应用连接 | 目标已覆盖冻结点之前的全部变更,应用可以连目标写入 | 未真正停写、序列落后、连接池仍指向源库 |
| 验证 | 验证关键读写、行数或业务对账、错误率与延迟 | 业务验收通过且没有新的复制/约束异常 | 只看总行数,漏掉关键业务差异 |
| 收尾 | 保留可控回滚窗口,随后停用订阅并按运行手册清理槽和旧库 | 新库稳定且回滚策略结束 | 过早删除复制关系,或旧源库被误写 |
基线阶段不要频繁做破坏性 DDL。逻辑复制不会自动传播 Schema 变更,发布端先增加目标端不存在的列或改变类型,都可能让后续变更无法应用。迁移窗口内最好设置 DDL 冻结;确需变更时,按兼容顺序先准备目标端,再修改源端。
切换门禁用 LSN 而不是等待几分钟
最稳妥的切换方式是先冻结源端业务写入,再在发布端记录一个 cutover LSN。这个位置代表“冻结之后,发布端已经生成到这里”。示例在源库执行:
SELECT pg_current_wal_lsn() AS cutover_lsn;预期结果:
 cutover_lsn
-------------
 <LSN>
把得到的 <LSN> 带到订阅端,检查订阅已经接收到并处理到不早于该位置。<ID> 替换为订阅名称:
SELECT
    subname,
    latest_end_lsn,
    latest_end_time,
    latest_end_lsn >= '<LSN>'::pg_lsn AS caught_up
FROM pg_stat_subscription
WHERE subname = '<ID>'
  AND relid IS NULL;
预期结果:
 subname | latest_end_lsn | latest_end_time | caught_up
---------+----------------+-----------------+----------
 <ID>    | <LSN>          | <TIME>          | t
实际 LSN 和时间会不同。只有 caught_up = true 还不够:还要确认订阅 worker 无错误、目标表可正常读写,并处理序列等不随逻辑复制推进的状态。对于高风险系统,可以同时记录冻结前后的业务对账基准,避免只依赖复制进度判断数据正确性。
序列与切换后的写入要单独处理
serial 或 identity 列的行值会作为普通列值复制,但序列对象自身的当前值不会自动同步。如果目标库切换后开始生成新主键,而序列仍停留在旧值,就可能撞上已经复制过来的主键。切换 runbook 应把序列校准作为独立门禁,并对所有会在目标端继续取号的序列逐一处理。
同样需要明确的是,低停机逻辑复制通常是单向的。目标库一旦接受了切换后的新写入,旧源库就不再天然拥有这些数据。此时“把连接字符串改回去”并不是完整回滚;除非事先设计了安全的反向同步,否则应再次冻结写入、对账并把目标端新增变化带回旧端后再回切。
验证与收尾决定迁移是否真正完成
切换后的验证至少覆盖三层:数据库层确认复制与约束没有异常,数据层对关键表做数量、主键范围或业务键对账,应用层执行最重要的读写路径并观察错误率与延迟。不要只用 COUNT(*) 相等作为成功标准,因为相同数量仍可能包含不同记录。
在回滚窗口结束前,可以让旧源库保持只读并保留必要的审计信息,但要防止应用或运维脚本继续写入。确认目标端稳定、回滚需求结束后,再按既定 runbook 停用订阅、清理复制槽与旧资源。这样迁移结束的标准不是“连接已经切过去”,而是数据、流量、验证和退路四件事都已闭环。