
PostgreSQL / 系统课时
优化大表初始同步
优化大表初始同步
大表初始同步慢,通常不是“逻辑复制本身慢”,而是同步并发、源端读取、网络传输、目标端写入与持续增量追赶共同形成瓶颈。本课用可观测数据判断限制点,再逐步提高并行度,避免为了缩短迁移时间反而拖慢生产库。
学习目标
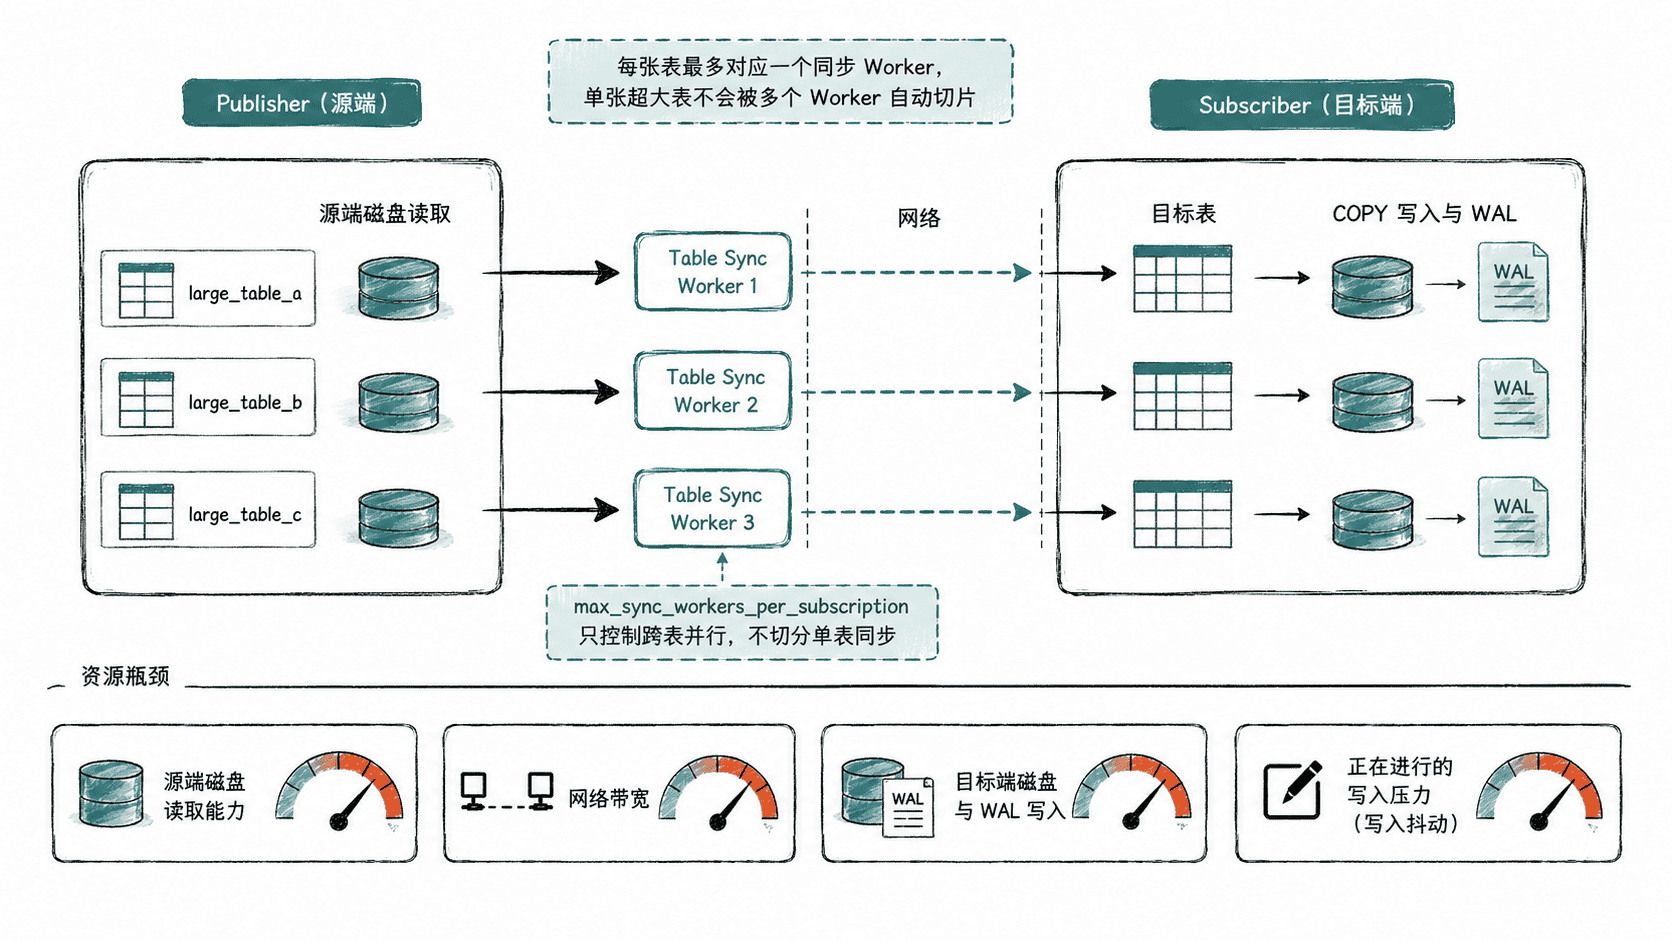
- 解释表同步 Worker 的并行边界,避免误以为单张大表能被多个 Worker 自动切片复制。
- 使用订阅状态与 COPY 进度建立同步基线,判断时间主要耗在哪一段。
- 在磁盘、网络和写入压力可控的前提下调整并发,并完成追平验收。
先确认并行同步的边界
初始同步会为待复制表启动专用的表同步 Worker。max_sync_workers_per_subscription 控制同一订阅可同时运行多少个同步 Worker,但一张表同一时刻只有一个表同步 Worker。因此,提高该参数主要加速“多张表同时复制”,不会把一张超大表自动拆成多个并行 COPY。
同步 Worker 还要占用逻辑复制 Worker 池;源端也需要足够的 WAL sender 与复制槽余量。只调高一个参数,常见结果是 Worker 根本起不来,或者并发增加后把瓶颈推到磁盘、网络或目标端 WAL 写入。
用进度视图建立基线
先在订阅端确认每张表处于什么状态,再观察正在运行的 COPY。srsubstate 中 d 表示正在复制数据,f 表示表复制结束,s 表示正在与主 Apply Worker 同步,r 才表示进入正常复制。
SELECT s.subname,
       r.srrelid::regclass AS table_name,
       r.srsubstate AS state,
       r.srsublsn
FROM pg_subscription_rel AS r
JOIN pg_subscription AS s
  ON s.oid = r.srsubid
ORDER BY s.subname, r.srrelid;

SELECT pid,
       relid::regclass AS table_name,
       command,
       type,
       bytes_processed,
       tuples_processed
FROM pg_stat_progress_copy
WHERE type = 'CALLBACK'
ORDER BY bytes_processed DESC;
预期结果
 subname | table_name    | state | srsublsn
---------+---------------+-------+----------
 sub_mig | public.orders | d     | <LSN>
 sub_mig | public.users  | r     | <LSN>

 pid  | table_name    | command   | type     | bytes_processed | tuples_processed
------+---------------+-----------+----------+-----------------+-----------------
 <ID> | public.orders | COPY FROM | CALLBACK | <BYTES>         | <ROWS>
实际 PID、LSN、字节数和行数会持续变化;如果此刻没有表处于 COPY 阶段,第二个查询返回 0 行。连续采样 bytes_processed,就能估算当前复制吞吐,而不是只看“运行了多久”。
调整同步并发而不是盲目加线程
先查看订阅端 Worker 上限以及源端相关容量。不同参数的 context 不同,是否只需 reload 或必须重启,应以当前实例的查询结果为准。
PUB_DSN='<PUB_DSN>'
SUB_DSN='<SUB_DSN>'

psql "$SUB_DSN" -c "
SELECT name, setting, context
FROM pg_settings
WHERE name IN (
  'max_sync_workers_per_subscription',
  'max_logical_replication_workers',
  'max_worker_processes'
)
ORDER BY name;"

psql "$PUB_DSN" -c "
SELECT name, setting, context
FROM pg_settings
WHERE name IN (
  'max_wal_senders',
  'max_replication_slots'
)
ORDER BY name;"
预期结果
               name                | setting | context
-----------------------------------+---------+----------
 max_logical_replication_workers   | <VALUE> | <CONTEXT>
 max_sync_workers_per_subscription | <VALUE> | <CONTEXT>
 max_worker_processes              | <VALUE> | <CONTEXT>

         name          | setting | context
-----------------------+---------+----------
 max_replication_slots | <VALUE> | <CONTEXT>
 max_wal_senders       | <VALUE> | <CONTEXT>
调优时把 max_sync_workers_per_subscription 逐级增加,例如从当前值提升一档后重新测量总 COPY 吞吐和生产延迟。订阅端的 max_logical_replication_workers、max_worker_processes 必须留出 Apply Worker 与其他后台 Worker 的空间;发布端的 max_wal_senders、max_replication_slots 也要为表同步连接保留余量。
根据症状定位真正瓶颈
| 观察现象 | 更可能的限制点 | 优先动作 |
|---|---|---|
| 增加 Worker 后总吞吐明显上升,生产查询延迟也上升 | 源端磁盘读取或缓存被争用 | 降低并发,改到低峰期,观察源端 I/O 与缓存命中 |
| 两端磁盘仍有余量,但网络出口长期接近上限 | 网络带宽 | 提升链路能力,或减少同时同步的表数以稳定业务流量 |
| 目标端磁盘利用率、WAL 写入和检查点压力明显升高 | Subscriber 写入 | 降低并发;必要时延后非关键二级索引构建 |
| COPY 很快结束,但表长时间停留在同步阶段 | 初始复制期间源表写入太活跃 | 提升 Apply 能力或选择写入较低的窗口,减少待追增量 |
只有一张超大表处于 d,其他表都已完成 |
单表串行 COPY 边界 | 提高同步 Worker 数不会帮助这张表,应从低峰期、表设计或迁移方案本身处理 |
非关键二级索引会放大 Subscriber 的写入成本。若目标库尚未承载业务,可在保证主键、唯一约束和复制所需结构正确的前提下,把不影响正确性的二级索引安排到基线复制之后创建,再在切流前完成性能验收。
以追平状态作为结束条件
初始 COPY 结束不等于迁移阶段完成。应等待所有订阅表进入 r,并确认 Apply 继续推进且没有持续错误,再把这轮优化视为成功。
SELECT count(*) AS not_ready_tables
FROM pg_subscription_rel
WHERE srsubstate <> 'r';
预期输出
 not_ready_tables
------------------
 0
真正有效的优化是“单位时间复制更多数据,同时不突破生产库和目标库的资源预算”。如果瓶颈是一张单独的超大表,继续增加同步 Worker 没有意义;如果瓶颈是跨表并发不足,则应在资源监控下逐级提高并发,直到吞吐不再提升或业务指标开始恶化。