
PostgreSQL / 系统课时
理解初始表同步阶段
理解初始表同步阶段
创建逻辑订阅后,已有数据并不是简单复制完就结束。PostgreSQL 会让表同步 Worker 先基于一致性快照复制存量数据,再追上复制期间产生的增量变更,最后把表交回主 Apply Worker。本篇用状态码和监控 SQL 把这段衔接过程看清楚。
学习目标
- 能解释存量快照与增量 WAL 如何在初始同步阶段衔接。
- 能读懂
pg_subscription_rel中i、d、f、s、r的状态变化。 - 能用系统视图判断表是在复制、追平还是已经进入正常持续复制。
初始同步不只是一次 COPY
当 subscription 使用默认的 copy_data = true 时,主 Apply Worker 会为尚未就绪的表安排 table synchronization worker。每个同步 Worker 为自己的表建立同步所需的复制槽,从发布端取得一致性快照并复制当时已经存在的数据。
复制期间源表仍可继续写入。同步 Worker 完成存量复制后,不会直接宣布结束,而是进入追平阶段,把快照之后产生的逻辑变更按顺序应用到本地,直到与主 Apply Worker 协调到同一同步位置。之后这张表才交给主 Apply Worker 持续处理新的变更。
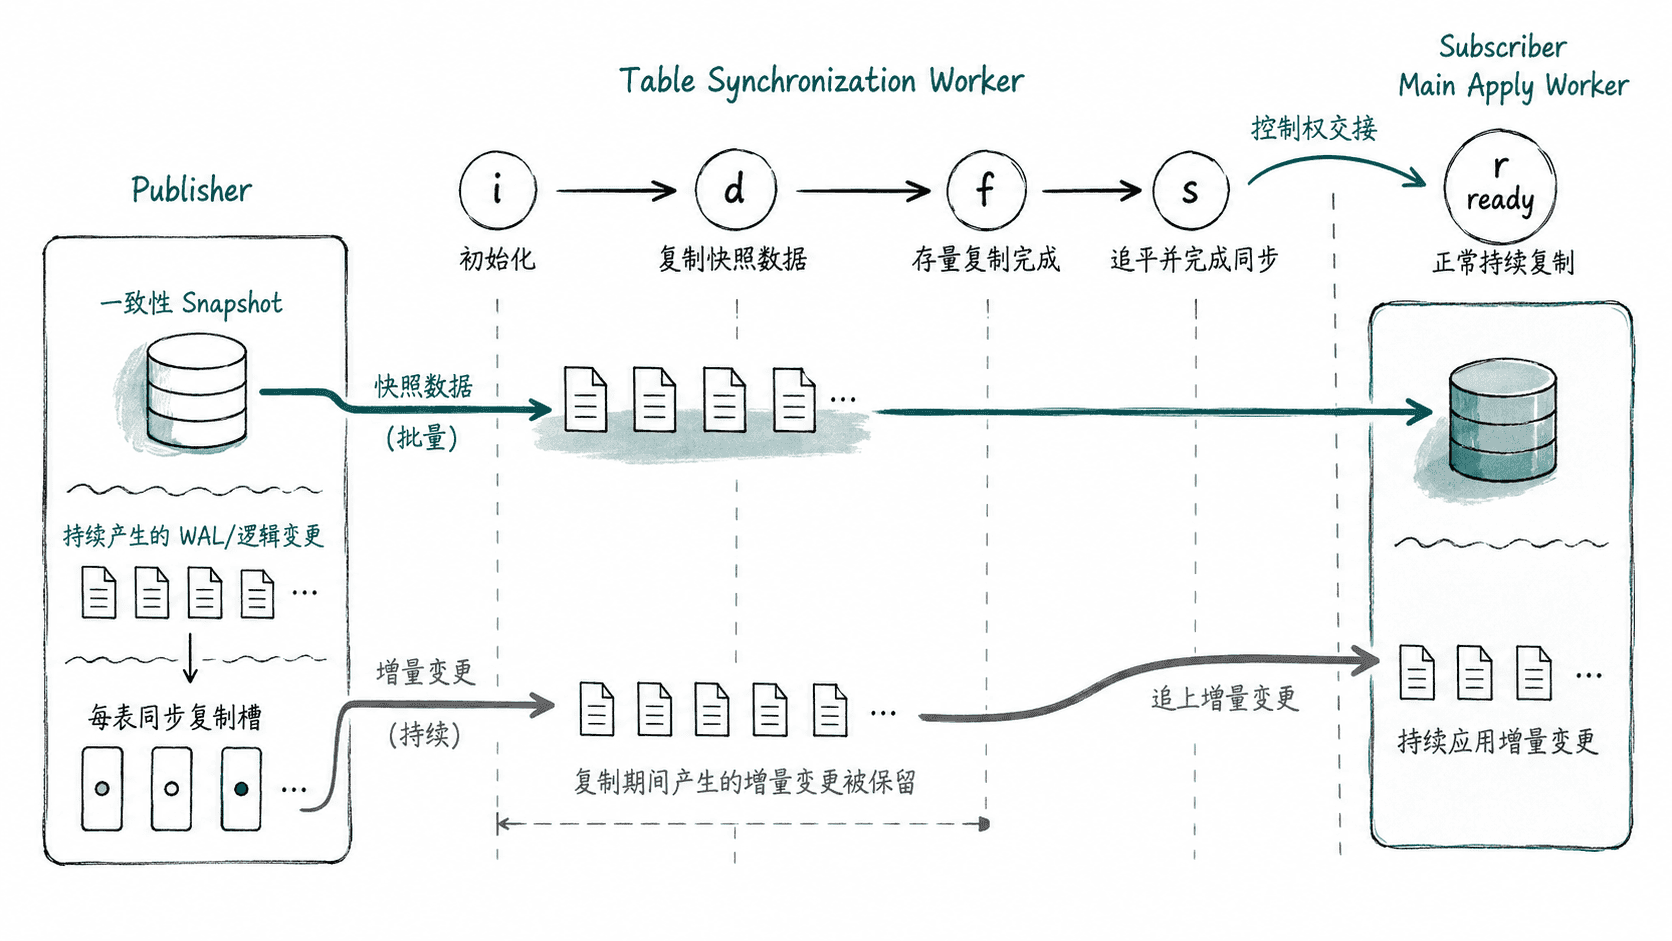
这正是低停机迁移能在源库持续写入时完成“存量搬运 + 增量追平”的关键:快照定义存量起点,同步复制槽保证复制期间发生的变化不会在交接前丢失。
读懂五个表同步状态
pg_subscription_rel 为每个 subscription 与目标表记录一条状态。常见推进顺序如下。
| 状态 | 含义 | 运维判断 |
|---|---|---|
i |
initialize | 已登记,等待开始同步 |
d |
data is being copied | 正在复制初始表数据 |
f |
finished table copy | 存量复制已完成,但尚未完成最终同步 |
s |
synchronized | 已追到用于交接的同步位置 |
r |
ready | 已交给主 Apply Worker,进入正常复制 |
状态可能推进很快,轮询时不一定能人工看到每个中间值。尤其不能把 f 当作“迁移完成”:它只说明表复制阶段结束,后面仍可能有复制期间积累的增量需要追平。
用系统目录跟踪每张表
在订阅端执行下面的查询,可以把状态码翻译成可读名称,并同时观察同步协调使用的 LSN。
SELECT
    s.subname,
    n.nspname AS schema_name,
    c.relname AS table_name,
    sr.srsubstate,
    CASE sr.srsubstate
        WHEN 'i' THEN 'initializing'
        WHEN 'd' THEN 'copying data'
        WHEN 'f' THEN 'finished copy'
        WHEN 's' THEN 'synchronized'
        WHEN 'r' THEN 'ready'
        ELSE 'unknown'
    END AS state_name,
    sr.srsublsn
FROM pg_subscription_rel AS sr
JOIN pg_subscription AS s
  ON s.oid = sr.srsubid
JOIN pg_class AS c
  ON c.oid = sr.srrelid
JOIN pg_namespace AS n
  ON n.oid = c.relnamespace
WHERE s.subname = 'migration_sub'
ORDER BY n.nspname, c.relname;
预期结果
    subname    | schema_name |    table_name    | srsubstate |  state_name  | srsublsn
---------------+-------------+------------------+------------+--------------+----------
 migration_sub | public      | customer_orders  | d          | copying data |
这是“正在复制”时的示例。实际查询可能看到 i、d、f、s 或 r;srsublsn 在 s、r 阶段才具有同步协调意义,因此早期状态为空是正常现象。
还可以从 pg_stat_subscription 区分主 Apply Worker 与正在工作的表同步 Worker。为了兼容 PostgreSQL 15 及以上版本,下面不依赖较新版本才提供的 worker_type 列,而是用 relid 判断:主 Apply Worker 的 relid 为空,表同步 Worker 会指向具体关系。
SELECT
    subname,
    pid,
    relid::regclass AS syncing_table,
    received_lsn,
    latest_end_lsn
FROM pg_stat_subscription
WHERE subname = 'migration_sub'
ORDER BY relid NULLS FIRST;
预期输出
    subname    |  pid  |  syncing_table   | received_lsn | latest_end_lsn
---------------+-------+------------------+--------------+---------------
 migration_sub | <PID> |                  | <LSN>        | <LSN>
 migration_sub | <PID> | customer_orders  | <LSN>        | <LSN>
拷贝进行中时通常会同时看到主 Apply Worker 和一个或多个表同步 Worker;<PID>、<LSN> 会随实例和时间变化。等该表进入 r 后,对应的表同步 Worker 会退出,持续复制由主 Apply Worker 接管。
判断初始同步是否真正结束
批量迁移时,最直接的门禁是确认目标 subscription 的所有关系都进入 r。下面的查询把未就绪表数量直接算出来。
SELECT
    count(*) FILTER (WHERE sr.srsubstate <> 'r') AS not_ready,
    count(*) FILTER (WHERE sr.srsubstate = 'r') AS ready
FROM pg_subscription_rel AS sr
JOIN pg_subscription AS s
  ON s.oid = sr.srsubid
WHERE s.subname = 'migration_sub';
预期结果
 not_ready | ready
-----------+------
         0 | <VALUE>
当 not_ready = 0 时,说明初始表同步阶段已经结束,所有表都进入正常持续复制;<VALUE> 是该 subscription 当前登记的表数量。
但“全部为 r”只证明表级初始化完成,不等于业务已经满足切换条件。低停机迁移还应继续观察主 Apply Worker 的接收与应用进度、发布端积压以及关键表的数据核对,直到增量延迟稳定在切换窗口允许范围内。
如果某张表长时间停在 d,先确认它是否只是数据量大,再检查订阅端是否仍有对应同步 Worker、服务端日志是否反复报错,以及 max_logical_replication_workers、max_sync_workers_per_subscription 与 max_worker_processes 是否还有可用名额。停在 f 或 s 时,则更应关注增量追平和与主 Apply Worker 的协调,而不是重复执行存量复制。
初始同步的正确完成条件不是“目标表已经有数据”,而是存量快照复制完成、复制期间的增量被追上,并最终进入 r 由主 Apply Worker 持续接管。