
PostgreSQL / 系统课时
保持 Schema 与 DDL 一致
保持 Schema 与 DDL 一致
逻辑复制持续传输的是数据变化,不会自动把建表、加列、删列、改类型或创建索引同步到目标库。低停机迁移要把 DDL 当作独立发布流程管理:先建立可复制的目标 Schema,再按兼容顺序变更两端,并在每次发布后验证结构差异。
学习目标
- 明确逻辑复制对 Schema、表名、列名和索引的处理边界。
- 为新增字段、删除字段、改类型和创建索引设计不会中断 Apply 的发布顺序。
- 使用可重复的结构导出与结构指纹检查,发现两端 DDL 漂移。
明确逻辑复制不会替你做的事
发布端执行 DDL 后,订阅端不会自动执行同一条 DDL。被订阅的目标表必须事先存在,并以完全限定表名对应;复制列按列名匹配,而不是按物理列顺序匹配。目标端可以存在额外列,但必须能为复制没有提供的值接受默认值或空值;反过来,发布端开始发送一个目标端不存在的列时,Apply 会报错并停止在该变更处。
因此,在线 DDL 的核心不是“两个库最终一样”这么简单,而是整个发布窗口内都要保持数据流可被目标结构接收。
用受控基线初始化目标 Schema
对全新目标库,先从发布端导出 Schema,再导入订阅端。导出时排除 publication 和 subscription 对象,避免把复制拓扑本身误建到目标库。下面示例使用占位连接串,执行前替换 <PUB_DSN>、<SUB_DSN> 和 <PATH>。
set -euo pipefail

PUB_DSN='<PUB_DSN>'
SUB_DSN='<SUB_DSN>'
SCHEMA_FILE='<PATH>/publisher-schema.sql'

pg_dump "$PUB_DSN"   --schema-only   --no-owner   --no-privileges   --no-publications   --no-subscriptions   > "$SCHEMA_FILE"

psql "$SUB_DSN" -v ON_ERROR_STOP=1 -f "$SCHEMA_FILE" >/dev/null
echo "schema bootstrap ok"
预期输出
schema bootstrap ok这套做法适合空白或专门为迁移准备的目标库。若目标库已经有业务对象,不要直接重放完整 Schema dump,而应先做差异检查,再把需要的 DDL 编成可审计、可回滚的迁移脚本。
为在线 DDL 设计兼容窗口
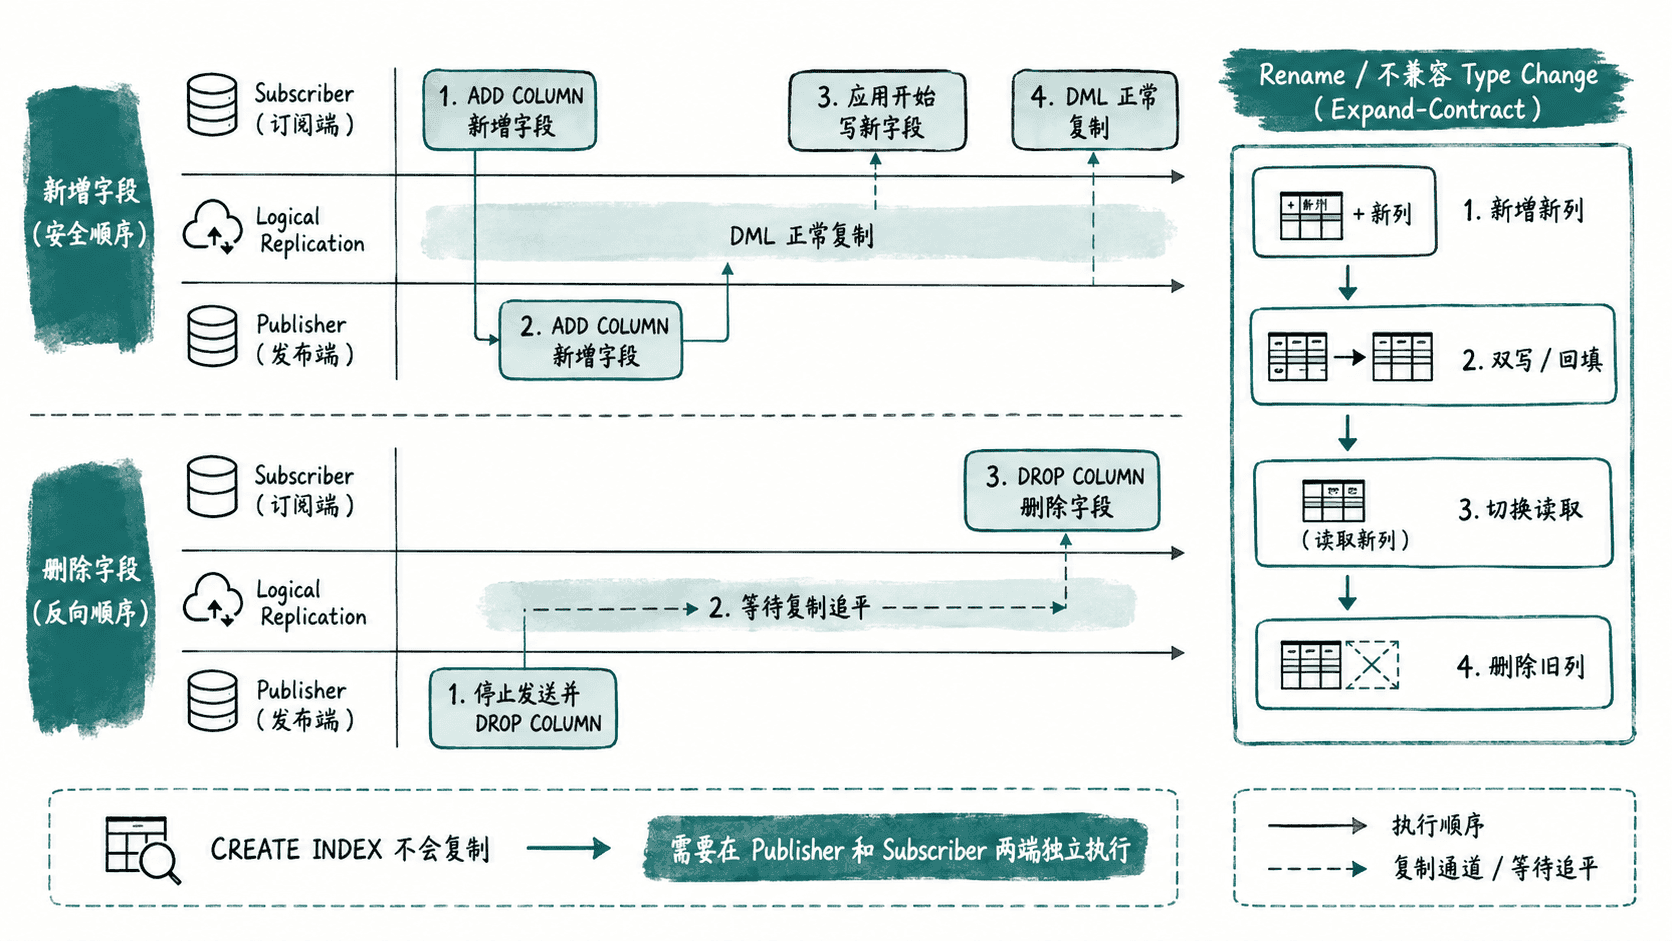
不同 DDL 的安全顺序并不相同。判断标准只有一个:发布端产生的新 DML 到达时,订阅端结构是否已经能够接收。
| 变更类型 | 推荐顺序 | 原因 |
|---|---|---|
| 新增可空或兼容默认值字段 | Subscriber → Publisher → 应用开始写新字段 | 目标端先具备接收能力,避免新列数据先到 |
| 删除字段 | Publisher 停止发送/删除 → 等待追平 → Subscriber 删除 | 目标端可以暂时多一列,但不能先少掉仍在传输的列 |
| 重命名字段 | 优先 Expand-Contract,不直接双端瞬时 rename | 复制按列名匹配,直接改名容易制造短暂不兼容 |
| 不兼容类型变更 | 新列承接 → 双写或回填 → 切换 → 删除旧列 | 避免 Apply 遇到无法转换的数据表示 |
| 创建二级索引 | 两端独立执行;目标端最晚在切流前就绪 | 索引 DDL 不复制,但目标库切流后需要正确的查询性能 |
例如给 public.orders 增加一个可空的 shipping_note 字段,应先改 Subscriber,再改 Publisher。下面命令把顺序固化在同一个发布脚本中。
set -euo pipefail

PUB_DSN='<PUB_DSN>'
SUB_DSN='<SUB_DSN>'

psql "$SUB_DSN" -v ON_ERROR_STOP=1   -c "ALTER TABLE public.orders ADD COLUMN IF NOT EXISTS shipping_note text;"

psql "$PUB_DSN" -v ON_ERROR_STOP=1   -c "ALTER TABLE public.orders ADD COLUMN IF NOT EXISTS shipping_note text;"
预期输出
ALTER TABLE
ALTER TABLE
完成第二条 DDL 后,再发布会写入 shipping_note 的应用版本。这样即使新字段的 DML 很快进入逻辑复制链路,目标表也已经具备同名列。
用结构指纹发现漂移
DDL 变更完成后,不要只靠人工看 \d。下面脚本分别导出 public Schema 的列定义和索引定义,再用 diff 比较。实际项目可把它放进迁移流水线,在切流前作为门禁。
set -euo pipefail

PUB_DSN='<PUB_DSN>'
SUB_DSN='<SUB_DSN>'
WORK_DIR='<PATH>'

mkdir -p "$WORK_DIR"

COL_SQL="SELECT concat_ws('|', table_schema, table_name, ordinal_position, column_name, data_type, is_nullable, coalesce(column_default, '')) FROM information_schema.columns WHERE table_schema = 'public' ORDER BY table_name, ordinal_position;"
IDX_SQL="SELECT concat_ws('|', schemaname, tablename, indexname, indexdef) FROM pg_indexes WHERE schemaname = 'public' ORDER BY tablename, indexname;"

psql "$PUB_DSN" -At -c "$COL_SQL" > "$WORK_DIR/pub.columns"
psql "$SUB_DSN" -At -c "$COL_SQL" > "$WORK_DIR/sub.columns"
psql "$PUB_DSN" -At -c "$IDX_SQL" > "$WORK_DIR/pub.indexes"
psql "$SUB_DSN" -At -c "$IDX_SQL" > "$WORK_DIR/sub.indexes"

diff -u "$WORK_DIR/pub.columns" "$WORK_DIR/sub.columns"
echo "column definitions match"

diff -u "$WORK_DIR/pub.indexes" "$WORK_DIR/sub.indexes"
echo "index definitions match"
预期输出
column definitions match
index definitions match
如果 diff 打印差异并返回非零状态,就应先确认差异是否是有意的兼容窗口,而不是继续切流。默认值、约束、索引、分区定义和自定义类型也要纳入实际项目的结构审计;上面的指纹脚本覆盖的是最常见的列与索引漂移。
对高风险 DDL 使用 Expand-Contract
字段重命名、缩窄类型、拆列或合列都不适合在两个数据库上“同时敲一条 DDL”来碰运气。更稳妥的做法是先新增兼容结构,让应用在一段时间内双写或回填,确认 Subscriber 已追平并能正确读取新结构后,再切换应用读取,最后由 Publisher 先停止发送旧结构,等复制追平后再清理 Subscriber。
索引也应按迁移阶段安排:初始复制期间可以推迟不影响正确性的二级索引,以减少 Subscriber 写放大;但主键、唯一约束以及切流后关键查询依赖的索引必须在对应阶段前准备好。DDL 治理的目标不是强求两端每一秒完全相同,而是让每个中间状态都兼容、可验证,并且能安全进入下一个状态。