
PostgreSQL / 系统课时
规划跨主版本迁移方案
规划跨主版本迁移方案
跨主版本迁移真正难的不是创建 Subscription,而是把数据规模、持续写入、版本差异和切换窗口同时约束住。本课会把这些变量变成可验证的迁移门禁,并明确什么时候可以切、什么时候必须停止或回退。
学习目标
- 盘点源库规模、复制身份、扩展与版本差异,识别逻辑复制迁移风险
- 根据基线复制时间、追平能力和停写窗口设计迁移阶段
- 为切换、验收和回退定义可执行的门禁条件
先量化源库和目标约束
迁移方案首先要回答四个问题:源库有多大、峰值写入有多快、目标版本能否承载现有对象、业务最多允许停写多久。不要只看数据库总大小,还要找出没有主键或合适 Replica Identity 的更新型表,因为它们会直接影响 UPDATE、DELETE 的逻辑复制。
在源库执行下面的盘点 SQL,先建立可讨论的事实基线。
SELECT
    current_setting('server_version') AS source_version,
    pg_size_pretty(pg_database_size(current_database())) AS database_size,
    count(*) FILTER (WHERE c.relkind = 'r') AS heap_tables
FROM pg_class AS c
JOIN pg_namespace AS n ON n.oid = c.relnamespace
WHERE n.nspname NOT IN ('pg_catalog', 'information_schema');

SELECT
    n.nspname AS schema_name,
    c.relname AS table_name,
    c.relreplident AS replica_identity
FROM pg_class AS c
JOIN pg_namespace AS n ON n.oid = c.relnamespace
WHERE c.relkind = 'r'
  AND n.nspname NOT IN ('pg_catalog', 'information_schema')
  AND c.relreplident = 'd'
  AND NOT EXISTS (
      SELECT 1
      FROM pg_index AS i
      WHERE i.indrelid = c.oid
        AND i.indisprimary
  )
ORDER BY 1, 2;
预期结果
source_version | database_size | heap_tables
<VALUE>        | <VALUE>       | <VALUE>

schema_name | table_name | replica_identity
public      | <VALUE>    | d
实际版本、容量和表名会不同。第二个结果集应逐表确认:如果这些表会发生 UPDATE 或 DELETE,就应补主键、指定合适的 Replica Identity,或评估 REPLICA IDENTITY FULL 带来的 WAL 与匹配成本。
用四类约束决定迁移路径
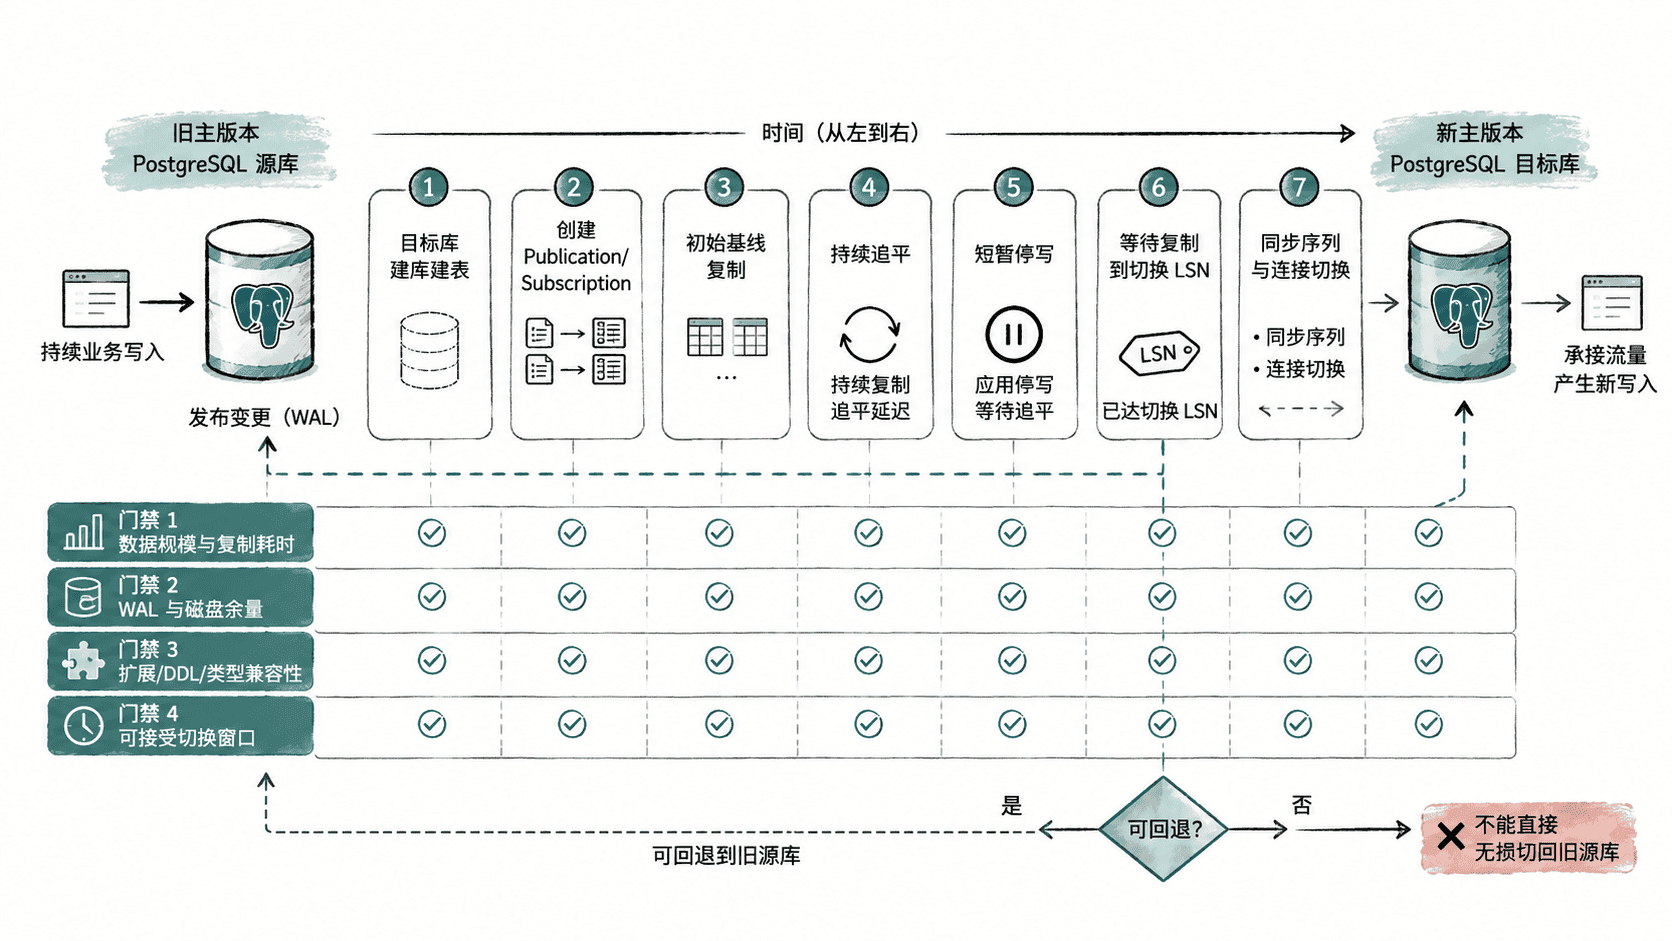
逻辑复制适合“旧源库持续对外写入,新目标库先做基线复制,再持续追平,最后短暂停写完成切换”的路径。规划时要把以下约束分别落到可测指标,而不是写成“低峰期操作”之类的模糊描述。
- 规模约束:用真实网络、磁盘和目标库写入能力估算初始复制耗时,并预留索引维护和 autovacuum 的资源。
- 写入约束:初始复制期间仍会产生 WAL;复制槽保留的 WAL 不能让源库磁盘进入高水位,追平速度必须长期高于新增变更速度。
- 版本约束:目标库要先处理不兼容的扩展、数据类型、排序规则、函数和参数。逻辑复制不会替你完成 DDL、扩展安装、权限或所有数据库级对象的升级。
- 窗口约束:最终切换窗口至少要覆盖停写、追到切换 LSN、同步未自动复制的序列状态、修改连接配置和业务冒烟验证。
把切换条件写成硬门禁
最终切换前至少应有一组明确的“通过/不通过”条件。它们最好能由监控或 SQL 直接验证,而不是依赖现场判断。
| 门禁 | 通过条件 | 不通过时处理 |
|---|---|---|
| 目标结构 | 必要 schema、扩展、表、索引与权限已在目标版本验证 | 修复兼容问题后重新演练 |
| 基线同步 | 全部计划内表完成初始复制 | 查表同步错误、权限或目标约束冲突 |
| 复制追平 | 高峰写入下 lag 能持续回落,源库 WAL 空间有余量 | 降低同步并发或扩容网络、I/O、WAL 空间 |
| 写入冻结 | 切换窗口内可以阻止旧源继续产生业务写入 | 不进入最终切换 |
| 数据校验 | 核心表行数、关键业务记录和抽样校验一致 | 停止切换并定位差异 |
| 回退 | 明确切换前后的回退边界与责任人 | 不允许进入生产切换 |
逻辑复制通常是单向链路。如果目标库开始产生新业务写入,再直接把应用切回旧源库会造成数据分叉。 因此回退方案要么把决策点放在目标开始写入之前,要么提前设计反向复制、双写或其他可验证的数据回流机制;不能把“改回连接串”当成完整回退方案。
把方案压缩成一次可演练的执行单
最终文档应按阶段写出负责人、开始条件、退出条件和观察项。准备阶段完成目标版本兼容性验证;同步阶段记录基线复制速度、复制槽 WAL 保留量和 lag;切换阶段只允许执行已经演练过的停写、追平、序列同步和连接切换;验收阶段检查业务读写、后台任务、监控和错误日志。
一次有效的迁移演练不是证明“逻辑复制能跑起来”,而是证明在真实负载和真实窗口下,每个门禁都有数据支撑,而且任何一个门禁失败时都有明确的停止条件。只有这份计划能重复执行,跨主版本迁移才具备上线条件。