
PostgreSQL / 系统课时
评估并控制复制延迟
评估并控制复制延迟
迁移切换前最危险的误判,是把“复制连接正常”当成“数据已经追平”。本课把延迟拆成字节、时间和业务可见性三层,并给出可执行的观测与门禁方法,让切换判断基于连续证据,而不是单个瞬时指标。
学习目标
- 区分字节延迟、时间延迟和应用延迟各自回答的问题
- 用复制槽和心跳数据建立可重复的追平观测
- 为低停机切换制定连续采样的通过条件和降载策略
把复制延迟拆成三层
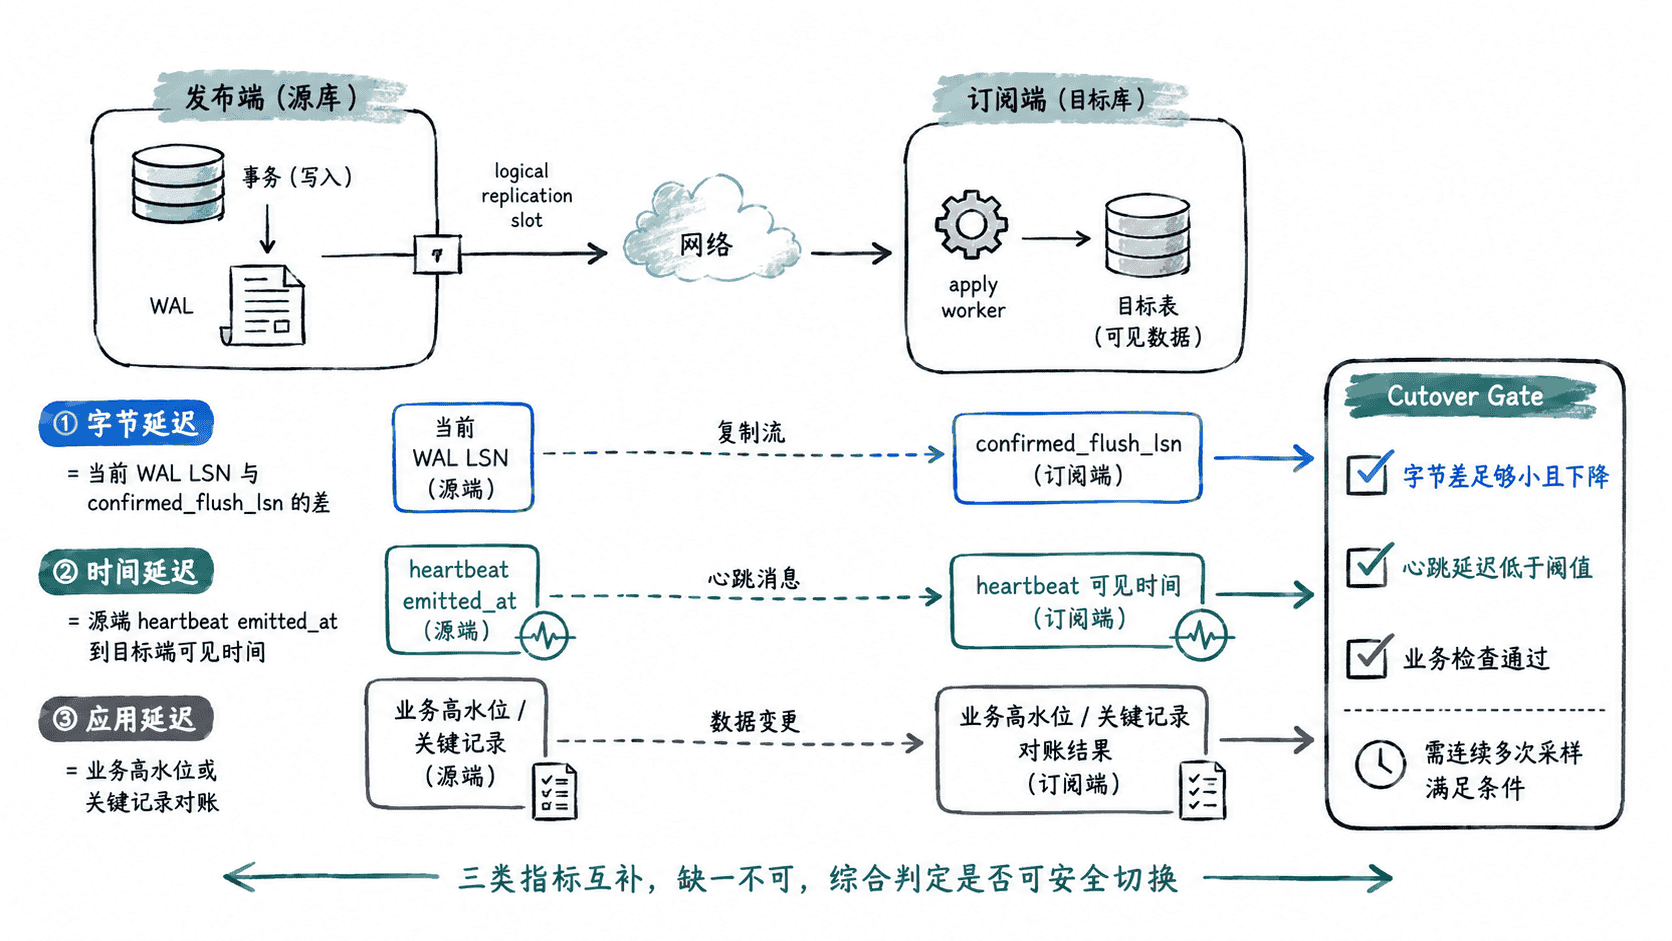
字节延迟回答“发布端 WAL 位置与订阅确认位置还差多少字节”,适合观察积压是否在扩大。时间延迟回答“最近一次源端心跳经过复制后,多久才在目标端可见”,更接近用户感知。应用延迟则回答“业务关键数据是否已经满足切换条件”,例如最后订单号、事件高水位或对账结果是否一致。
这三种指标不能互相替代。字节差很小不代表关键事务已经可见;心跳很快也不代表所有历史积压已经处理完;业务对账一致则可能只覆盖少量关键表。迁移切换应把三者组合成门禁。
用字节差观察积压趋势
在发布端查询逻辑复制槽与当前 WAL 的距离。迁移中不要只记录一次结果,应按固定间隔采样,看差值是在收敛、稳定还是扩大。
SELECT
    slot_name,
    active,
    confirmed_flush_lsn,
    pg_wal_lsn_diff(
        pg_current_wal_lsn(),
        confirmed_flush_lsn
    ) AS byte_lag
FROM pg_replication_slots
WHERE slot_type = 'logical'
ORDER BY slot_name;
预期结果
slot_name | active | confirmed_flush_lsn | byte_lag
<NAME>    | t      | <LSN>               | <VALUE>
byte_lag 是 WAL 位置差,不是未复制行数,也不是秒数。若源端仍有大量写入,它可能短暂上升;真正需要关注的是持续趋势。切换窗口开始前,通常应先降低非必要写流量,让订阅端处理速度稳定高于新的 WAL 产生速度。
用复制心跳测时间延迟
系统视图里的消息时间可以判断连接是否活跃,但不等于“某条业务记录从提交到目标端可见”的耗时。更稳妥的办法是准备一张只保留一行的心跳表,并让它参与逻辑复制。逻辑复制不会自动复制表结构,所以源端和目标端都要先创建相同表。
在发布端和订阅端分别执行一次:
CREATE TABLE migration_heartbeat (
    singleton boolean PRIMARY KEY DEFAULT true CHECK (singleton),
    emitted_at timestamptz NOT NULL
);
预期结果
CREATE TABLE如果 publication 使用显式表清单,再在发布端把心跳表加入 publication,并在订阅端刷新订阅。下面示例假设 publication 名为 migration_pub、subscription 名为 migration_sub;若实际名称不同应替换。
发布端:
ALTER PUBLICATION migration_pub
ADD TABLE migration_heartbeat;

INSERT INTO migration_heartbeat (singleton, emitted_at)
VALUES (true, clock_timestamp())
ON CONFLICT (singleton)
DO UPDATE SET emitted_at = EXCLUDED.emitted_at;
预期结果
ALTER PUBLICATION
INSERT 0 1
订阅端:
ALTER SUBSCRIPTION migration_sub
REFRESH PUBLICATION;

SELECT
    emitted_at,
    clock_timestamp() - emitted_at AS heartbeat_lag
FROM migration_heartbeat
WHERE singleton = true;
预期结果
emitted_at | heartbeat_lag
<TIME>     | <VALUE>
首次刷新 publication 可能触发表同步,因此应在正式切换前完成,不要在最后几秒才增加监控表。之后由源端定时更新 emitted_at,目标端持续读取 heartbeat_lag,就能得到端到端可见性延迟。实际值会随网络、事务大小和目标端负载波动。
让延迟真正收敛
当字节延迟持续扩大时,先判断是“源端产生得太快”还是“订阅端处理得太慢”。前者可以在切换前暂停批处理、离线导入和非必要写任务;后者应检查目标端 CPU、磁盘 I/O、锁等待、长事务以及 apply worker 是否报错。
如果复制槽不再前进,不要靠反复重启订阅掩盖问题。应先查看订阅错误日志和目标表冲突,确认 schema、约束和数据状态是否允许继续应用。迁移过程中还要监控发布端 WAL 保留量,因为复制槽落后会阻止旧 WAL 被回收。
对超大事务要特别谨慎。即使网络吞吐充足,大事务的提交与应用仍可能造成明显的追平波峰。临近切换时应避免启动新的大批量事务,并尽量让正在运行的大事务先结束。
把切换条件写成连续门禁
一个可操作的切换门禁可以同时要求:字节差低于团队设定阈值且继续下降;心跳延迟低于允许的秒数;关键业务高水位或抽样对账通过;以上条件连续多个采样周期成立。阈值必须根据真实写入速率和允许停机时间设定,不能照搬固定数字。
例如,团队可以规定连续 3 次、每次间隔 10 秒都满足“字节差小于 1 MiB、心跳延迟小于 5 秒、关键表高水位一致”才进入最终停写。这里的数字只是示例,真正的门槛应来自压测和迁移演练。
最终停写后还要继续观察,直到源端不再产生新的业务 WAL、复制位置稳定追平,并完成最后一次业务验证再切换连接。这样控制的不是某个瞬时“lag 值”,而是从源端降载、复制收敛到业务确认的一整条切换证据链。