
AI Agent / 系统课时
分析需求与代码库
分析需求与代码库
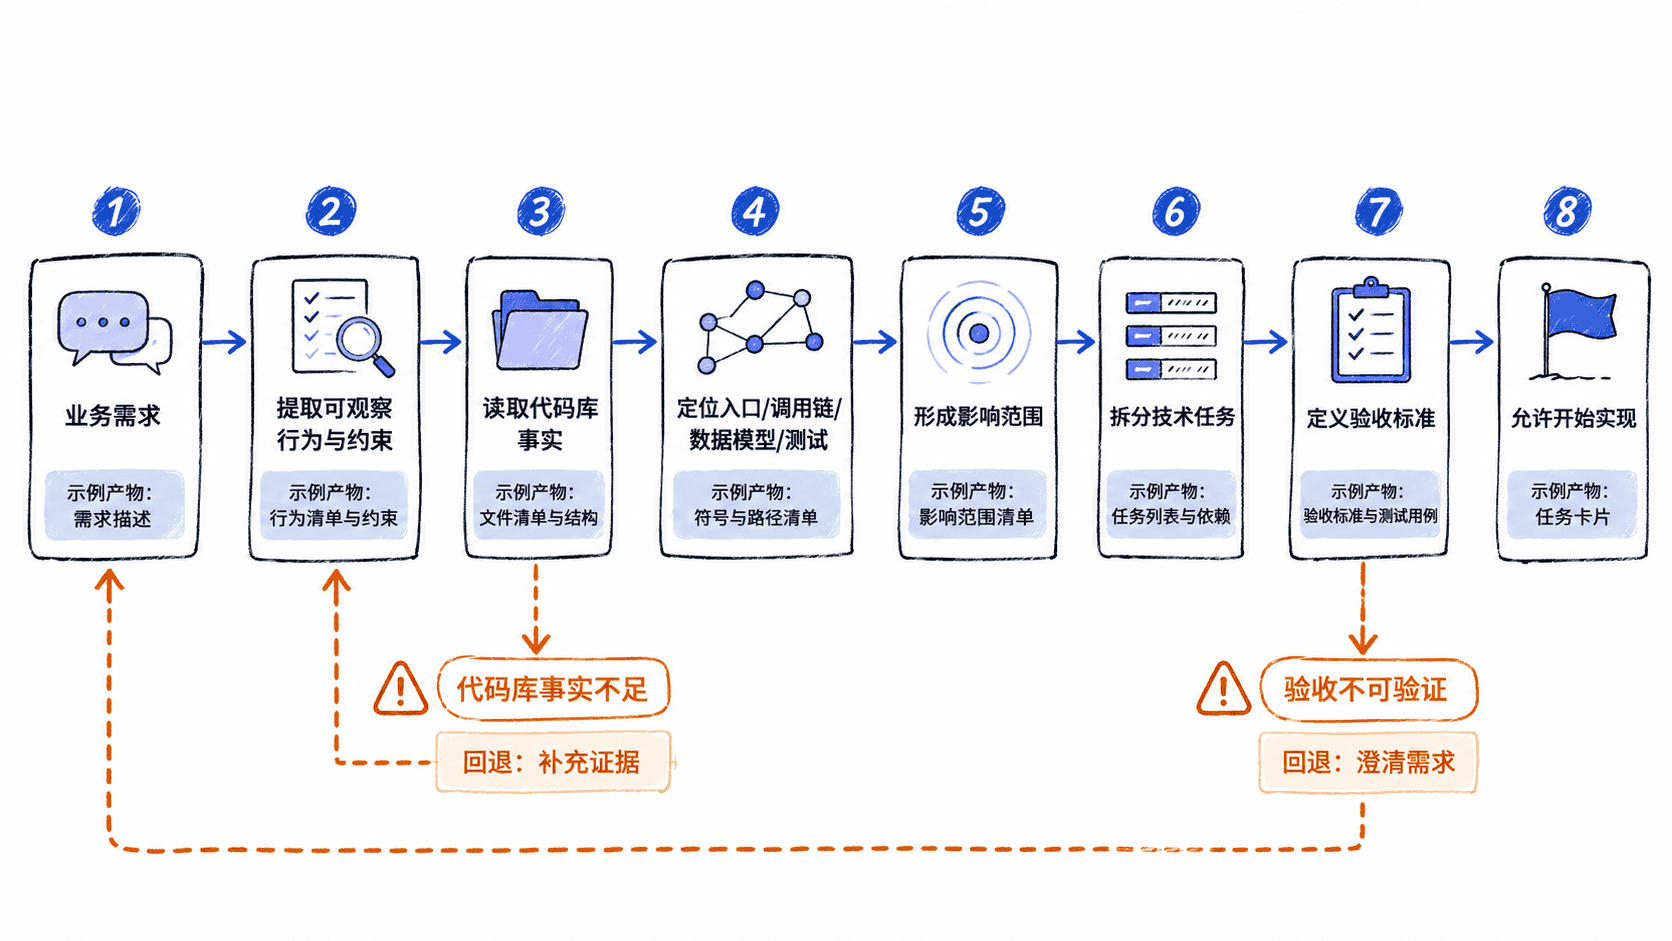
真正开始改代码之前,先把“业务想要什么”和“仓库现在是什么”对齐。本课给出一套可复用的分析方法:收集代码库证据、让 Codex 建立影响范围,再把模糊需求转换成可执行任务与可验证的验收标准。
学习目标
- 从业务描述中提取行为、约束与非目标
- 用代码库证据确认真实入口、依赖和测试边界
- 输出可执行的技术任务与可验证验收标准
先建立代码库事实
不要一上来就让 Codex“实现需求”。先确认仓库根目录、当前分支、受版本控制的文件规模和最近变更,让后续分析有明确上下文。下面这组命令不会修改仓库。
printf 'ROOT='; git rev-parse --show-toplevel
printf 'HEAD='; git rev-parse --abbrev-ref HEAD
printf 'TRACKED_FILES='; git ls-files | wc -l
git log -3 --oneline
预期输出
ROOT=<PATH>
HEAD=<VALUE>
TRACKED_FILES=<VALUE>
<ID> <VALUE>
<ID> <VALUE>
<ID> <VALUE><PATH>、提交 <ID>、分支名和文件数都会随仓库变化。若这些命令不能正常返回,先解决“当前目录不是目标 Git 仓库”或“历史信息不可用”的问题,再进入需求分析。
接着让 Codex 只做阅读与定位,不要立即编辑。一个有效的分析请求应同时给出业务需求和输出约束,例如:要求它列出相关入口文件、关键符号、调用链、现有测试以及仍需确认的问题,并明确“没有证据的推测必须标为待确认”。
把需求拆成行为、约束和证据
业务描述通常混合了目标与实现猜测。分析时先抽离“用户最终能观察到什么”,再检查代码库决定在哪里实现。可以把每项需求压缩成三类信息:
| 维度 | 要回答的问题 | 示例 |
|---|---|---|
| 行为 | 用户或调用方最终看到什么变化 | 任务可被取消,状态最终变为已取消 |
| 约束 | 哪些兼容性、安全或性能边界不能破坏 | 现有权限校验保持不变,重复取消必须幂等 |
| 证据 | 仓库中哪些文件、符号或测试支持这个判断 | 路由、任务状态模型、工作线程与集成测试 |
这样做可以防止把“业务要取消能力”直接等同于“新增一个接口”。也许仓库已经有取消入口,只缺状态传播;也可能真正的边界在后台工作线程。实现方案必须来自代码证据,而不是需求文字里的暗示。
让 Codex 先回答“在哪里改”
给 Codex 的第一轮任务应是影响分析,而不是实现。可以直接使用这样的约束:
只分析,不修改文件。先复述业务目标,再基于仓库证据列出相关入口文件、关键符号、主要调用链、数据结构、现有测试和潜在回归面。每个结论都附文件路径或符号依据;无法确认的内容标为“待确认”,最后给出按依赖顺序排列的技术任务草案。
分析结果要重点检查两件事:第一,文件和符号是否真的存在;第二,任务之间是否存在前置依赖。例如数据库状态先扩展,服务层才能传播新状态,接口层和测试才能稳定依赖它。若顺序反了,后续实现往往会反复返工。
把分析交付成可执行任务
一个技术任务应描述“改变什么边界”和“完成后如何验证”,而不是写成“优化相关代码”这类模糊动作。可以整理为下面的形式:
| 技术任务 | 代码证据 | 完成条件 |
|---|---|---|
| 扩展领域状态 | <PATH> 中的状态类型与转换逻辑 |
新状态可被合法创建并持久化 |
| 传播取消动作 | <PATH> 中的服务调用链 |
重复调用不产生额外副作用 |
| 补齐外部契约 | <PATH> 中的接口层 |
返回值和错误语义与需求一致 |
| 增加回归测试 | <PATH> 中的现有测试套件 |
正常、重复操作和失败路径均可验证 |
其中 <PATH> 必须在实际分析时替换为真实文件路径。若 Codex 只能给出“可能在 service 层”而没有证据,不要把它升级成正式任务;继续搜索代码库或向需求方确认。
验收标准必须能被证明
好的验收标准应描述可观察结果,并明确验证方式。例如“代码更清晰”无法验收,而“重复取消返回同一最终状态,且不会重复触发后台副作用”可以通过集成测试证明。验收至少覆盖主路径、关键边界和明确的非目标,避免实现过程中不断扩大范围。
在真正授权 Codex 修改文件前,应能回答:需求的可观察结果是什么、哪些模块会受影响、现有契约哪些不能破坏、需要新增或修改哪些测试、哪些问题仍待确认。只有这些答案都有仓库证据支撑,技术任务才算从“想法”变成了可执行的工程计划。