
AI Agent / 系统课时
协调并行智能体
协调并行智能体
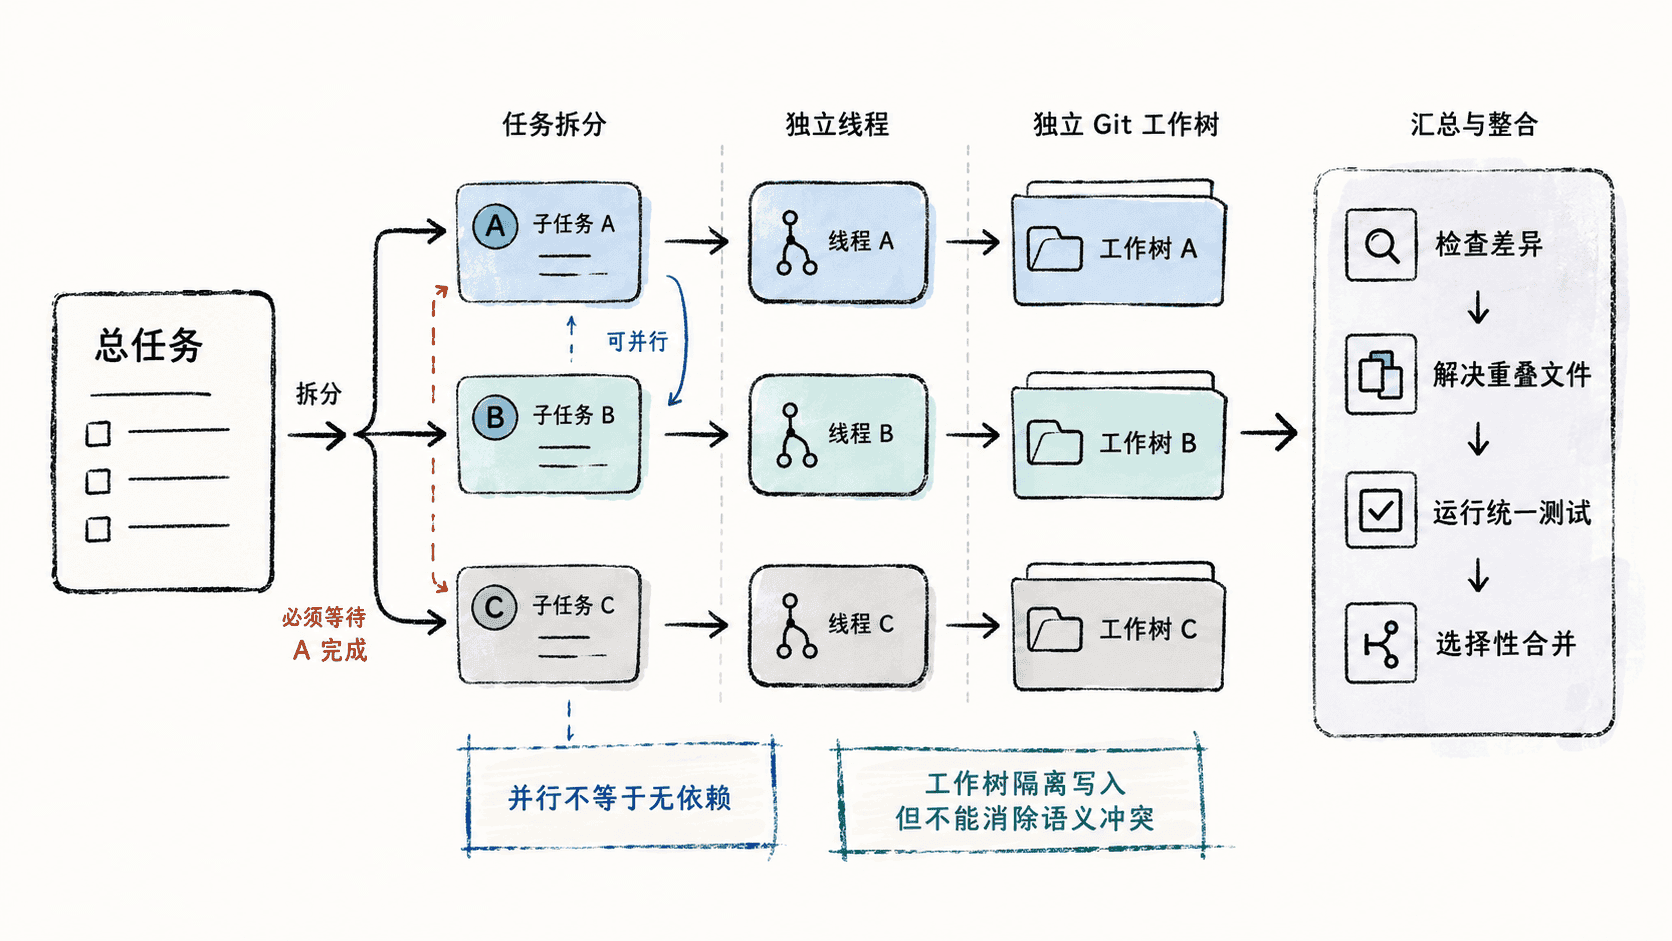
并行智能体的价值不在于“同时开更多窗口”,而在于把互不阻塞的工作拆到独立线程和工作树中,再用明确的依赖顺序、验收标准和合并规则收口。这样既能提升吞吐量,又不会让多个智能体反复覆盖同一批文件。
学习目标
- 能把一个较大的开发任务拆成适合并行执行的独立子任务
- 能用线程与工作树隔离修改,并识别任务之间的依赖关系
- 能在汇总前处理重叠文件、测试失败和语义冲突
先划清并行边界
适合并行的子任务应尽量满足两个条件:目标可以独立验收,修改范围少重叠。例如“补充 API 校验”“完善前端空状态”“增加单元测试”通常可以分别处理;而“先改数据库字段,再让接口适配新字段”存在先后依赖,不宜同时开工。
给每个智能体的任务说明至少写清目标、允许修改的目录、不能触碰的接口和完成条件。不要让两个线程都收到“重构用户模块”这类宽泛指令,否则即使工作树隔离了文件写入,最后仍可能产生大量语义冲突。
用独立线程和工作树隔离修改
在 Codex 桌面应用中,可以把不同子任务放进独立线程;对同一仓库并行修改时,让各线程使用隔离的工作树。工作树的作用是让每个智能体拥有自己的检出目录和 Git 状态,从而避免一个线程切换分支、暂存文件或重置修改时直接影响另一个线程。
工作树解决的是“本地状态互相踩踏”,不是“设计上互不冲突”。两个智能体仍可能分别修改同一个函数、同一份配置或同一数据库迁移。开始任务前就应减少这种重叠,而不是等最终合并时再处理。
可以在准备汇总时先确认当前仓库有哪些工作树以及各自分支:
git worktree list
git status --short --branch
预期输出
<PATH>                         <ID> [main]
<PATH>/<WORKTREE>              <ID> [<BRANCH>]
## <BRANCH>
实际路径、提交 ID 和分支名会不同;重点是确认每个并行任务仍位于预期工作树和分支,没有把修改落到错误位置。
先处理依赖,再处理冲突
当一个子任务依赖另一个子任务的接口或数据结构时,先让上游任务达到可验收状态,再把它的结果作为下游线程的新前提。不要让下游智能体基于猜测继续实现,否则最后得到的往往不是 Git 冲突,而是“代码能合并、行为却不一致”的语义冲突。
汇总时按固定顺序检查:先看每个线程的差异是否只覆盖约定范围,再确认依赖任务已经完成,然后处理重叠文件,最后运行仓库统一的测试和静态检查。若两个实现都可行,先根据原任务验收标准选择一个主实现,再把另一份中真正有价值的部分手工迁入,避免机械地把两边全部保留。
用统一验收门槛收口
并行任务完成后,不要以“各线程都说完成了”作为结束条件。最终工作树需要重新运行能覆盖组合行为的测试,因为单个子任务在自己的上下文中通过,并不代表合并后的整体仍然正确。
如果汇总后出现失败,先判断是接口依赖未同步、同一文件的修改被覆盖,还是两个实现各自改变了同一个隐含约束。只修复能够解释失败原因的差异,并重新验证。并行智能体真正提高效率的前提,是把“拆分—隔离—依赖—合并—统一验证”当成一个完整流程,而不是单纯增加同时运行的线程数量。