
服务注册与分布式协调 / 系统课时
排查配置更新不自动生效
排查配置更新不自动生效
配置中心里已经发布新值,但应用仍返回旧值时,不要直接归因于“缓存”。最有效的做法是沿 发布对象 → 客户端订阅 → 刷新事件 → Bean 实际取值 逐段验证,先确认新配置是否真的到达进程,再判断是否卡在对象生命周期或业务缓存。
学习目标
- 能按 Data ID、Group、Namespace 核对应用实际订阅的配置对象
- 能根据客户端日志与运行时取值判断问题停在监听、刷新还是 Bean 生命周期
- 能修复常见的静态字段、初始化副本和未进入刷新作用域导致的旧值问题
先把故障链拆开
一次“发布成功但应用值不变”至少经过四个环节:Nacos 服务端保存新值,客户端订阅到对应配置,框架把变化传播到 Spring 环境,业务 Bean 再从可刷新的来源读取新值。前一段正常,不代表后一段也正常。
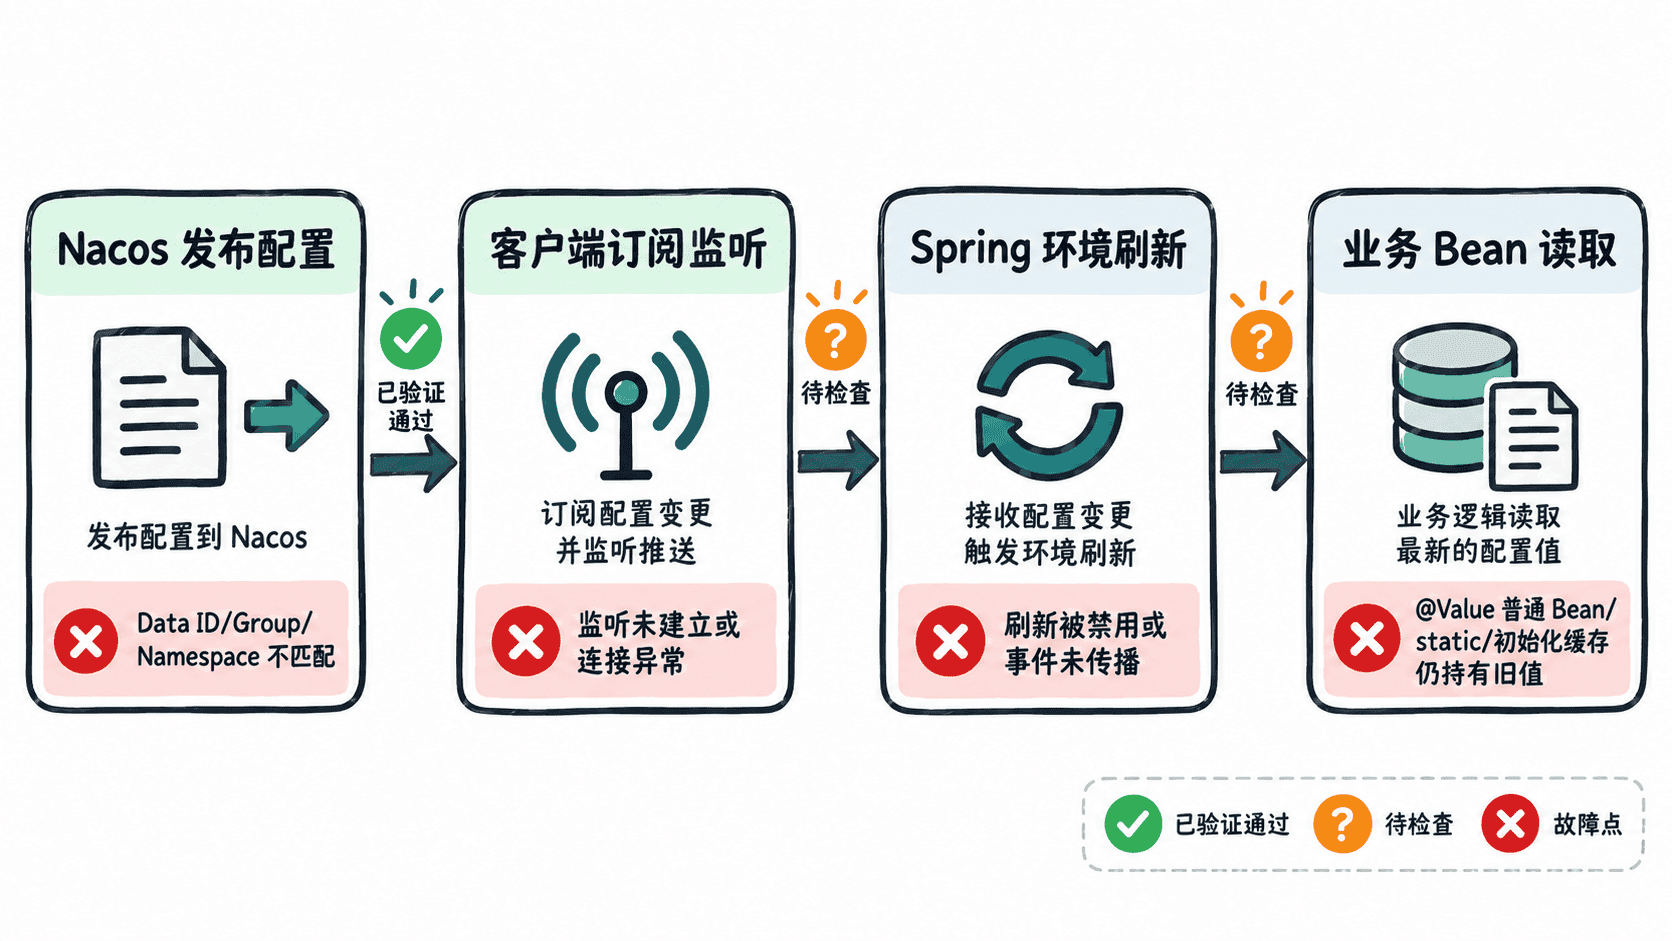
排查时只问一个问题:新值最远走到了哪一层? 这样可以避免一上来就重启服务,把真正的监听或 Bean 设计问题掩盖掉。
确认服务端发布对象和内容
先用 OpenAPI 读取应用应该订阅的同一份配置。dataId、group、tenant 必须与应用配置完全一致;其中 tenant 对应 Namespace ID,而不是控制台里看到的显示名称。若启用了鉴权,还要按当前部署补上访问令牌。
curl -sS -G "http://<HOST>:<PORT>/nacos/v1/cs/configs" --data-urlencode "dataId=<DATA_ID>" --data-urlencode "group=<GROUP>" --data-urlencode "tenant=<NAMESPACE_ID>"预期输出:
<当前已发布的配置正文>如果这里已经是旧值,问题仍在发布侧,应先检查是否发布到了错误的 Group、Namespace 或 Data ID。只有服务端读到新值后,才有必要继续查客户端。
检查客户端是否真的在监听
接着在应用日志中定位该 Data ID 的订阅、变更和刷新记录。不同版本的日志文本会有差异,因此不要只搜固定一句话,而要同时带上 Nacos、目标 Data ID 和刷新相关关键词。
grep -Ei "nacos|<DATA_ID>|refresh|listener|config" <LOG_FILE> | tail -n 80预期输出:
<TIME> ... <DATA_ID> ... listener/subscription ...
<TIME> ... <DATA_ID> ... refresh/change ...
实际字段和措辞会随客户端版本变化。若发布后完全没有目标 Data ID 的监听或变更记录,优先检查配置导入是否生效、Group/Namespace/Profile 是否一致、刷新能力是否被显式关闭,以及应用到 Nacos 的网络与鉴权是否正常。若日志已经明确收到变更,则故障范围可以缩小到 Spring 刷新和 Bean 取值。
区分环境已更新和 Bean 已更新
最容易误判的是:配置源已经更新,但业务代码仍读取初始化时保存的副本。下面几种写法尤其需要检查:
@Value注入到普通单例 Bean 后,又在初始化阶段复制到另一个字段- 把配置放进
static字段、手工单例或本地缓存 - 构造函数中计算一次派生值,后续请求只读派生结果
- 使用需要刷新作用域的注入方式,却没有让该 Bean 重新创建或重新绑定
如果项目采用 Spring Cloud 的刷新机制,通常应让需要重新实例化的 Bean 进入 @RefreshScope,或直接使用支持重新绑定的配置对象;不要期待框架自动修改任意 Java 字段,更不要把动态配置复制成静态状态。
修复后做一次闭环验证
修复后重新发布一个容易识别的测试值,先确认 Nacos OpenAPI 返回新内容,再观察客户端出现该 Data ID 的变更记录,最后通过应用真实业务接口验证运行时值已经变化。若应用提供专用的配置诊断接口,可直接请求它;不要只看启动日志。
curl -sS "http://<APP_HOST>:<APP_PORT>/<CONFIG_CHECK_PATH>"预期输出:
<应用当前实际读取到的新配置值>其中 <CONFIG_CHECK_PATH> 应替换为项目已有的只读验证接口,实际返回格式以应用为准。只有“服务端新值、客户端收到变更、业务接口读到新值”三项同时成立,才算自动刷新链路真正恢复。