
Linux 与服务器运维 / 系统课时
先做一遍服务器健康检查
先做一遍服务器健康检查
面对一台“好像有点慢”的 Linux 服务器,最容易犯的错是直接盯着某个进程猜原因。本篇给出一套可重复的基础巡检顺序:先确认主机和时间,再看 CPU、内存、磁盘、进程、服务与监听端口,最后把异常收敛到可继续排查的范围。
学习目标
- 按固定顺序完成一次不改动系统状态的基础巡检
- 能从 CPU、内存、磁盘和进程指标中识别明显异常
- 能把服务状态与监听端口对应起来,避免只看“服务已启动”
先固定巡检顺序
基础巡检的价值不在于命令多,而在于顺序稳定。先确认“查的是哪台机器、什么时间”,再判断资源是否紧张,最后检查具体进程和服务。这样既减少遗漏,也方便把两次巡检结果做对比。
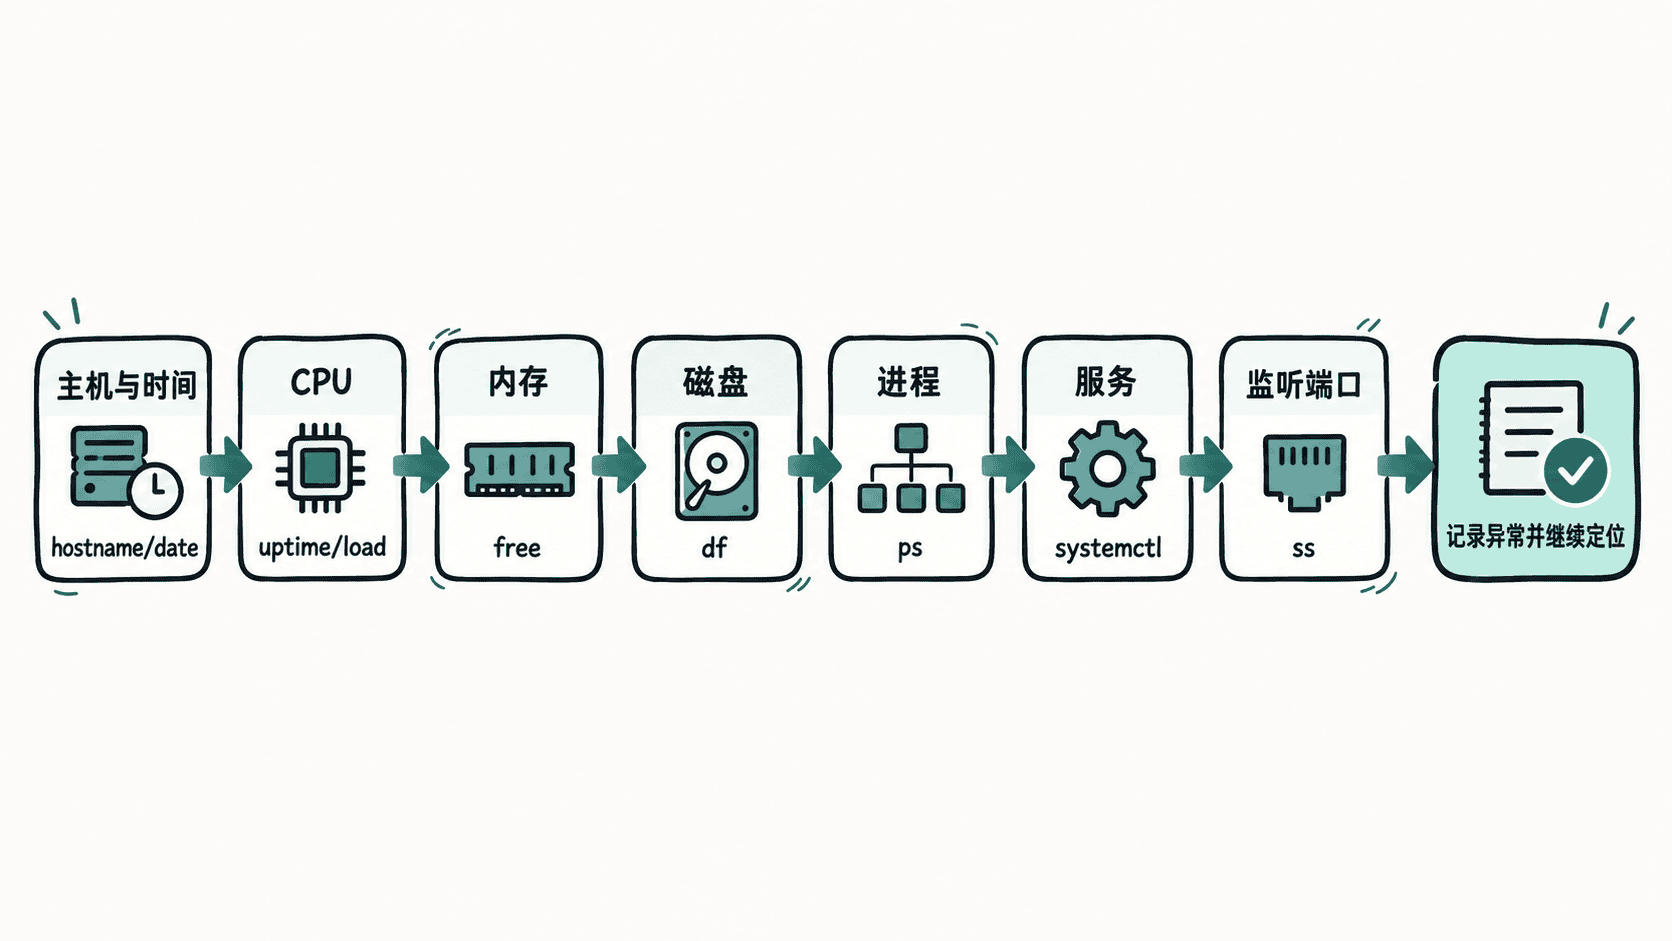
这里的原则是先做只读检查,不在证据不足时重启服务、清理文件或终止进程。任何会改变现场的操作,都应放到定位根因之后。
运行一组只读检查
下面的命令都可直接在常见 Linux 发行版上执行。systemctl 适用于 systemd 系统;如果系统不是 systemd,需要换用对应的服务管理工具。
hostname
date
uptime
free -h
df -hT
ps -eo pid,ppid,user,%cpu,%mem,stat,comm --sort=-%cpu | head -n 8
systemctl --failed --no-pager
ss -lntup
预期输出
<HOST>
<TIME>
<TIME> up <UPTIME>, <USERS> users, load average: <LOAD1>, <LOAD5>, <LOAD15>
               total        used        free      shared  buff/cache   available
Mem:           <SIZE>      <SIZE>      <SIZE>      <SIZE>      <SIZE>      <SIZE>
Swap:          <SIZE>      <SIZE>      <SIZE>
Filesystem     Type  Size  Used Avail Use% Mounted on
<DEVICE>       <TYPE> <SIZE> <SIZE> <SIZE> <PERCENT> /
    PID    PPID USER     %CPU %MEM STAT COMMAND
   <PID>  <PPID> <USER>  <CPU> <MEM> <STAT> <COMMAND>
  UNIT LOAD ACTIVE SUB DESCRIPTION
<FAILED-UNITS-OR-NONE>
Netid State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
tcp   LISTEN 0      <N>    <IP>:<PORT>       0.0.0.0:*       users:(("<PROCESS>",pid=<PID>,fd=<ID>))
主机名、时间、负载、容量、进程 ID、端口等都会因环境而不同,因此这里用占位符表示。真正巡检时应保存原始输出,尤其要注意时间是否正确,否则后续日志时间线可能整体错位。
先判断资源是否真的异常
uptime 的 load average 不是 CPU 使用率,它表示一段时间内处于可运行或不可中断状态的任务数量。判断是否异常时,要结合 CPU 核数、持续时间和进程状态,而不是看到一个大于 1 的数字就下结论。
free -h 重点看 available,不要只盯着 free。Linux 会主动用内存做缓存,缓存高不等于内存泄漏。如果 available 持续很低,同时 Swap 大量使用且系统明显变慢,才更值得继续追查。
df -hT 用来判断文件系统容量,重点关注根分区、日志所在分区和业务数据分区。若使用率逼近上限,应立即转入磁盘专项排查,而不是先删“看起来没用”的文件。
用进程把异常落到具体对象
资源异常最终通常要落到某个进程。上面的 ps 已按 CPU 从高到低排序;若怀疑内存,可以改成按 %mem 排序。
ps -eo pid,ppid,user,%cpu,%mem,stat,comm --sort=-%mem | head -n 8预期输出
    PID    PPID USER     %CPU %MEM STAT COMMAND
   <PID>  <PPID> <USER>  <CPU> <MEM> <STAT> <COMMAND>
如果某个进程长期占用大量资源,下一步再查看它的启动参数、父进程、日志和对应服务。不要因为一次采样很高就直接 kill -9;瞬时峰值、备份、压缩、日志轮转都可能短暂抬高 CPU 或 I/O。
把服务状态和端口对应起来
systemctl --failed 能快速列出启动失败或进入 failed 状态的 unit,但“没有 failed unit”不代表业务一定正常。一个服务可能处于 active 状态,却没有监听期望端口,也可能监听了端口但绑定在错误地址。
因此应把服务与端口一起核对:先确认服务状态,再用 ss -lntup 看进程是否真的监听在期望的 <IP>:<PORT>。如果端口不存在,再继续检查服务日志、配置文件和启动参数。
完成这套巡检后,你至少应该能回答三件事:机器身份和时间是否正确、资源瓶颈落在哪一类、异常是否已经收敛到某个进程或服务。只有到这一步,后续重启、扩容、清理或修改配置才有足够证据支撑。