
游戏客户端架构 / 系统课时
一套跨引擎配置层怎么抽象
一套跨引擎配置层怎么抽象
当项目同时面向不同引擎时,真正值得复用的不是某个引擎的资源对象,而是配置的结构、字段语义、校验规则和读取约定。本节把这些稳定部分抽成一层配置内核,再把 Unity、Unreal、Godot 等差异限制在薄适配层中。
学习目标
- 区分跨引擎可复用的配置契约与必须留在引擎侧的实现细节
- 用统一中间模型承载表结构、数据语义和校验规则
- 设计不依赖具体引擎类型的运行时读取接口
先分清哪些东西值得跨引擎复用
跨引擎配置层最容易犯的错误,是试图统一所有东西。资源句柄、对象生命周期、热更新机制、编辑器资产格式都强依赖引擎;如果把它们塞进公共层,公共层最终会变成大量条件分支。
真正适合抽象的是四类稳定信息:字段结构、字段语义、约束规则、业务读取方式。例如角色的 hp 表示基础生命值,必须大于 0;skillIds 是技能 ID 列表,必须引用已存在的技能。这些规则和角色当前运行在哪个引擎无关。
相反,贴图怎样加载、资源包怎样寻址、对象怎样实例化,不应该进入公共配置契约。公共层只保存资源逻辑标识,例如 iconId,再由引擎适配器把它转换成真正可用的资源对象。
用四层抽象隔离引擎差异
一套可维护的跨引擎方案可以拆成四层:源数据层负责表格或策划数据,中间模型层负责统一字段与类型,校验层负责约束和引用检查,运行时接口层只暴露业务查询。最外侧再由不同引擎提供各自适配器。
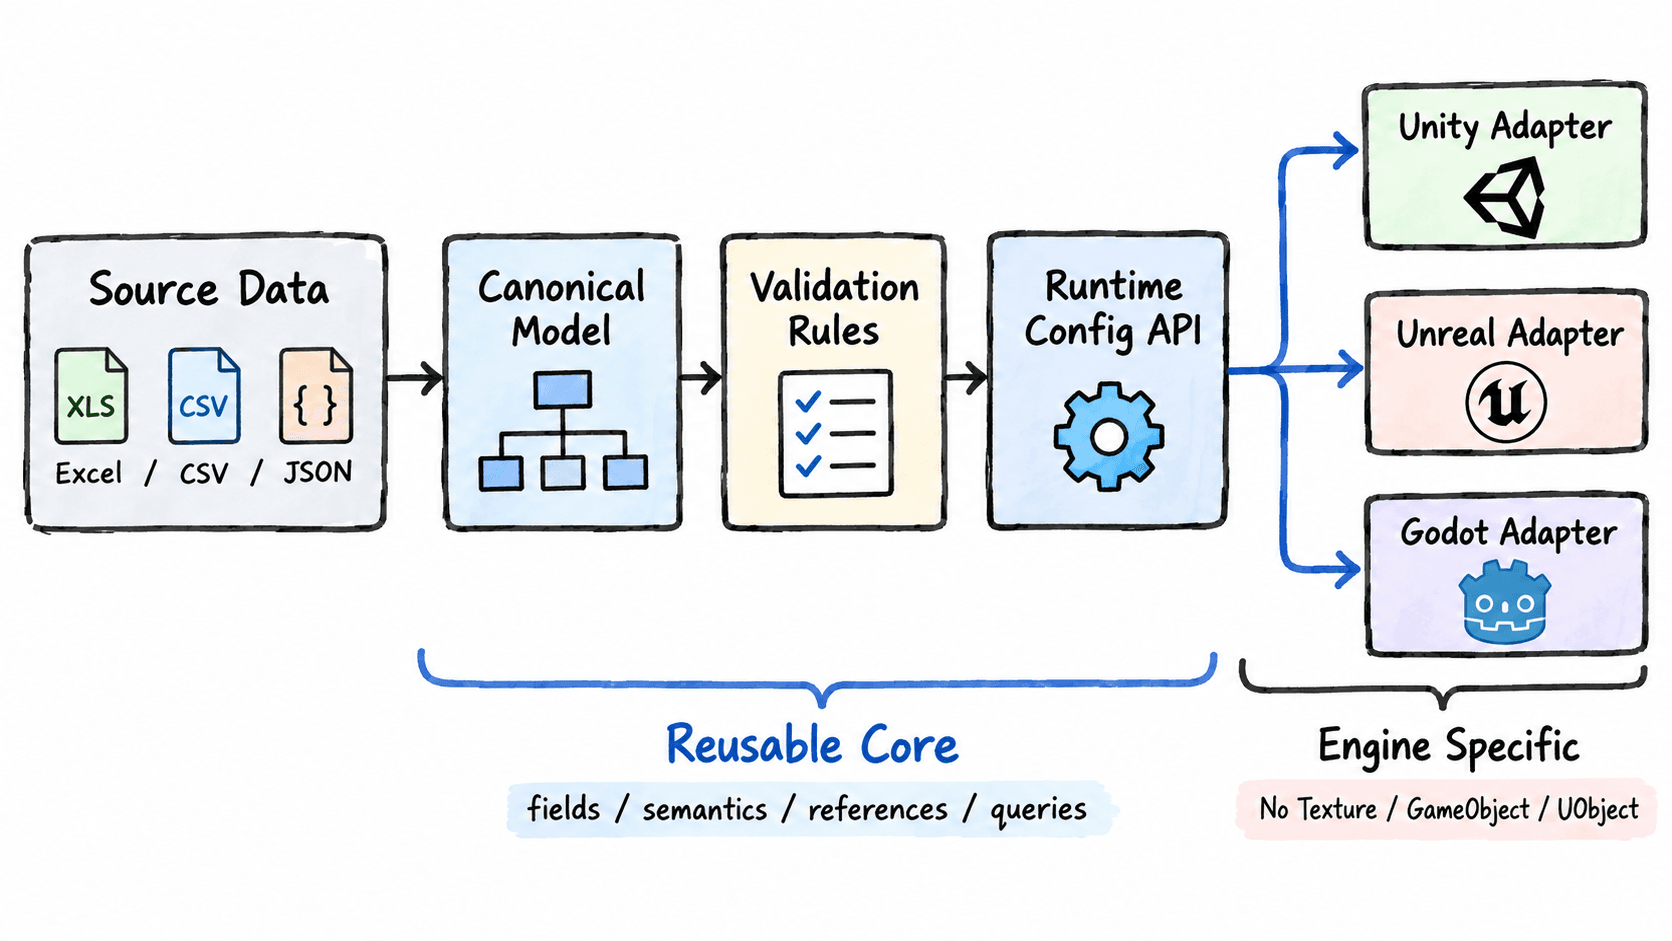
这个结构的关键不是支持多少引擎,而是依赖方向:公共内核永远不能反向依赖某个引擎 SDK。引擎适配层可以依赖公共内核,但公共内核只认识普通值、ID、集合和业务接口。
定义稳定的数据契约
跨引擎数据最好先落到一个与引擎无关的发布格式。下面的 JSON 是发布后的角色记录示例,不包含任何引擎专有类型。
{
  "id": "hero_001",
  "hp": 1200,
  "moveSpeed": 4.5,
  "skillIds": ["skill_slash", "skill_dash"],
  "iconId": "icon_hero_001"
}
这份契约至少要明确三类规则。第一类是类型规则,例如 hp 必须是整数;第二类是范围规则,例如 moveSpeed 必须大于 0;第三类是引用规则,例如 skillIds 中每个值必须能在技能表中找到。
配置文件本身不要求产生控制台输出。验证方法是在导入或构建阶段对整包数据执行类型、范围和外键检查;只有全部通过的数据才进入可发布快照。
运行时接口只暴露业务语义
运行时公共接口也不应该返回引擎资源对象。下面用 Java 表达一个最小接口;其他语言可以实现相同语义。
import java.util.List;
import java.util.Optional;

record RoleConfig(
        String id,
        int hp,
        double moveSpeed,
        List<String> skillIds,
        String iconId) {
}

interface RoleConfigRepository {
    Optional<RoleConfig> findById(String roleId);
}
这段接口是片段示例:它只定义跨引擎公共层的业务契约,实际项目还需要具体的数据反序列化与仓库实现。生效行为是调用方只能通过角色 ID 获得普通配置值;至于数据来自本地二进制包、JSON、远端缓存还是热更新快照,由各引擎或平台实现决定。
这样设计后,战斗逻辑依赖的是 RoleConfigRepository,而不是某个引擎的资产数据库。单元测试也可以直接替换仓库实现,不需要启动完整引擎环境。
如何落到不同引擎
跨引擎层不需要负责最后一公里。每个引擎只做三件事:把发布快照读进内存、实现公共仓库接口、把逻辑资源 ID 解析成引擎对象。引擎切换时,公共数据契约、校验器和业务读取代码可以保持不变。
判断抽象是否健康,可以看一个简单指标:新增一个引擎时,如果必须修改大量公共字段定义和业务规则,说明引擎细节已经泄漏进核心层;如果主要工作集中在加载器和资源解析适配器,边界就是稳定的。