
游戏客户端架构 / 系统课时
导入失败怎样给出可定位错误
导入失败怎样给出可定位错误
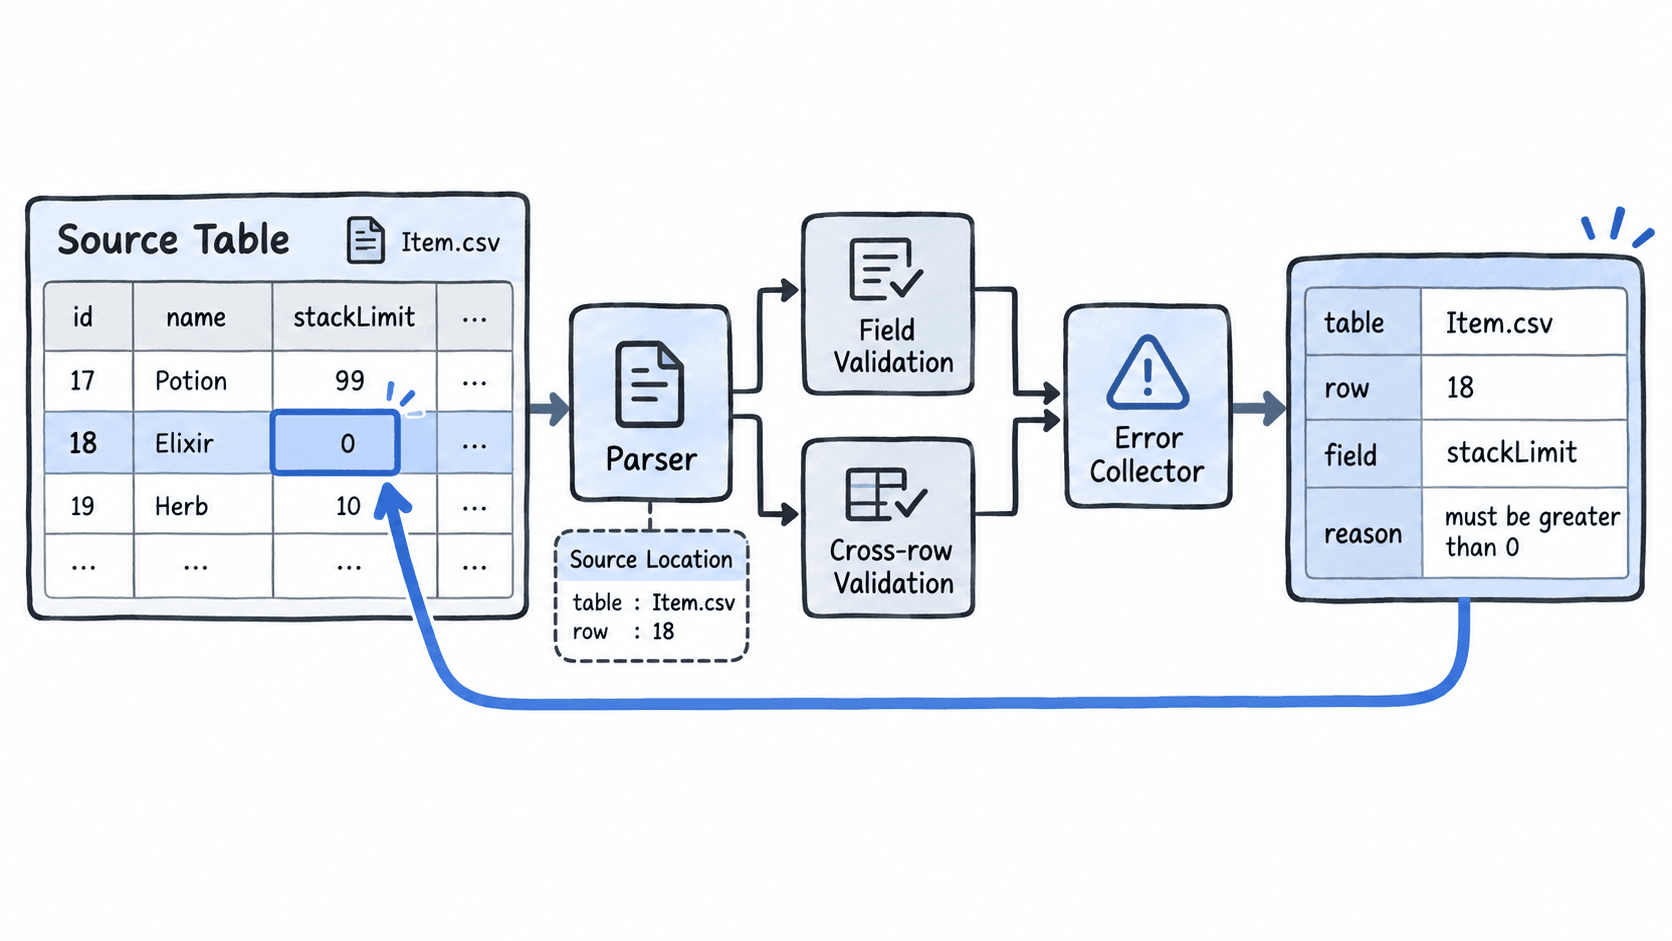
配置导入最怕“失败了,但不知道哪一格错了”。本节把错误设计成可定位的数据:至少包含表名、行号、字段和原因,并让校验器统一收集后输出,目标是让策划或程序看到错误后直接回到原始配置修正,而不是反复猜测。
学习目标
- 设计一条包含表名、行号、字段和原因的错误信息
- 区分解析错误、字段校验错误和跨行校验错误
- 实现可批量收集且便于定位的导入校验结果
错误信息要回答四个问题
一条有效的导入错误,至少要回答“哪张表、哪一行、哪个字段、为什么错”。只写 invalid config、parse failed 或抛出原始异常,都把定位成本转嫁给使用者。
例如,道具表第 18 行的 stackLimit 填成 0,错误应尽量接近下面这种形式:
Item.xlsx row=18 field=stackLimit: must be greater than 0, actual=0这类信息可以直接映射回源表。表名用于定位文件,行号用于定位记录,字段名用于定位列,原因用于说明修复方向。
还要注意“行号”通常应该指用户看到的原始表格行号,而不是程序解析后的数组下标。若首行为表头,程序内部第 0 条数据可能对应 Excel 第 2 行,错误对象中应保存原始来源位置。
把错误位置做成结构化数据
不要在每个校验点手工拼字符串。更稳妥的方式是让解析阶段先保留来源位置,再由统一错误类型负责格式化。
下面示例使用 Python 模拟 CSV 配置导入。它会检查 itemId 是否为空、stackLimit 是否为正整数,并一次收集全部错误。
from dataclasses import dataclass
import csv
from io import StringIO

@dataclass
class ConfigError:
    table: str
    row: int
    field: str
    reason: str

    def __str__(self) -> str:
        return f"{self.table} row={self.row} field={self.field}: {self.reason}"

def validate_items(csv_text: str, table_name: str) -> list[ConfigError]:
    errors: list[ConfigError] = []
    reader = csv.DictReader(StringIO(csv_text))

    for row_number, row in enumerate(reader, start=2):
        item_id = (row.get("itemId") or "").strip()
        stack_limit_raw = (row.get("stackLimit") or "").strip()

        if not item_id:
            errors.append(
                ConfigError(table_name, row_number, "itemId", "must not be empty")
            )

        try:
            stack_limit = int(stack_limit_raw)
            if stack_limit <= 0:
                errors.append(
                    ConfigError(
                        table_name,
                        row_number,
                        "stackLimit",
                        f"must be greater than 0, actual={stack_limit}",
                    )
                )
        except ValueError:
            errors.append(
                ConfigError(
                    table_name,
                    row_number,
                    "stackLimit",
                    f"must be an integer, actual={stack_limit_raw!r}",
                )
            )

    return errors

source = '''itemId,name,stackLimit
potion_small,Small Potion,20
,Large Potion,10
bomb,Bomb,0
arrow,Arrow,abc
'''

for error in validate_items(source, "Item.csv"):
    print(error)
预期输出:
Item.csv row=3 field=itemId: must not be empty
Item.csv row=4 field=stackLimit: must be greater than 0, actual=0
Item.csv row=5 field=stackLimit: must be an integer, actual='abc'
这里没有“遇到第一处错误就退出”,因为配置导入通常属于离线工具链。一次把同一张表中的问题尽量收集全,修改者就能一轮修完,减少“修一处、再导入、再遇到下一处”的往返。
分清错误发生在哪一层
导入链路里常见的错误至少有三层,位置字段的含义并不完全相同。
解析错误发生在字符串转类型时,例如 stackLimit=abc 无法转成整数。此时可以明确给出表、行、字段和原始值。
字段校验错误发生在值已经成功解析后,例如 stackLimit=0 虽然是整数,却违反“必须大于 0”的业务规则。
跨行或跨表错误需要额外上下文,例如重复 itemId、掉落表引用了不存在的道具。此时仍应尽量保留当前记录的位置,并在原因中指出冲突对象。
例如重复键可以写成:
Item.csv row=27 field=itemId: duplicate value 'bomb', first defined at row=12这种表达同时给出“当前错误位置”和“关联位置”,比只说 duplicate id 更容易修。
错误输出既要给人看,也要方便工具处理
如果导入器只在终端打印字符串,短期足够,但后续接入 CI、编辑器或后台时会很难复用。更稳妥的做法是内部保留结构化错误对象,最后再按不同场景转换为文本、JSON 或界面提示。
字段通常可以保持精简:
| 字段 | 作用 |
|---|---|
table |
原始配置文件或逻辑表名 |
row |
用户可见的源数据行号 |
field |
出错字段;跨表错误也应尽量给出当前字段 |
reason |
可直接指导修改的原因 |
reason 不要塞堆栈信息,也不要只复述异常类型。像 ValueError、NullReference 这类程序内部信息适合日志,不适合直接给配置使用者。对外错误应该说明“数据为什么不合法”,内部日志再保留异常和调用栈。
最终判断标准很简单:拿到一条错误后,使用者不需要重新跑调试器,也不需要搜索整张表,就能直接定位到原始数据并知道应该改什么。