
游戏客户端架构 / 系统课时
大批量数值修改如何降低风险
大批量数值修改如何降低风险
一次改几十个甚至几百个数值时,真正危险的不是“手工改错一格”,而是修改范围过大后没人能快速看出异常。本节把批量改表拆成可审计流程:先生成变更、再看差异、做规则校验、保存版本记录,最后才发布,并保证能一键回到上一个稳定版本。
学习目标
- 把批量编辑变成可预览、可校验、可追踪的变更
- 用差异阈值和规则检查提前发现异常修改
- 设计能可靠回滚的版本记录,而不是靠人工记忆恢复
批量修改先生成候选结果
批量操作不要直接覆盖正式配置。正确顺序是先基于稳定版本生成候选结果,再比较“改前”和“改后”。例如全体武器伤害提升 8%,系统应生成一份新版本,而不是在原文件上原地保存。
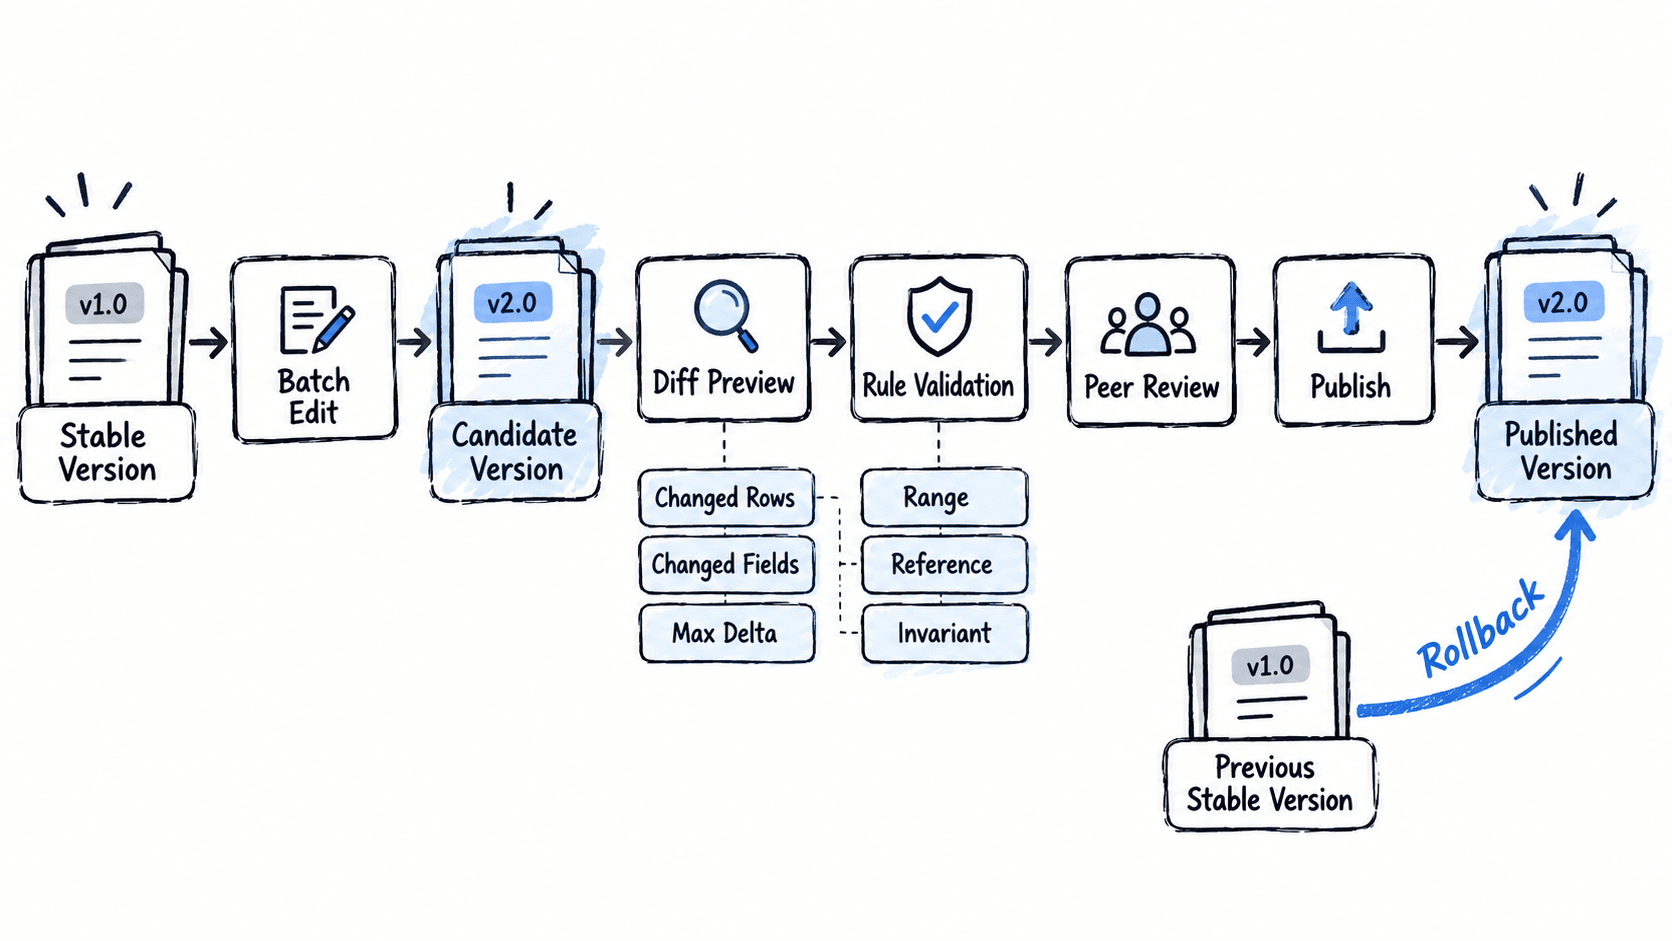
候选版本必须保留来源信息:基于哪个稳定版本生成、用了什么批量规则、修改了多少行、由谁发起。这样差异检查发现问题时,可以直接重跑,而不是继续在已经污染的数据上修补。
用差异阈值拦截异常
下面的 Python 示例模拟“所有武器伤害提高 8%”,同时计算每一项的变化比例。如果任何单项变化超过允许阈值,发布流程就中止。这个思路适用于表格工具、配置后台或 CI 校验脚本。
items = [
    {"id": "sword", "damage": 100},
    {"id": "bow", "damage": 80},
    {"id": "staff", "damage": 120},
]

MAX_CHANGE_RATIO = 0.10
MULTIPLIER = 1.08

candidate = []
for item in items:
    new_damage = round(item["damage"] * MULTIPLIER)
    ratio = abs(new_damage - item["damage"]) / item["damage"]
    if ratio > MAX_CHANGE_RATIO:
        raise ValueError(f'{item["id"]} change ratio is too large')
    candidate.append({**item, "damage": new_damage})
    print(f'{item["id"]}: {item["damage"]} -> {new_damage} ({ratio:.1%})')
预期输出
sword: 100 -> 108 (8.0%)
bow: 80 -> 86 (7.5%)
staff: 120 -> 130 (8.3%)
这里的 10% 只是示例阈值,真实项目应按字段风险定义。角色移动速度变化 10% 可能已经非常明显,而某些经验值曲线调整 10% 可能属于日常运营范围。阈值应服务于风险识别,而不是统一套一个数字。
差异检查要看什么
大批量修改至少检查三个维度:修改了多少行、修改了哪些字段、单项变化有多大。若本来只想调伤害,却同时出现价格、稀有度或引用 ID 的变化,应直接阻止发布。
对配置表而言,差异视图比“最终表长什么样”更重要。审核者应该先看到新增、删除、修改,再按风险排序查看变化最大的记录。这样几百行变更也能在短时间内发现不符合预期的部分。
回滚依赖不可变版本
可靠回滚的前提是每次发布都形成独立版本,并且旧版本不会被覆盖。生产环境只记录当前指向哪个版本;出现问题时,把指针切回上一个已验证版本即可。
如果团队仍然采用“覆盖同一个 Excel 文件,再靠聊天记录找历史附件”的方式,就没有真正的回滚能力。版本号、生成记录、审核记录和发布时间至少要能关联到同一批变更。
批量修改最值得建立的习惯是:先生成候选版本,再审差异,最后发布;发布后永远保留上一个稳定版本。 这样即使一次调整涉及数百条配置,风险也能被拆解成可检查、可阻断、可恢复的工程步骤。