
游戏客户端架构 / 系统课时
导入产物为什么要可重复生成
导入产物为什么要可重复生成
配置导入不是“生成一次文件就结束”,而是一个可以反复执行的构建过程。同一份源码配置、同一版导入器和同一组参数,应得到等价产物;这样生成文件、缓存和中间文件才能被安全删除并重建,也能避免人工改产物造成环境漂移。
学习目标
- 理解配置源码、生成产物与缓存之间的边界
- 识别会破坏重复生成的时间戳、随机值和手工修改
- 用一次可复现构建验证导入链路是否稳定
先划清三类文件的职责
数据驱动项目里,最容易混乱的是把“源数据”和“生成结果”同时当成可编辑内容。建议把文件分成三类。
源码配置是唯一人工维护的事实来源,例如策划提交的 CSV、JSON 或表格导出文件。它应该进入版本管理,并接受评审。
生成产物由导入器根据源码配置生成,例如二进制资源、运行时 JSON、代码常量或索引文件。它是否提交版本库取决于团队流程,但不能把手工修改当成正式修改方式。
缓存和中间产物只为加速构建或保存临时状态,例如解析缓存、哈希索引、临时目录。它们必须允许删除;删除后重新执行导入,最终产物仍应一致。
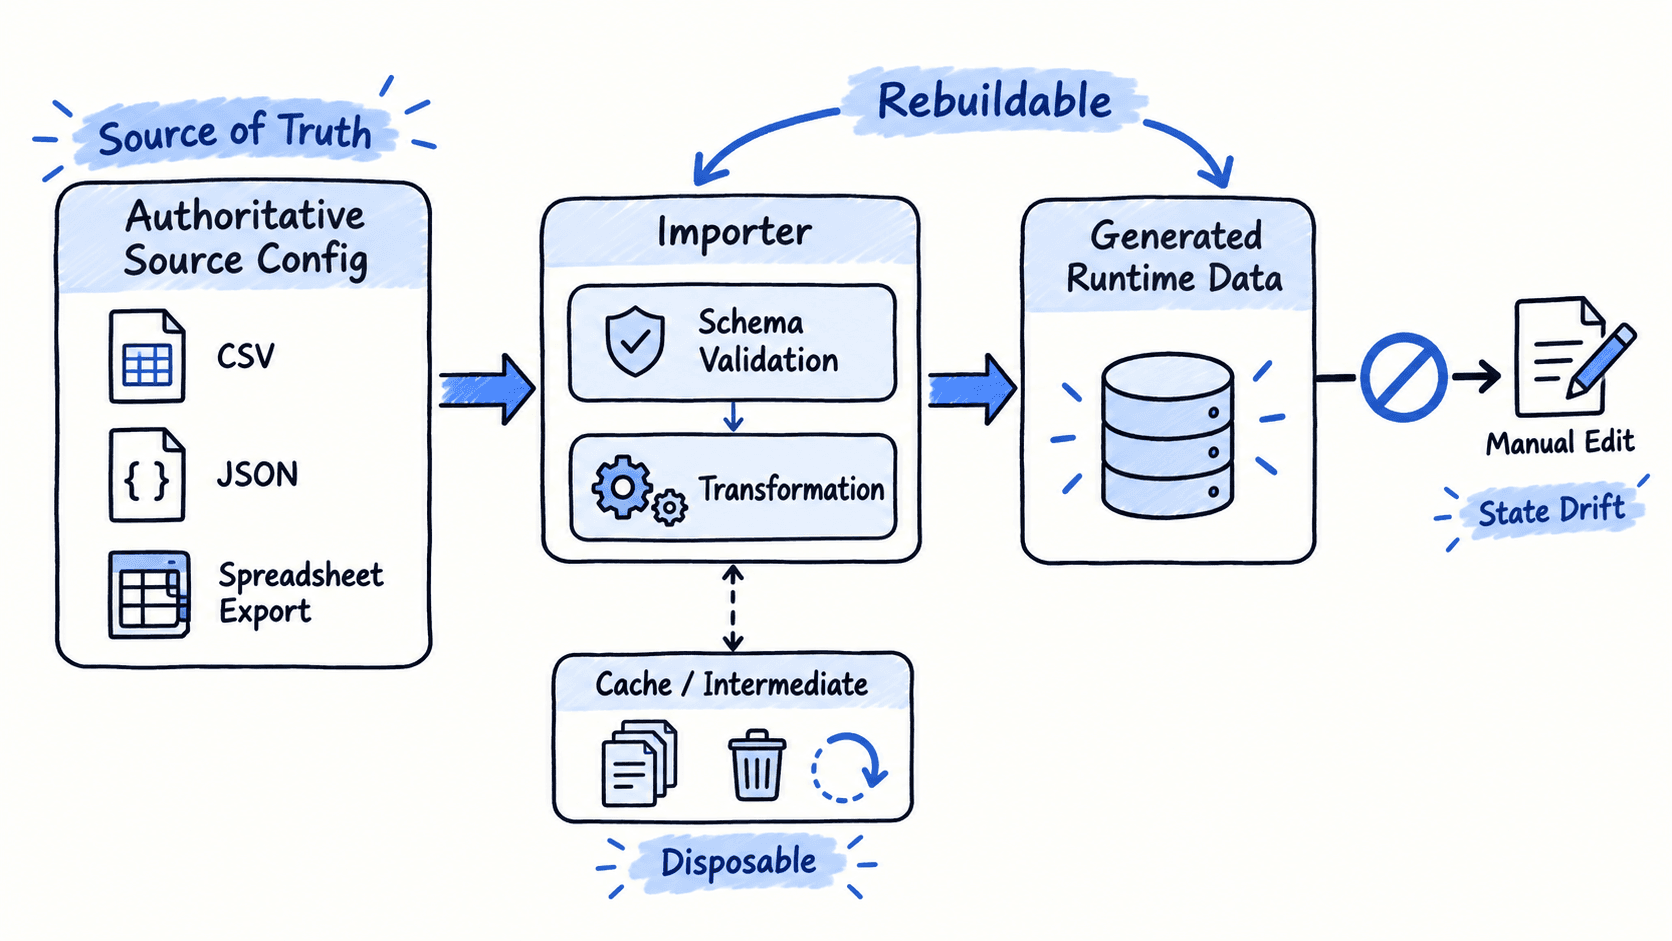
关键边界只有一句话:真正的业务修改必须回到源码配置或导入规则,不能直接改生成产物。
重复生成为什么会失效
即使输入文件没变,下面几种实现仍会让每次构建产生不同结果。
第一类是把当前时间写进产物正文,例如 generatedAt=2026-10-08T03:00:00。这种字段会导致每次生成都产生无意义差异。
第二类是遍历无稳定顺序的集合后直接序列化。只要输出顺序不确定,同一批记录就可能在不同运行之间换位。
第三类是生成随机 ID、临时绝对路径或机器相关信息。它们都会把“当前运行环境”混进业务产物。
第四类是人工修改生成文件。下一次导入时,修改可能被覆盖;如果某些机器没有重新生成,又会出现“同一个提交,不同环境行为不同”的状态漂移。
因此,导入器应尽量保证:稳定排序、稳定字段格式、稳定编码,并把时间戳等非业务元数据放到不会参与内容比较的位置,或干脆不写入运行时产物。
用哈希验证两次生成是否一致
验证重复生成不需要复杂基础设施。最直接的方法是清理输出目录,连续生成两次,然后比较产物哈希。
下面脚本用 Python 生成一个稳定排序的 JSON 文件,并连续执行两次比较 SHA-256。
import hashlib
import json
from pathlib import Path

OUTPUT = Path("build/items.json")

ITEMS = [
    {"itemId": "bomb", "stackLimit": 5},
    {"itemId": "arrow", "stackLimit": 99},
    {"itemId": "potion_small", "stackLimit": 20},
]

def generate() -> bytes:
    # 稳定排序并固定JSON格式,避免输入顺序和格式化造成无意义差异。
    normalized = sorted(ITEMS, key=lambda item: item["itemId"])
    content = json.dumps(
        normalized,
        ensure_ascii=False,
        sort_keys=True,
        separators=(",", ":"),
    ).encode("utf-8")

    OUTPUT.parent.mkdir(parents=True, exist_ok=True)
    OUTPUT.write_bytes(content)
    return content

def sha256(data: bytes) -> str:
    return hashlib.sha256(data).hexdigest()

first = sha256(generate())
second = sha256(generate())

print(f"first={first}")
print(f"second={second}")
print(f"reproducible={first == second}")
预期输出中,两次哈希应完全相同;具体哈希值取决于示例内容,因此这里只关注比较结果:
first=<SHA256>
second=<SHA256>
reproducible=True
如果这里得到 False,就应先检查产物里是否混入时间、随机数、非稳定排序、绝对路径或环境变量,而不是把差异当成“正常现象”。
缓存只能影响速度,不能影响结果
缓存最危险的错误,是让“是否命中缓存”改变最终内容。正确的缓存只应该减少重复计算。
可以用一个简单规则判断缓存边界:删掉缓存目录后,构建可以变慢,但最终产物不能变。 如果删缓存后结果不同,说明缓存已经承担了事实来源的角色。
同样,中间文件也应可以被完整重建。CI 中常见的做法是定期执行干净构建:先删除生成目录和缓存,再从源码配置开始导入。这样能尽早发现“本地因为残留文件能成功,干净环境却失败”的问题。
什么时候允许产物不完全逐字节一致
有些产物天然包含压缩库版本、打包顺序或外部工具元数据,做到逐字节一致可能成本很高。此时可以退一步,定义“语义等价”的验证,例如反序列化后比较数据结构、忽略明确声明的构建元数据。
但这个例外必须被显式定义,而不是默认接受随机差异。对游戏配置这类结构化数据,优先追求稳定序列化通常更简单,也更容易做代码审查和回归测试。
当同一份输入可以随时删掉中间产物再重建,并且重建结果可验证地一致时,导入链路才真正具备可维护性。