
游戏客户端架构 / 系统课时
配置校验先拦住哪些错误
配置校验先拦住哪些错误
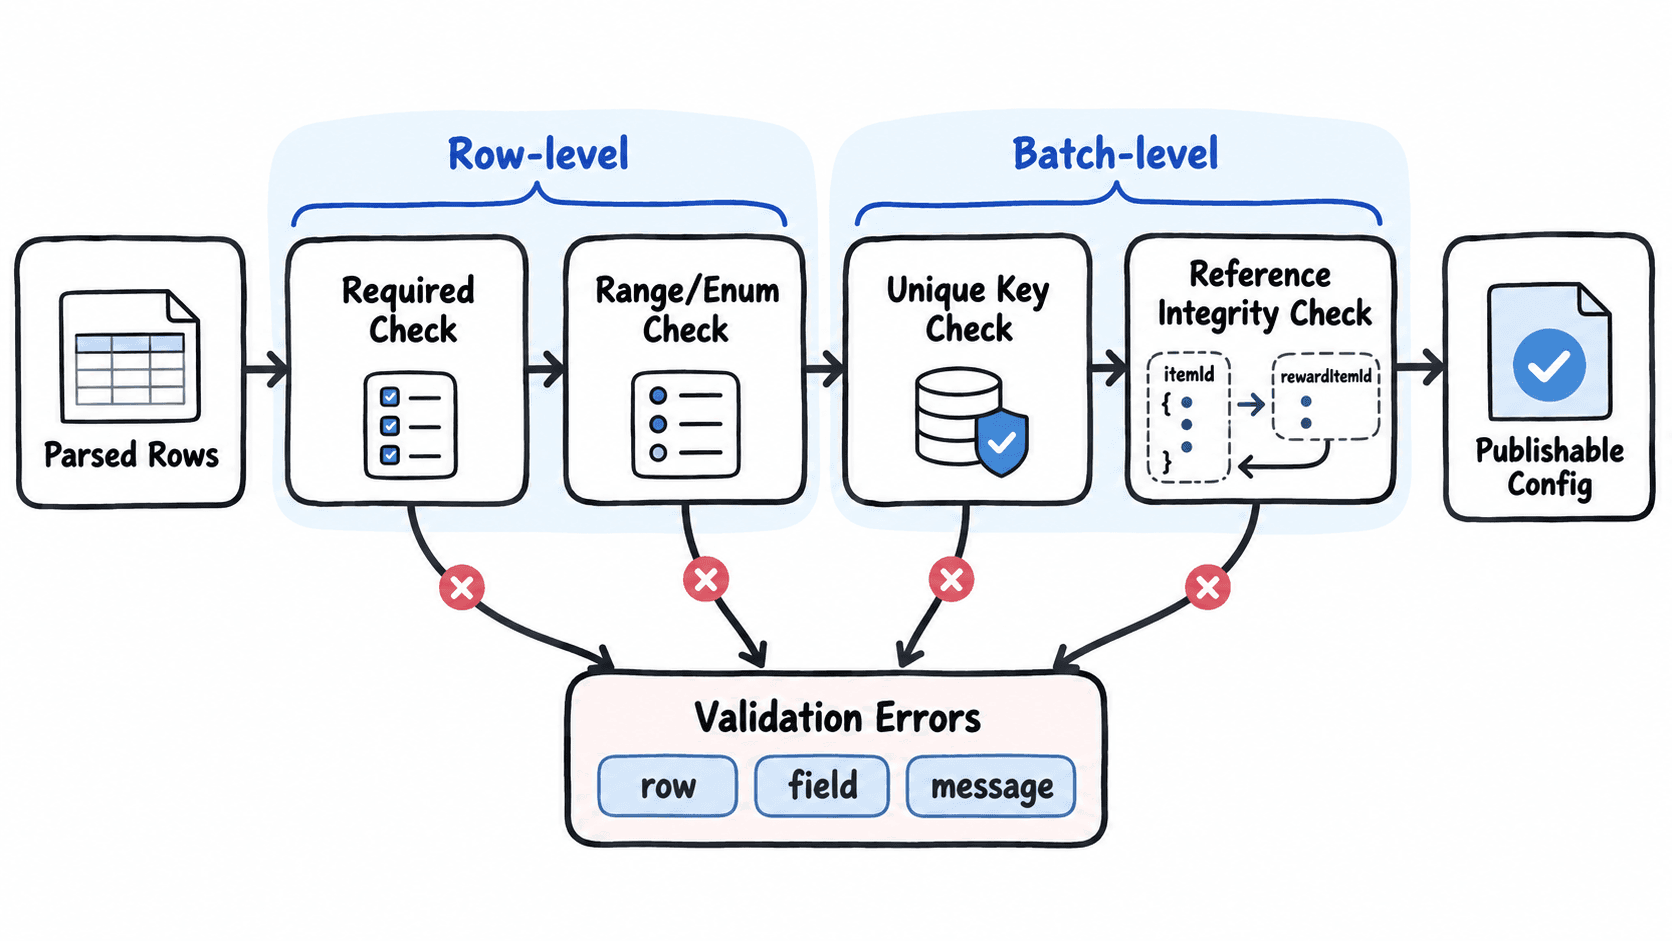
配置成功解析成对象,并不代表它可以进入游戏运行时。真正需要优先拦截的是那些一旦发布就会造成缺值、越界、重复主键或悬空引用的问题。本节建立一条可执行的校验链路,并说明各类规则应该按什么顺序运行。
学习目标
- 建立必填、范围、唯一性和引用完整性四类基础规则。
- 理解为什么引用检查通常要在整批数据读取完成后执行。
- 让校验器一次返回可定位的错误,而不是遇到第一条就退出。
先校验会破坏数据结构的错误
校验优先级不应按“规则写起来方便”决定,而应按错误的破坏性排列。通常先检查必填字段,再检查数值范围和枚举等单行规则,然后检查唯一性,最后处理跨行、跨表引用。
其中唯一性和引用完整性都依赖全局数据。比如 rewardItemId 指向的道具可能出现在文件后半部分,如果边读边立即判定“目标不存在”,就会把合法的前向引用误报为错误。
用一份校验器覆盖四类基础规则
下面示例校验道具配置中的 id、price、quality 和可选的 rewardItemId。程序先收集所有有效主键,再逐行执行规则,因此能够正确处理指向后续行的引用。
interface ItemRow {
  id?: string;
  price?: number;
  quality?: number;
  rewardItemId?: string;
}

function validateItems(rows: ItemRow[]): string[] {
  const errors: string[] = [];
  const firstSeen = new Map<string, number>();
  const idSet = new Set<string>();

  // 第一遍只建立主键集合和首次出现位置,供后续全局规则使用。
  rows.forEach((row, index) => {
    const id = row.id?.trim();
    if (id) {
      idSet.add(id);
      if (!firstSeen.has(id)) firstSeen.set(id, index);
    }
  });

  rows.forEach((row, index) => {
    const rowNo = index + 1;
    const id = row.id?.trim() ?? "";

    if (id === "") {
      errors.push(`row ${rowNo}: id is required`);
    } else if (firstSeen.get(id) !== index) {
      errors.push(
        `row ${rowNo}: id "${id}" duplicates row ${firstSeen.get(id)! + 1}`
      );
    }

    if (row.price === undefined || row.price < 0 || row.price > 999999) {
      errors.push(`row ${rowNo}: price must be between 0 and 999999`);
    }

    if (
      row.quality === undefined ||
      !Number.isInteger(row.quality) ||
      row.quality < 1 ||
      row.quality > 5
    ) {
      errors.push(`row ${rowNo}: quality must be between 1 and 5`);
    }

    const ref = row.rewardItemId?.trim();
    if (ref && !idSet.has(ref)) {
      errors.push(`row ${rowNo}: rewardItemId "${ref}" does not exist`);
    }
  });

  return errors;
}

const rows: ItemRow[] = [
  { id: "potion", price: 20, quality: 1, rewardItemId: "gem" },
  { id: "potion", price: -1, quality: 6, rewardItemId: "missing" },
  { id: "gem", price: 100, quality: 3 },
  { id: "", price: 10, quality: 1 }
];

console.log(validateItems(rows).join("\n"));
预期输出:
row 2: id "potion" duplicates row 1
row 2: price must be between 0 and 999999
row 2: quality must be between 1 and 5
row 2: rewardItemId "missing" does not exist
row 4: id is required
这里的四类规则分别解决不同风险:必填保证对象可识别,范围保证单值可用,唯一性保证主键不会覆盖或歧义,引用完整性保证关联对象真实存在。
校验顺序影响错误质量
必填规则应早于依赖该字段的其他规则。例如 id 为空时,直接报告“必填”比继续生成“重复”“引用失败”等次生错误更有价值。范围规则也应在真正执行玩法逻辑之前完成,否则负价格、非法品质等值会把异常推迟到运行时。
唯一性和引用完整性则适合在整批数据加载完成后统一检查。多表项目中,可以先构建 itemId、skillId、rewardGroupId 等索引,再让各表引用这些索引完成验证。
错误应该聚合,但发布必须阻断
配置工具可以一次收集几十条错误并统一展示,这比 fail-fast 更适合人工维护的配置表。不过“聚合错误”不等于“带错发布”:只要存在 error 级别的问题,就应该阻止生成正式配置包。
对于可容忍的问题,可以另设 warning,例如未使用字段、推荐值偏离、即将废弃的枚举。warning 可以允许继续构建,但 error 应保持确定、可复现,并给出行号、字段名和违反的规则。
最小可用的配置校验链路并不复杂:先保证必填和单值合法,再保证主键唯一,最后保证引用完整。只要这四层稳定存在,大量最常见、也最危险的配置错误就能在进入运行时之前被拦住。