
游戏客户端架构 / 系统课时
游戏里数值不对先查哪一层
游戏里数值不对先查哪一层
当游戏里出现“明明表里是 100,运行时却变成 80”这类问题时,最容易浪费时间的做法是直接回头改源表。更有效的方式是按源表、导入产物、运行时对象、缓存四层逐层核对,先找到数值第一次发生变化的位置,再处理根因。
学习目标
- 建立从源表到运行时的固定排查顺序
- 用逐层对比判断异常发生在导入、加载还是缓存阶段
- 修复后通过重新导出、重载和日志验证问题已经闭环
先固定四层排查顺序
配置数值进入游戏通常会经历多次转换:策划维护源表,工具把它导出为 JSON、二进制或数据库数据,程序再加载成运行时对象,部分系统还会放进本地或远端缓存。只要中间任一层没有更新,最终看到的值就可能和源表不同。
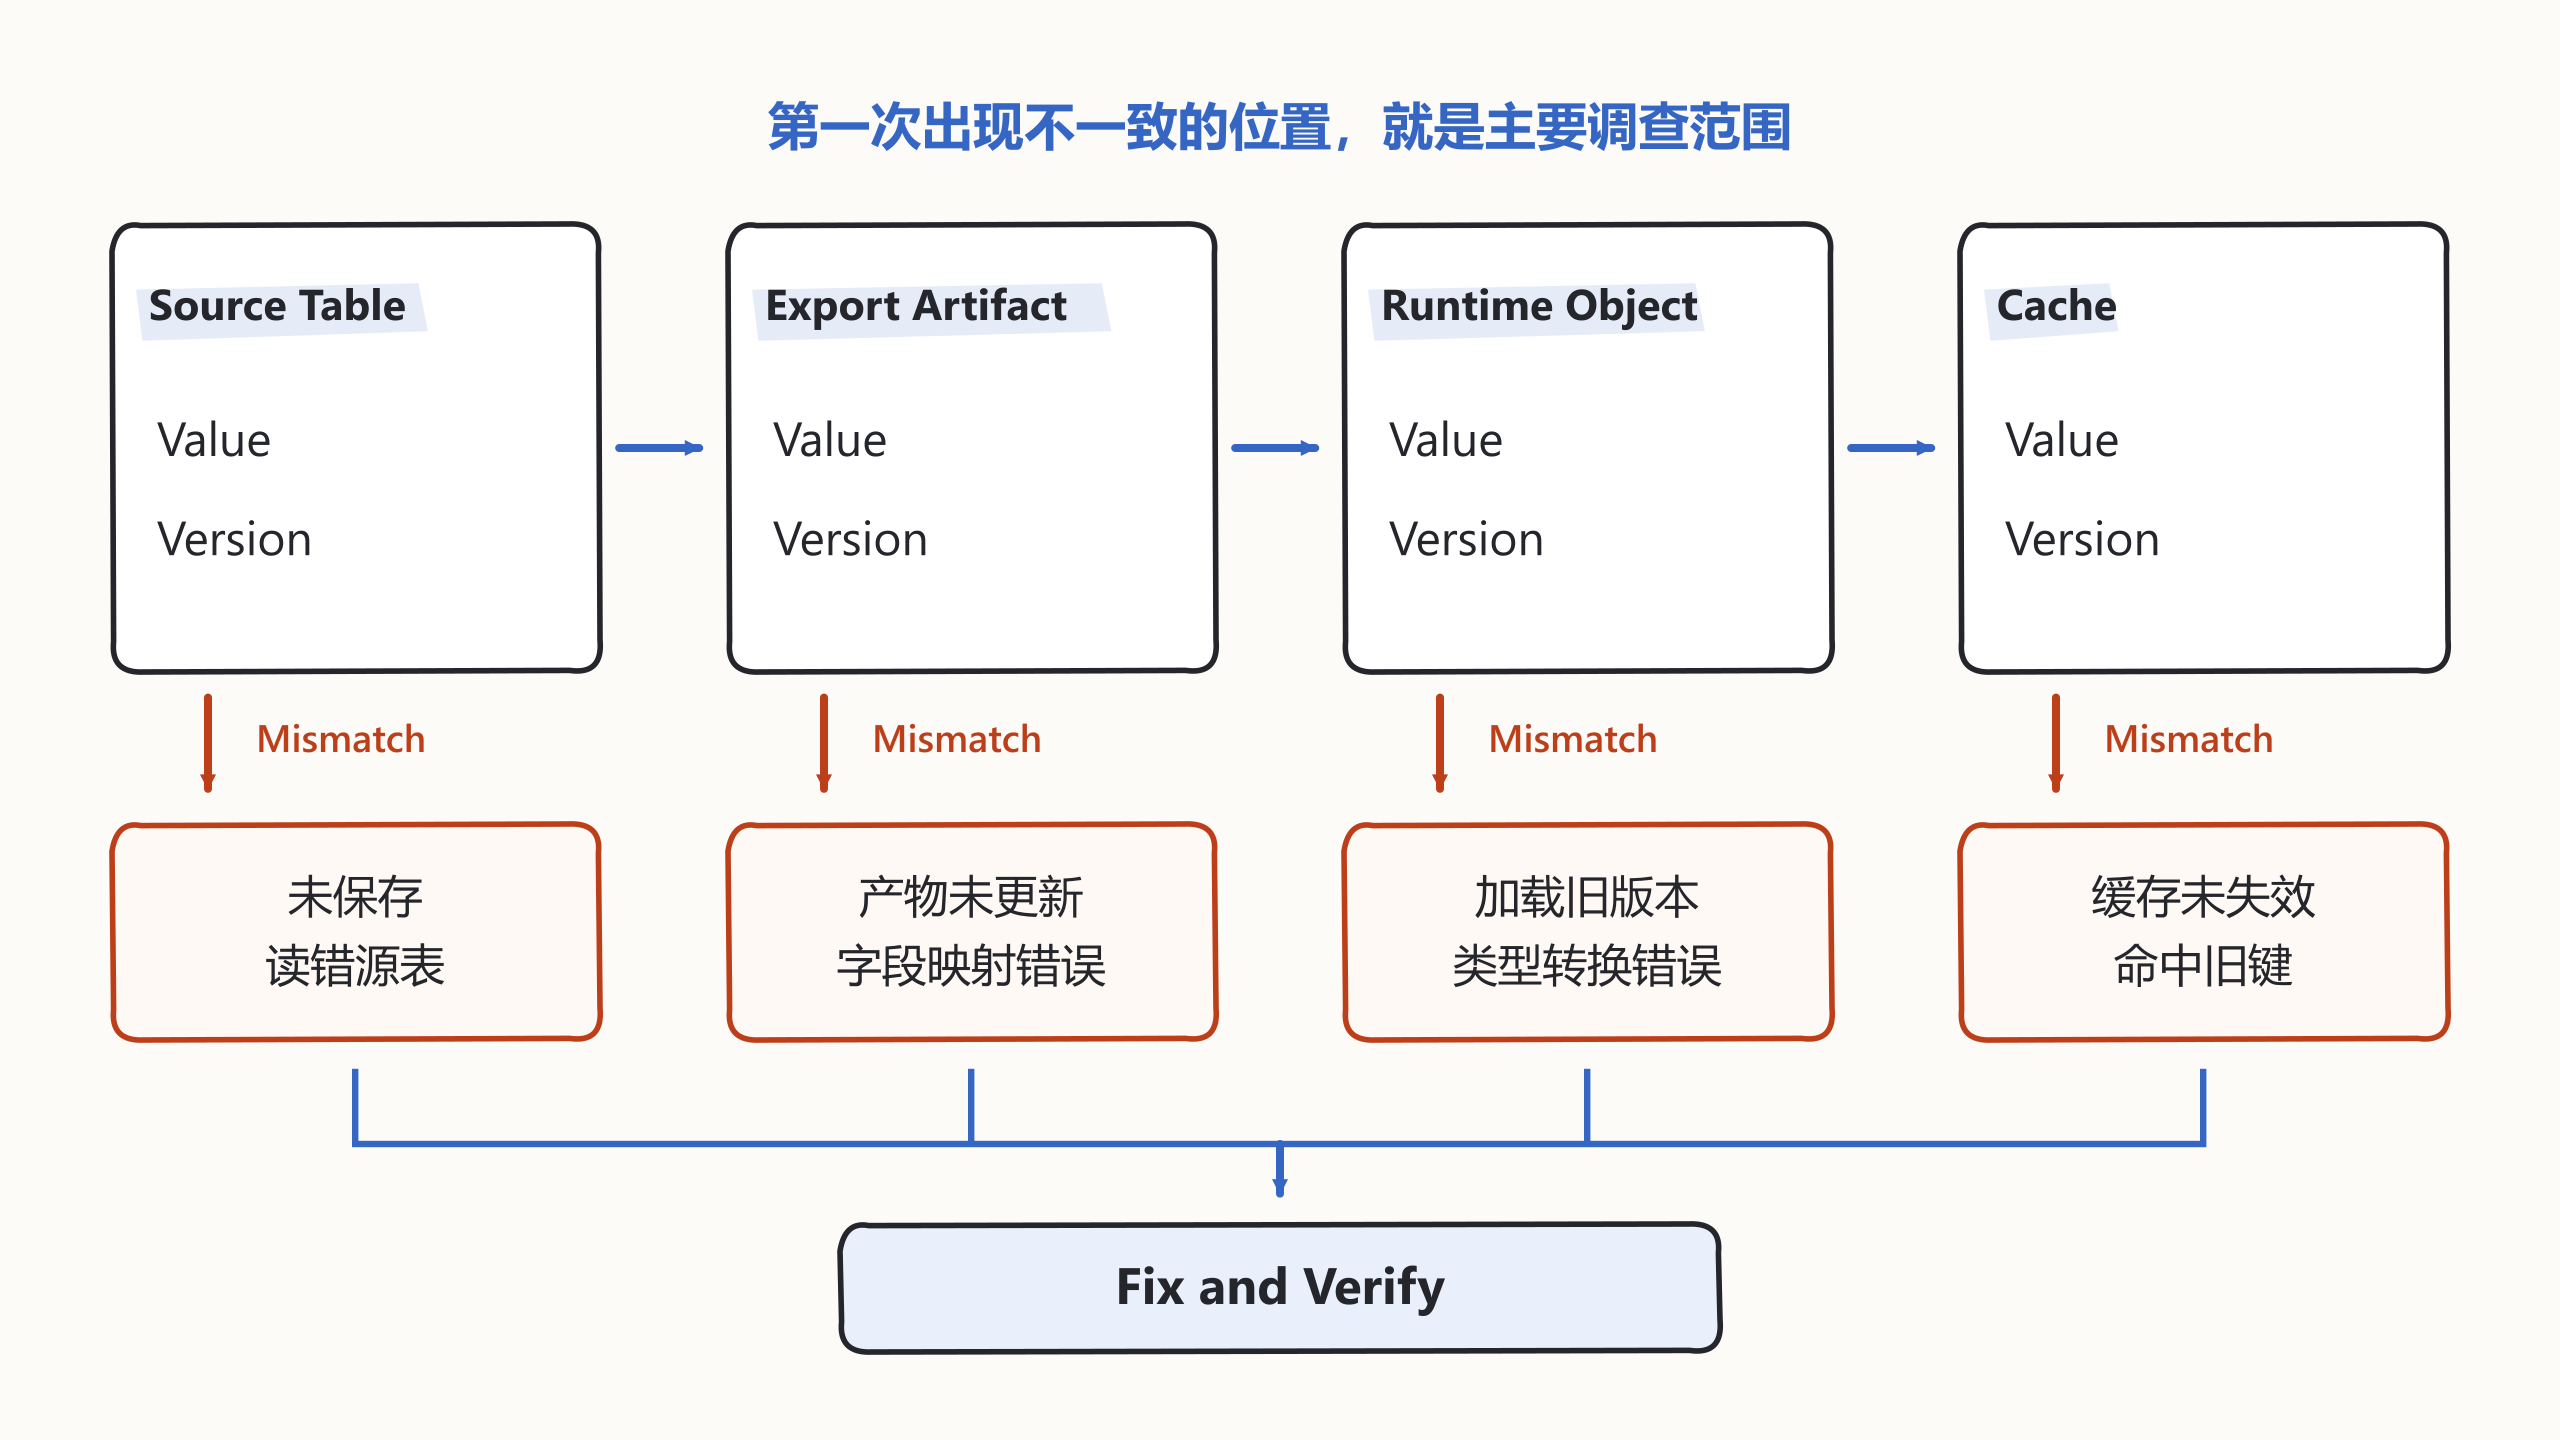
固定顺序的好处是每次只比较相邻两层。如果源表和导出产物已经不同,就没有必要先怀疑运行时逻辑;如果前三层一致而缓存不同,问题范围就已经缩小到缓存更新链路。
找到第一次出现差异的位置
排查时不要只看一个数值,还要同时核对版本信息、资源哈希或构建时间。因为“值相同但版本不同”也可能说明程序加载了旧产物,只是该字段刚好没有变化。
下面用一个可直接运行的 Python 示例模拟四层数据,并自动找出第一次不一致的位置:
layers = [
    ("source", {"version": "v42", "damage": 100}),
    ("export", {"version": "v42", "damage": 100}),
    ("runtime", {"version": "v41", "damage": 80}),
    ("cache", {"version": "v41", "damage": 80}),
]

baseline = layers[0][1]

for name, data in layers[1:]:
    if data != baseline:
        print(f"first mismatch: {name}")
        print(f"expected: {baseline}")
        print(f"actual:   {data}")
        break
else:
    print("all layers are consistent")
预期输出
first mismatch: runtime
expected: {'version': 'v42', 'damage': 100}
actual:   {'version': 'v41', 'damage': 80}
这个结果说明源表和导出阶段是一致的,异常第一次出现在运行时加载,因此优先检查资源选择、版本映射、反序列化和加载路径,而不是继续修改策划源表。
每一层分别查什么
源表层先确认编辑对象是否正确,包括环境、分支、工作表、行 ID 和字段列,避免改到了测试表或同名副本。导入产物层重点检查导出任务是否真的执行、字段映射是否正确、产物版本是否变化,以及发布包里是否包含最新文件。
运行时对象层要看程序实际加载的资源标识和版本,并检查类型转换、默认值覆盖、条件分支和热更新后的重载逻辑。缓存层则关注缓存键是否带版本、旧键是否仍可命中、失效动作是否执行,以及客户端、本地文件缓存和服务端缓存是否各自独立存在。
修复后必须重新走一遍链路
修复某一层后,不要只在编辑器里看结果。应从源表重新导出,确认产物版本更新,再启动或重载运行时对象,最后清理或绕过旧缓存进行验证。这样才能排除“修好了源头,但运行环境仍在使用旧数据”的假象。
验收时至少确认三件事:运行时打印出的配置版本与本次导出一致,关键字段值与导出产物一致,清理缓存前后结果符合预期。如果问题再次出现,也能根据同样的四层顺序快速判断是旧问题复发,还是新的链路断点。
这套方法的核心不是记住某个工具,而是始终寻找“数值第一次从正确变成错误”的那一层。只要排查顺序固定,配置异常通常可以从模糊的“游戏里不对”收敛成一个明确的导出、加载或缓存问题。