
游戏客户端架构 / 系统课时
改表为什么比改代码更可控
改表为什么比改代码更可控
当策划想把技能冷却从 8 秒调成 6 秒时,真正需要变化的是一个业务参数,而不是程序逻辑。把这类变化放进配置表,可以缩短迭代链路,同时让修改、审核、测试和回滚都围绕明确的数据差异进行。
学习目标
- 区分适合进入配置表的变化与必须修改代码的变化
- 理解配置在协作、测试和热更新中的可控性来源
- 建立配置修改的校验、发布和回滚边界
可控的不是表格,而是变化范围
假设一个技能的伤害公式已经确定,只需要反复调整基础伤害、冷却时间和攻击距离。如果这些数字直接写在代码中,每次调参都要经历修改源码、编译、打包和重新部署,参数变化与程序逻辑变化也混在同一次提交里。
改成数据驱动后,程序负责解释规则,配置只提供规则需要的数据。例如下面是项目自定义的示例结构,并非某个游戏引擎的固定格式:
{
  "skillId": "fireball",
  "baseDamage": 120,
  "cooldownSeconds": 6.0,
  "castRangeMeters": 18.0
}
这次修改如果只把 cooldownSeconds 从 8.0 调到 6.0,代码中的技能状态机、伤害结算和目标选择都不需要变化。审查者也能立即看出本次发布改变了什么。
配置生效后的验证重点不是检查某个固定控制台输出,而是加载该配置进入测试场景,确认火球技能两次可释放时间间隔约为 6 秒,并确认其他字段行为保持不变。
配置让协作链路更短
数据驱动最直接的价值,是让不同角色只修改自己负责的层。程序员维护读取、校验和执行规则;策划调整数值与引用;测试人员根据配置差异确定回归范围。这样做减少了为了一个数值修改源码的机会,也降低了无关代码被意外改动的概率。
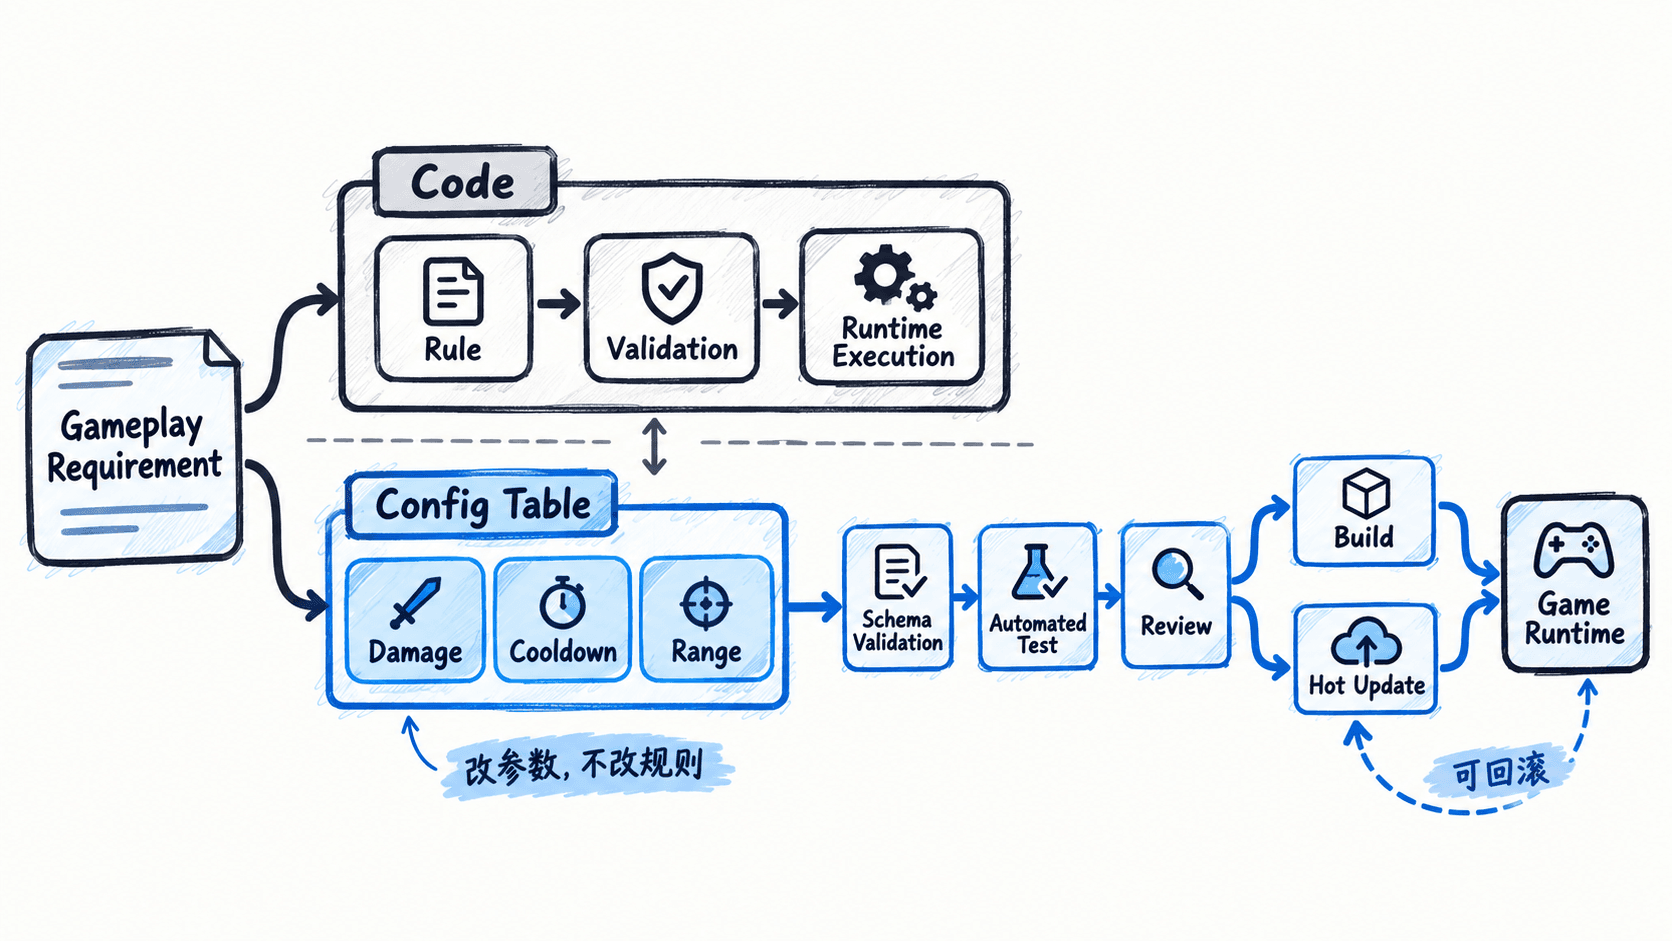
当配置文件进入版本控制后,还可以直接查看字段级差异。例如一次平衡调整只涉及三个数值,那么测试就能围绕这三个变化设计验证,而不必把整个技能系统当成未知变更重新检查。
测试和回滚为什么更清晰
配置并不会天然安全。真正的可控性来自一条完整链路:先限制数据格式,再验证引用和取值范围,然后执行自动化测试,最后发布经过确认的版本。
例如 cooldownSeconds 不应该允许负数,技能引用的资源也必须真实存在。项目可以在加载阶段拒绝非法数据,而不是等玩家进入战斗后才暴露问题。
回滚同样因此变得简单。如果版本 v42 的平衡数据导致战斗异常,而运行时代码没有变化,可以直接恢复到已验证的 v41 配置。相比重新构建整个客户端,故障范围和恢复动作都更明确。
热更新有价值,也有边界
配置天然适合热更新的前提,是运行时本来就支持重新加载这些数据,并且字段变化不会破坏已有对象状态。例如商店价格、活动倍率、部分数值平衡通常比较适合;改变存档结构、网络协议或战斗状态机则不能仅靠改表解决。
判断一个需求是否应该配置化,可以问三个问题:它是否会频繁变化,变化是否只影响数据而不改变控制流程,以及错误数据是否能够被校验和安全回滚。三个条件越充分,配置化的收益通常越高。
反过来,如果一个所谓的“配置项”开始决定大量流程分支、任意脚本执行或对象生命周期,它实际上已经在承担程序逻辑。此时继续往表里塞字段,只会形成难以测试的第二套代码系统。数据驱动真正可控的边界,是让代码定义能力,让配置选择参数和组合,而不是让配置取代代码本身。