
C / C++ / 系统课时
测试失败后怎样快速定位
测试失败后怎样快速定位
测试失败本身并不可怕,真正浪费时间的是只看到“失败”却不知道是哪种输入、期望什么、实际得到什么。本节用一个可运行的 C 测试示例,把失败信息设计成能直接支持定位的诊断结果,并给出一套稳定的排查顺序。
学习目标
- 让失败输出同时包含测试场景、关键输入、期望值和实际值
- 通过非零退出码让自动化流程可靠识别测试失败
- 按固定顺序从失败用例收敛到可复现的最小问题
先把失败输出变成诊断信息
只有 FAIL 两个字几乎不能帮助定位。一次有用的失败至少应回答四个问题:哪个场景失败、输入是什么、期望是什么、实际是什么。如果测试较多,还应让场景名保持唯一且稳定,避免用“case1”“test2”这类离开源码就失去意义的名称。
例如,positive-plus-positive 比 case2 更容易在日志、CI 页面和源码中互相对应。失败输出也不应无差别打印整个对象或大量调试信息;先输出与断言直接相关的最小数据,定位不到时再扩大日志范围。
用可运行的小型测试验证格式
下面的程序故意在“两个正数相加”分支保留一个缺陷,用它观察一条可定位的失败信息。测试函数只打印断言真正需要的数据,并在任一用例失败后返回非零退出码。
#include <stdio.h>

static int failures = 0;

static int add(int a, int b) {
    /* 故意保留一个缺陷,便于观察失败输出。 */
    if (a > 0 && b > 0) {
        return a + b + 1;
    }
    return a + b;
}

static void check_add(const char *scenario, int a, int b, int expected) {
    int actual = add(a, b);

    if (actual == expected) {
        printf("PASS [%s]\n", scenario);
        return;
    }

    /* 失败行同时给出场景、输入、期望值和实际值。 */
    printf("FAIL [%s] input=(a=%d,b=%d) expected=%d actual=%d\n",
           scenario, a, b, expected, actual);
    failures++;
}

int main(void) {
    check_add("zero-plus-zero", 0, 0, 0);
    check_add("positive-plus-positive", 2, 3, 5);

    /* 非零退出码让脚本和 CI 能识别本次测试失败。 */
    return failures == 0 ? 0 : 1;
}
编译并运行:
cc -std=c11 -Wall -Wextra test_calc.c -o test_calc
./test_calc
printf 'exit=%d\n' $?
预期输出:
PASS [zero-plus-zero]
FAIL [positive-plus-positive] input=(a=2,b=3) expected=5 actual=6
exit=1
看到这条日志时,不需要重新阅读全部测试代码就能知道:失败场景是正数相加,输入为 2 和 3,期望 5,实际得到 6。接下来只需检查这个分支,而不是在整个测试套件里盲查。
失败后按固定顺序定位
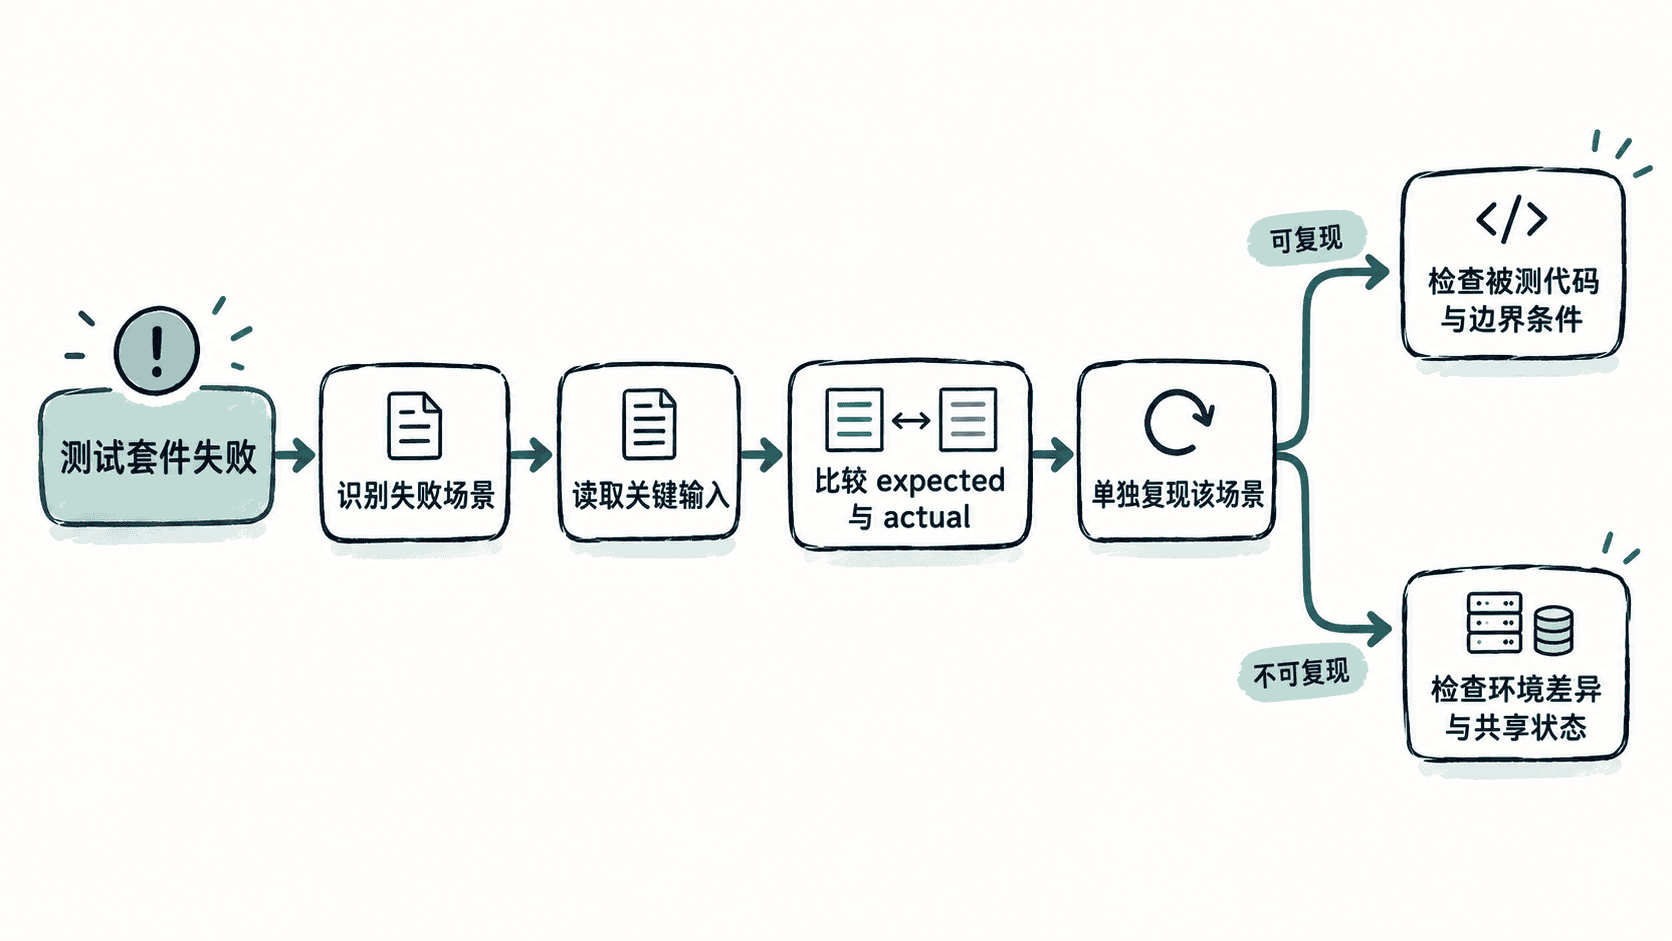
先确认失败是否稳定复现,再看失败行里的场景名和输入;如果同一输入每次都失败,就优先检查被测逻辑和边界条件。如果同一测试时好时坏,则应转向共享状态、未初始化数据、时间依赖、并发或外部资源等不稳定因素。
定位时尽量缩小范围:先单独运行失败场景,再减少无关输入,最后才增加调试日志。不要一开始就把所有变量全部打印出来,否则关键差异会被淹没。
让测试组织帮助缩小范围
测试名称最好包含“对象 + 行为 + 条件”,例如 parser_rejects_empty_input、buffer_grows_when_full。同一模块的测试放在一起,同一行为的正常路径与边界场景靠近,失败时就能从名称直接缩小到某个功能区域。
当失败输出、场景命名和退出码都稳定后,测试日志就不再只是“红灯”,而是一份最小诊断报告:它告诉你先看哪里、用什么输入复现,以及修复后该验证什么。