
C / C++ / 系统课时
用 Core Dump 复盘线上崩溃
用 Core Dump 复盘线上崩溃
进程已经退出时,普通断点无法重现当时的现场。Core Dump 会保存崩溃瞬间的内存和寄存器状态,本节用一个可复现的段错误演示如何生成转储、用 GDB 还原调用栈,并定位真正导致崩溃的指针值。
学习目标
- 理解 Core Dump 保存的调试现场,以及为什么分析时必须使用与崩溃进程匹配的可执行文件和调试符号
- 能在 Linux 上启用核心转储,并用 GDB 加载崩溃现场
- 能使用
bt、frame、info args和print检查调用栈与关键变量
先制造一个可复现的崩溃
下面的程序把空指针传给 read_first,函数读取 data[0] 时会触发 SIGSEGV。保存为 crash.c;编译时保留 -g,并关闭优化,便于让源代码行与栈帧对应。
#include <stdio.h>

static int read_first(const int *data)
{
    /* 故意解引用传入指针,用于制造稳定的段错误。 */
    return data[0];
}

int main(void)
{
    const int *items = NULL;
    printf("%d\n", read_first(items));
    return 0;
}
先为当前 Shell 会话允许生成 Core Dump,再编译并运行:
ulimit -c unlimited
gcc -g -O0 -Wall -Wextra -o crash crash.c
./crash
预期输出:
Segmentation fault (core dumped)不同 Shell 的提示文字可能略有差异;关键是进程因 SIGSEGV 退出,并且系统确实保存了核心转储。如果只看到段错误而找不到文件,先查看 /proc/sys/kernel/core_pattern。当该配置以 | 开头时,Core Dump 被交给了收集器而不是直接写到当前目录;使用 systemd-coredump 的系统通常可通过 coredumpctl 查询。
用正确的文件还原现场
分析 Core Dump 时需要两样东西:崩溃时对应的可执行文件,以及那次崩溃产生的 Core Dump。线上程序即使经过 strip,也应在构建产物中单独保留同版本的未剥离二进制或调试符号;拿后来重新编译的同名程序去配旧 Core,地址与符号可能已经不一致。
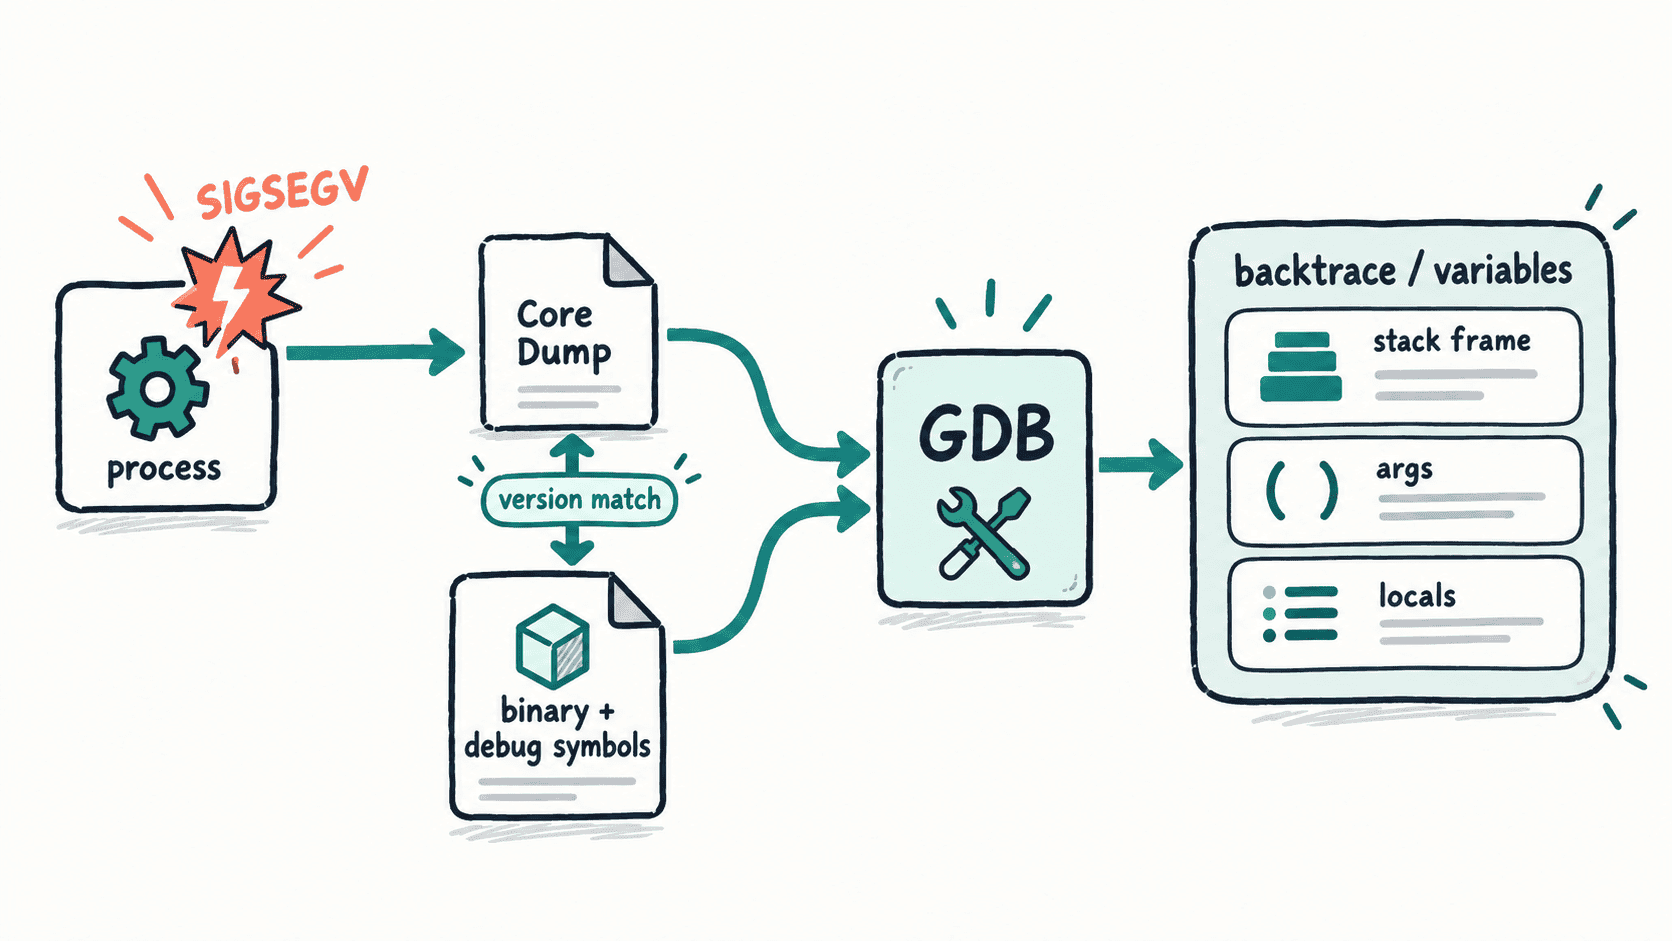
假设核心转储已经保存到 <PATH>,先把占位符替换为实际文件路径,再让 GDB 一次打印关键现场:
CORE_FILE="<PATH>"
gdb -q -batch \
  -ex "bt" \
  -ex "frame 0" \
  -ex "info args" \
  -ex "print data" \
  ./crash "$CORE_FILE"
预期输出的关键部分如下;具体绝对路径、地址和 GDB 的附加提示会因环境不同而变化:
Program terminated with signal SIGSEGV, Segmentation fault.
#0  read_first (data=0x0) at crash.c:6
#1  main () at crash.c:12
#0  read_first (data=0x0) at crash.c:6
data = 0x0
$1 = (const int *) 0x0
这里最有价值的信息不是“发生了段错误”,而是最顶层业务栈帧 read_first 的参数已经是 0x0。因此应继续追问:谁把空指针传了进来、这条路径为什么允许空值进入,而不是只在崩溃行附近加日志。
顺着调用栈检查变量
交互式 GDB 中,bt 用于查看调用链,frame <ID> 切换到指定栈帧,info args 和 info locals 分别查看参数与局部变量,print <表达式> 可检查指针、结构体字段或数组元素。多线程程序还可以用 thread apply all bt 收集所有线程的调用栈,先判断崩溃线程是否被锁、回调或共享状态牵连。
线上使用时要保留什么
Core Dump 只能复盘“已经发生的那一次崩溃”,不能代替稳定复现。生产构建至少应可追溯到唯一版本,并保存对应的二进制、调试符号和源代码提交;否则即使拿到了 Core,也很难可靠映射到函数与行号。
Core 文件还可能包含口令、令牌、用户数据等进程内存内容,应限制生成目录与读取权限,并按故障留存策略及时清理。完成分析后,修复应落到空指针来源、生命周期或边界检查上,再通过测试或可控复现验证,而不是把 Core Dump 当作长期兜底机制。