
C / C++ / 系统课时
一个 C 文件为什么会越来越难维护
一个 C 文件为什么会越来越难维护
把所有函数、结构体和全局变量都塞进一个 .c 文件,开始时很省事,但代码一多,查找、修改和复用都会变慢。本节从真实的增长问题出发,理解“拆文件”解决的不是行数本身,而是职责边界与依赖关系。
学习目标
- 识别单文件项目变难维护的几个典型信号
- 理解声明、定义和职责混在一起为什么会放大修改成本
- 判断什么时候应该开始拆分源文件,而不是继续堆代码
单文件最先暴露的不是长度,而是耦合
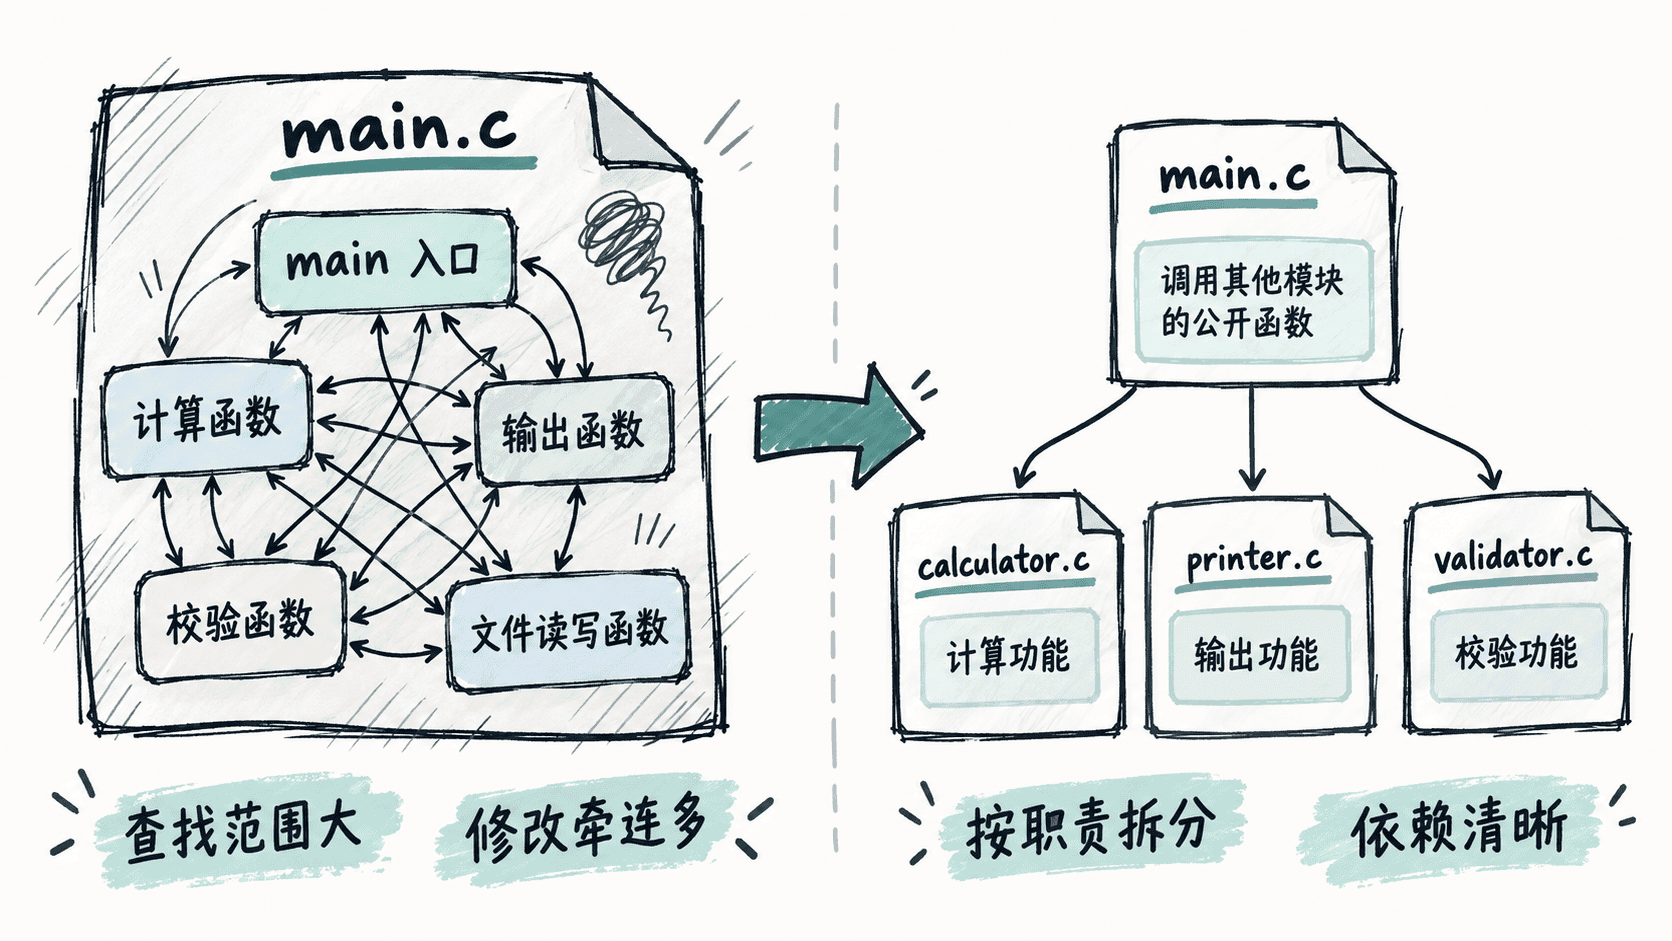
下面这个小程序只有两个业务函数,看起来还很容易阅读;但当格式化、计算、输入校验、文件读写继续加入时,main.c 会同时承担入口、业务逻辑和工具函数三类职责。
#include <stdio.h>

int add(int a, int b) {
    return a + b;
}

void print_result(int value) {
    printf("result = %d\n", value);
}

int main(void) {
    int total = add(2, 3);
    print_result(total);
    return 0;
}
预期输出
result = 5这里真正的问题不是 14 行代码,而是“修改一个功能时需要浏览哪些内容”开始失去边界。比如只想调整输出格式,仍要在包含计算逻辑和程序入口的同一个文件里定位;当函数达到几十个时,搜索结果和跨函数跳转会显著增多。
重复声明会让接口变得不可靠
多处代码需要调用同一个函数时,最危险的做法不是“多写几行”,而是手工复制函数声明。假设某个函数原来声明为 int add(int, int),后来参数类型变了,如果某个文件里的声明没有同步修改,编译阶段甚至可能无法及时暴露所有接口不一致问题。
函数声明本质上是模块对外的契约。真实项目通常把需要公开的声明放进头文件,让调用方通过 #include 共享同一份接口,而不是每个 .c 文件各自抄一遍。
修改成本会随着职责数量增长
当单文件同时包含越来越多职责,常见症状会一起出现:
- 查找一个函数时需要在很长的文件中反复跳转。
- 修改某个功能时,很难快速判断会不会碰到无关代码。
- 多人协作时,大家经常修改同一个文件,版本冲突增多。
- 本来可以复用的函数被入口代码、全局变量或局部实现细节绑住。
- 测试某个独立功能时,往往不得不连同整份程序一起编译。
这些问题说明项目已经缺少清晰的“编译单元边界”。C 编译器会分别编译每个 .c 文件,因此按职责拆分源文件不仅是整理目录,也是在利用语言本身的编译模型。
什么时候应该开始拆分
不要等文件达到某个固定行数才拆分。更可靠的判断标准是:一个文件是否已经承担多个可以独立描述、独立修改的职责。
例如,程序入口负责组织流程,计算模块负责数值运算,输出模块负责展示结果。只要这些职责已经稳定出现,就可以拆成不同源文件,并用头文件暴露必要接口。这样修改输出格式时,不必同时进入计算实现;修改计算算法时,也不必碰程序入口。
拆分的目标不是追求“文件越多越专业”,而是让每个文件的职责清楚、公开接口少而稳定、修改影响范围可预测。