
原生移动开发 / 系统课时
Repository 仓储模式
Repository 仓储模式
Repository 的作用不是“再包一层代码”,而是给上层提供稳定的数据入口,把缓存、本地数据库和网络请求的选择规则集中起来。这样 ViewModel 只关心“拿到用户数据”,不需要知道数据究竟来自哪里。
学习目标
- 理解 Repository 在 ViewModel 与数据源之间承担的职责
- 能设计缓存、本地、网络三层读取顺序
- 知道哪些逻辑应该留在 Repository,哪些不应该放进去
Repository 解决的是数据来源耦合
如果 ViewModel 同时直接调用缓存、数据库和接口,它就必须决定先查谁、失败后切到谁、刷新后写回哪里。来源一多,这些判断会散落在多个页面中,测试也会越来越难。
Repository 把这些选择集中到一个入口。上层依赖 UserRepository,具体实现再协调 MemoryCache、LocalDataSource 和 RemoteDataSource。以后即使把数据库从 Room 换成别的实现,ViewModel 也不需要跟着修改。
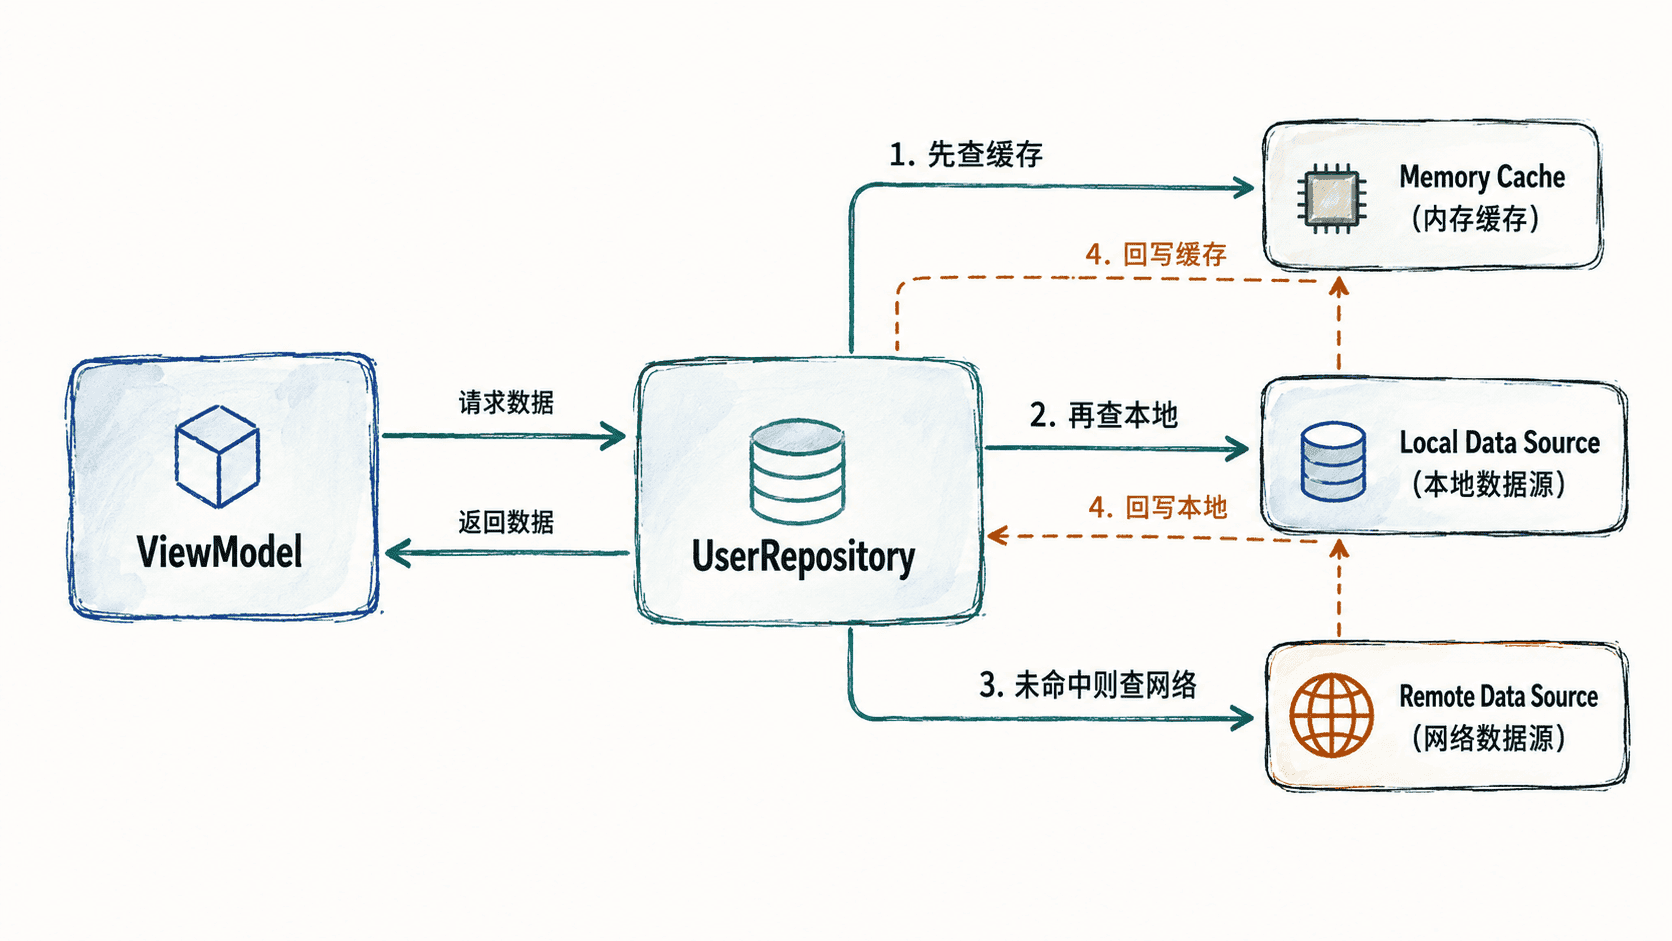
建立统一读取路径
下面用纯 Kotlin 演示一个最小 Repository。默认读取顺序是“缓存 → 本地 → 网络”;强制刷新时跳过前两层,并把网络结果写回本地和缓存。
kotlin
data class User(val id: Int, val name: String)
data class RepoResult(val user: User, val source: String)

interface UserRepository {
    fun getUser(id: Int, forceRefresh: Boolean = false): RepoResult
}

class MemoryCache {
    private val users = mutableMapOf<Int, User>()
    fun get(id: Int): User? = users[id]
    fun put(user: User) { users[user.id] = user }
}

class LocalDataSource {
    private val users = mutableMapOf(1 to User(1, "本地-Ada"))
    fun find(id: Int): User? = users[id]
    fun save(user: User) { users[user.id] = user }
}

class RemoteDataSource {
    fun fetch(id: Int): User = User(id, "网络-Ada")
}

class DefaultUserRepository(
    private val cache: MemoryCache,
    private val local: LocalDataSource,
    private val remote: RemoteDataSource
) : UserRepository {
    override fun getUser(id: Int, forceRefresh: Boolean): RepoResult {
        if (!forceRefresh) {
            cache.get(id)?.let { return RepoResult(it, "cache") }

            val localUser = local.find(id)
            if (localUser != null) {
                cache.put(localUser)
                return RepoResult(localUser, "local")
            }
        }

        val fresh = remote.fetch(id)
        local.save(fresh)
        cache.put(fresh)
        return RepoResult(fresh, "remote")
    }
}

fun main() {
    val repository = DefaultUserRepository(
        MemoryCache(),
        LocalDataSource(),
        RemoteDataSource()
    )

    println(repository.getUser(1))
    println(repository.getUser(1))
    println(repository.getUser(1, forceRefresh = true))
}
预期输出
text
RepoResult(user=User(id=1, name=本地-Ada), source=local)
RepoResult(user=User(id=1, name=本地-Ada), source=cache)
RepoResult(user=User(id=1, name=网络-Ada), source=remote)
第一次命中本地后会写入内存缓存,所以第二次直接从缓存返回;第三次显式刷新,Repository 跳过缓存和本地并更新两层副本。真实 Android 项目通常会把这些调用改成 suspend、Flow 或数据库查询,但职责边界不变。
Repository 应该负责什么
Repository 适合负责数据来源选择、缓存策略、远端与本地同步,以及把底层数据源错误转换成上层可理解的结果。它可以知道“数据从哪里来”,但不应该知道“某个页面按钮是否显示”这类 UI 规则。
当 ViewModel 只依赖 Repository 暴露的业务数据入口时,网络、本地和缓存就从“页面必须操心的细节”变成了可替换的数据实现,这正是仓储模式在应用架构中的核心收益。
按自己的节奏,确认真正理解。