
游戏 AI / 系统课时
线上生成异常时先看哪些指标
线上生成异常时先看哪些指标
玩家反馈“NPC 不说话”或“任务一直转圈”时,直接怀疑模型往往会浪费排查时间。更可靠的方法是先看端到端成功率,再结合延迟、超时、缓存命中、非法输出和游戏应用失败逐层缩小范围,判断问题究竟出在模型、网络、缓存还是游戏侧。
学习目标
- 建立能够区分生成阶段与游戏应用阶段的核心监控指标
- 根据多项指标的组合变化判断异常所在的故障域
- 用结构化请求事件复算指标并支持请求级下钻
成功率至少拆成两层
只记录一个 success=true 不够,因为“模型已经返回结果”与“内容最终成功进入游戏”不是一回事。至少应该区分生成成功率和端到端成功率:前者关注模型调用、响应解析等生成链路,后者还包含 Schema 校验、游戏规则校验、对象映射与实际应用。
如果生成成功率保持稳定,而端到端成功率突然下降,问题更可能位于游戏侧校验或对象应用阶段。如果两项同时下降,再结合超时率、非法输出率和延迟判断上游发生了什么。
用指标组合缩小故障范围
P95 延迟明显升高并伴随超时率上升,应优先检查模型服务、网关和网络链路;非法输出率升高而调用延迟基本稳定,则优先检查模型版本、提示词、结构化输出约束和 Schema。缓存命中率突然下降时,还要确认缓存 Key、TTL、版本隔离以及回源流量是否发生变化。
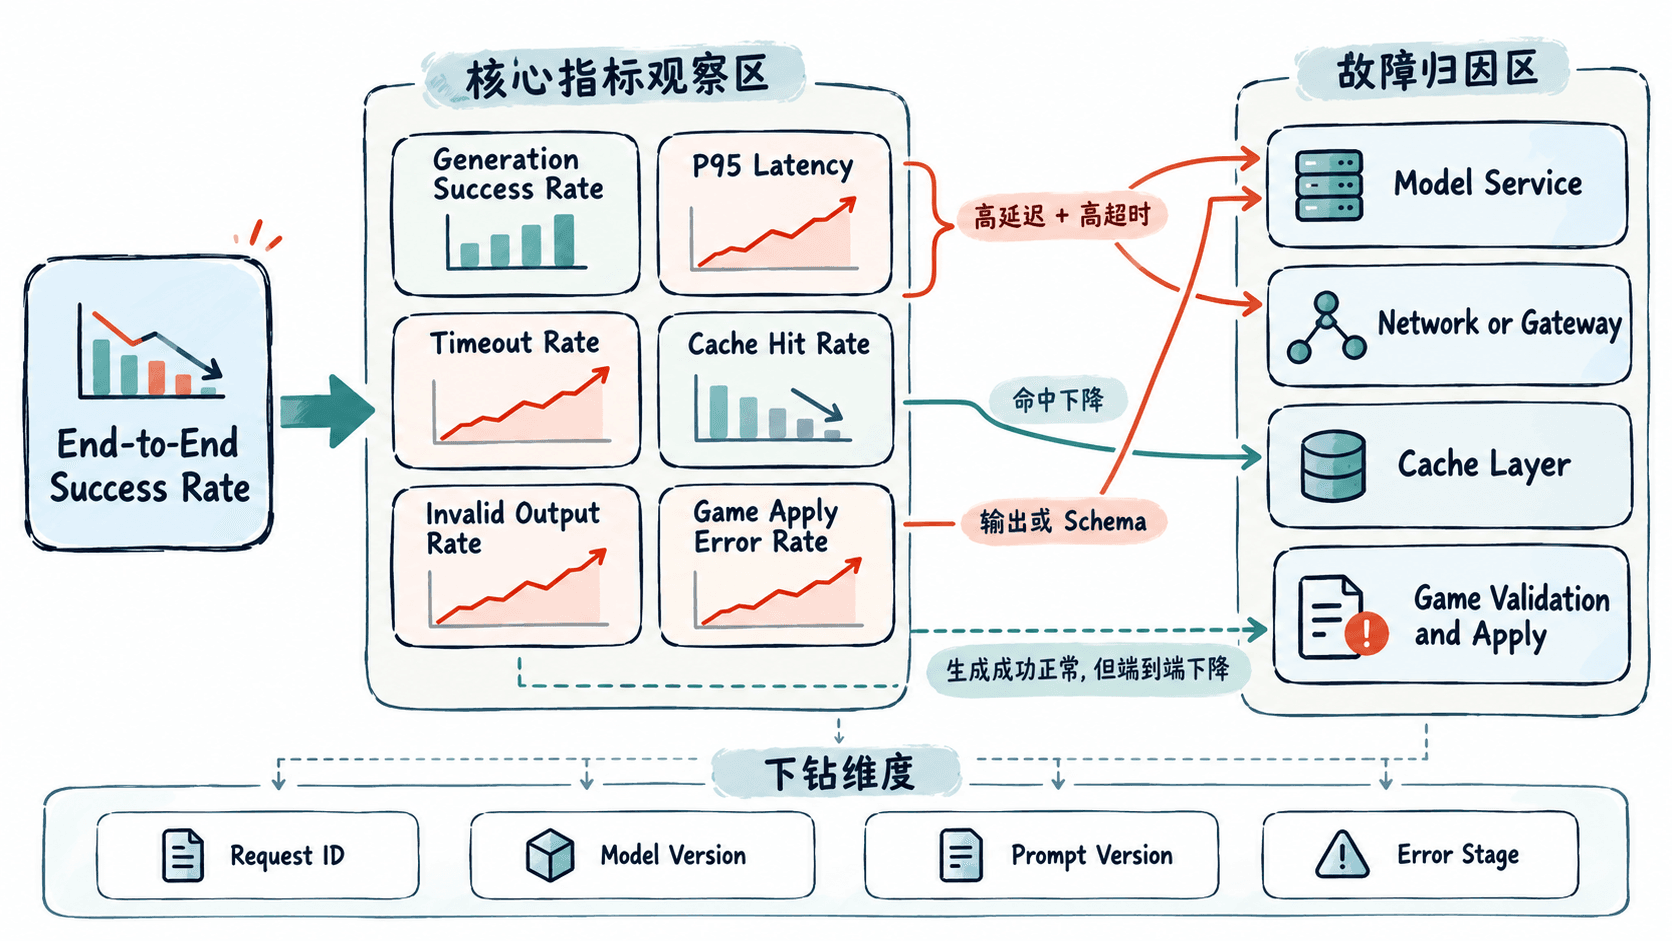
一个实用的排查顺序是:先确认端到端成功率的影响面,再比较生成成功率,接着观察延迟和超时,最后用非法输出、缓存命中以及游戏应用错误完成归因。这样比一开始就搜索大量日志更容易得到方向。
用结构化事件复算指标
下面用六次请求模拟一小段线上事件。示例计算生成成功率、端到端成功率、P95 延迟、超时率、缓存命中率、非法输出率和游戏应用错误率。实际系统中的同类字段通常来自埋点、结构化日志或指标采集系统。
import math

events = [
    {'status': 'ok', 'latency_ms': 420, 'cache_hit': False, 'invalid': False, 'apply_error': False},
    {'status': 'timeout', 'latency_ms': 3000, 'cache_hit': False, 'invalid': False, 'apply_error': False},
    {'status': 'ok', 'latency_ms': 380, 'cache_hit': True, 'invalid': False, 'apply_error': False},
    {'status': 'invalid', 'latency_ms': 510, 'cache_hit': False, 'invalid': True, 'apply_error': False},
    {'status': 'ok', 'latency_ms': 450, 'cache_hit': True, 'invalid': False, 'apply_error': True},
    {'status': 'ok', 'latency_ms': 410, 'cache_hit': True, 'invalid': False, 'apply_error': False}
]

def rate(count, total):
    return 100.0 * count / total

def nearest_rank(values, percentile):
    ordered = sorted(values)
    index = max(0, math.ceil(percentile * len(ordered)) - 1)
    return ordered[index]

total = len(events)
generation_ok = sum(e['status'] == 'ok' for e in events)
e2e_ok = sum(e['status'] == 'ok' and not e['apply_error'] for e in events)
timeouts = sum(e['status'] == 'timeout' for e in events)
cache_hits = sum(e['cache_hit'] for e in events)
invalid = sum(e['invalid'] for e in events)
apply_errors = sum(e['apply_error'] for e in events)
p95 = nearest_rank([e['latency_ms'] for e in events], 0.95)

print(f'generation_success_rate={rate(generation_ok, total):.1f}%')
print(f'e2e_success_rate={rate(e2e_ok, total):.1f}%')
print(f'p95_latency_ms={p95}')
print(f'timeout_rate={rate(timeouts, total):.1f}%')
print(f'cache_hit_rate={rate(cache_hits, total):.1f}%')
print(f'invalid_output_rate={rate(invalid, total):.1f}%')
print(f'game_apply_error_rate={rate(apply_errors, total):.1f}%')
预期输出:
generation_success_rate=66.7%
e2e_success_rate=50.0%
p95_latency_ms=3000
timeout_rate=16.7%
cache_hit_rate=50.0%
invalid_output_rate=16.7%
game_apply_error_rate=16.7%
这组结果同时暴露了两个方向。生成成功率比端到端成功率高 16.7 个百分点,说明存在已经生成成功却在游戏应用阶段失败的请求;P95 又被 3000 ms 的超时请求拉高,说明上游链路同样存在异常。不能把它们简单归成同一个根因。
从聚合指标下钻到一次请求
监控指标只能告诉你“哪里可疑”,最终定位还需要请求级关联字段。每次生成最好统一记录请求 ID,并带上模型版本、提示词版本、缓存命中状态、各阶段耗时、Schema 校验结果、游戏规则校验结果以及最终错误阶段。
出现报警后,先确定异常开始的时间窗口,再按错误阶段筛选失败请求,最后抽取少量原始输入与输出复现。如果模型调用耗时正常、输出也通过 Schema,却大量失败在 game_apply,排查重点就应该立即转向游戏对象映射和状态约束,而不是继续修改模型参数。
线上排障的关键不是不断增加指标,而是让指标能够映射到明确阶段和下一步动作。只要把成功率分层、延迟与超时分离、缓存与回源分离,并单独记录非法输出和游戏应用错误,大多数生成异常都能快速缩小到具体故障域。