
游戏 AI / 系统课时
用缓存减少重复生成
用缓存减少重复生成
游戏中的生成请求并不都需要重新调用模型。同一玩家、同一场景和同一上下文可能在短时间内重复出现。本篇通过缓存键、失效策略和上下文版本,让“可以复用”的结果直接命中缓存,降低延迟与调用成本。
学习目标
- 判断哪些生成请求适合缓存,以及哪些请求不应复用
- 设计包含内容版本的稳定缓存键
- 用 Python 实现最小缓存流程并验证命中与失效行为
先判断什么值得缓存
最适合缓存的是输入稳定、输出允许复用的内容,例如固定 NPC 对话、任务描述、物品说明或某个明确版本下的生成结果。相反,强依赖实时战斗状态、随机性或个体化隐私数据的结果通常不应直接共用。
判断是否缓存,可以先问三个问题:输入是否可稳定标识,结果是否允许在一段时间内复用,内容规则变化后是否能及时失效。三个问题都能回答清楚,再设计缓存键。
缓存键要包含什么
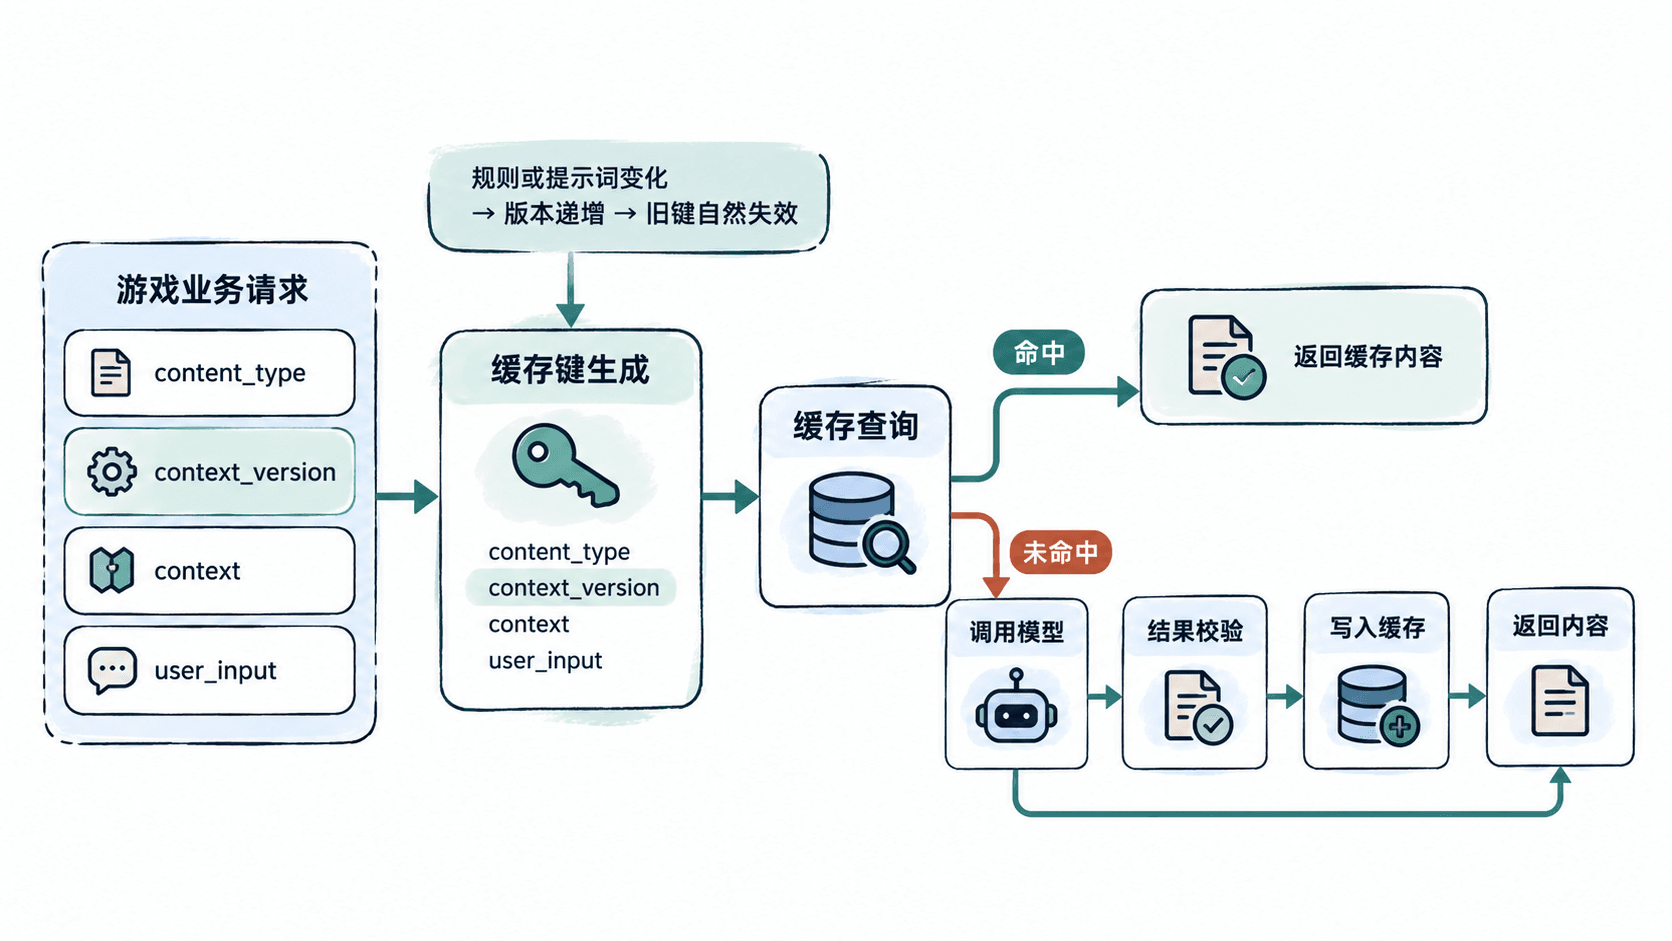
缓存键不能只用玩家输入字符串。至少应把内容类型、关键上下文以及上下文版本纳入键,否则“同一句话在不同角色或不同规则下生成不同结果”的情况会互相污染。
一个实用形式是把稳定字段规范化后连接,再计算哈希。例如:
content_type + context_version + normalized_context + user_input
其中 context_version 很重要。角色设定、世界观规则或提示词发生变化时,只要版本号改变,旧结果自然不会被误用,不必依赖手工删除全部缓存。
一个可验证的缓存实现
下面使用 Python 标准库实现进程内缓存。示例重点展示键设计和失效逻辑,真实项目可以把存储替换为 Redis 或其他缓存系统,但业务层仍可保持相同接口。
import hashlib
import time


class ContentCache:
    def __init__(self, ttl_seconds: int = 60):
        self.ttl_seconds = ttl_seconds
        self._items: dict[str, tuple[float, str]] = {}

    def build_key(
        self,
        content_type: str,
        context_version: str,
        context: str,
        user_input: str,
    ) -> str:
        raw = "|".join(
            [content_type, context_version, context.strip(), user_input.strip()]
        )
        return hashlib.sha256(raw.encode("utf-8")).hexdigest()

    def get(self, key: str) -> str | None:
        item = self._items.get(key)
        if item is None:
            return None
        expires_at, value = item
        if time.time() >= expires_at:
            self._items.pop(key, None)
            return None
        return value

    def set(self, key: str, value: str) -> None:
        self._items[key] = (time.time() + self.ttl_seconds, value)


def generate_content(cache: ContentCache, user_input: str) -> str:
    key = cache.build_key(
        content_type="npc_reply",
        context_version="v3",
        context="tavern-owner:north-gate",
        user_input=user_input,
    )
    cached = cache.get(key)
    if cached is not None:
        return f"CACHE_HIT: {cached}"

    # 模拟一次实际生成,并写入缓存。
    result = f"生成内容:{user_input}"
    cache.set(key, result)
    return f"MODEL_CALL: {result}"


def main() -> None:
    cache = ContentCache(ttl_seconds=60)
    print(generate_content(cache, "北门怎么走?"))
    print(generate_content(cache, "北门怎么走?"))


if __name__ == "__main__":
    main()
预期输出
MODEL_CALL: 生成内容:北门怎么走?
CACHE_HIT: 生成内容:北门怎么走?
第一次请求没有缓存,因此执行一次生成并写入结果;第二次使用完全相同的内容类型、上下文版本、上下文和输入,可以直接命中缓存。实际时间值和哈希键会因输入不同而变化。
失效不是只有过期时间
TTL 适合控制“结果最多保留多久”,但它不能解决规则刚修改就必须换结果的问题。生成系统至少应同时考虑时间失效和版本失效。
时间失效可以让角色台词、短期活动文本在几十秒或几分钟后重新生成。版本失效则针对提示词、角色设定、世界规则等明确变化,只要 context_version 从 v3 变成 v4,新请求就会得到全新的缓存键。
对于需要手动撤销的内容,还可以增加显式删除能力,例如运营修改任务文本后立即删除指定内容类型的缓存。不要把“清空所有缓存”当作默认方案,否则缓存带来的收益会同时消失。
哪些请求不要直接缓存
实时战斗决策、强随机事件和依赖当前服务器状态的内容不适合无条件复用。即使文本相同,只要输入中存在未进入缓存键的状态字段,命中旧结果就可能产生错误行为。
另一个常见问题是缓存键过粗。例如只用 user_input,会让不同角色对同一句话共享结果;只用玩家 ID,则会把本来可以跨玩家复用的公共内容全部隔离开。缓存键应该同时满足区分必须区分的输入和忽略不影响结果的输入。
因此,设计缓存时先定义“结果由哪些字段决定”,再决定键结构和失效策略。缓存只是生成服务前面的一层加速机制,不能替代正确的上下文建模;只有缓存与上下文版本一起设计,才能在降低调用次数的同时保持游戏内容的一致性。