
游戏 AI / 系统课时
让模型输出敌人的战术意图
让模型输出敌人的战术意图
本篇把生成式模型接到敌人决策的高层:模型不直接控制移动、攻击或技能,而是在有限候选中选择一个战术意图,再由传统 AI 验证并执行。这样可以获得行为差异,同时保留规则系统对最终动作的控制权。
学习目标
- 设计适合模型输出的有限战术意图集合
- 让模型输出可校验、可回退的数据,而不是自由文本指令
- 把模型决策与状态机、行为树或 Utility AI 的执行职责分开
先定义模型的输出边界
模型最容易失控的情况,是让它直接生成“敌人下一步怎么做”的自然语言。自然语言适合表达想法,却不适合直接作为游戏执行接口。更可靠的方式是先定义有限的意图枚举,例如 suppress、retreat、focus_fire、hold,模型每次只负责从集合中选择一个结果。
输出还应该带上足够少但有用的上下文,例如当前意图、目标类别和简短理由。理由用于调试和观察,不参与游戏状态修改。真正进入执行层的字段应该经过白名单校验。
用结构化结果连接模型与传统 AI
推荐把模型与执行系统之间设计成明确的数据契约。一个最小结果可以包含意图和目标类型:
{
  "intent": "focus_fire",
  "targetType": "healer",
  "reason": "The healer is restoring the highest-value ally."
}
这里的 intent 和 targetType 都应该属于预先定义的有限集合。执行器拿到结果后,先验证字段和值,再根据当前战斗状态决定是否接受。例如 focus_fire 需要可选目标存在;retreat 需要存在可达撤退位置;hold 则可能完全不需要目标。
建立“选择、校验、执行、回退”链路
模型决策最适合放在战术层,而不是直接接管行为层。典型链路是:战斗状态先整理为模型所需上下文,模型选择意图;执行器检查意图是否合法,再交给行为树或状态机展开具体动作;任意一步失败,都回退到确定性的默认行为。
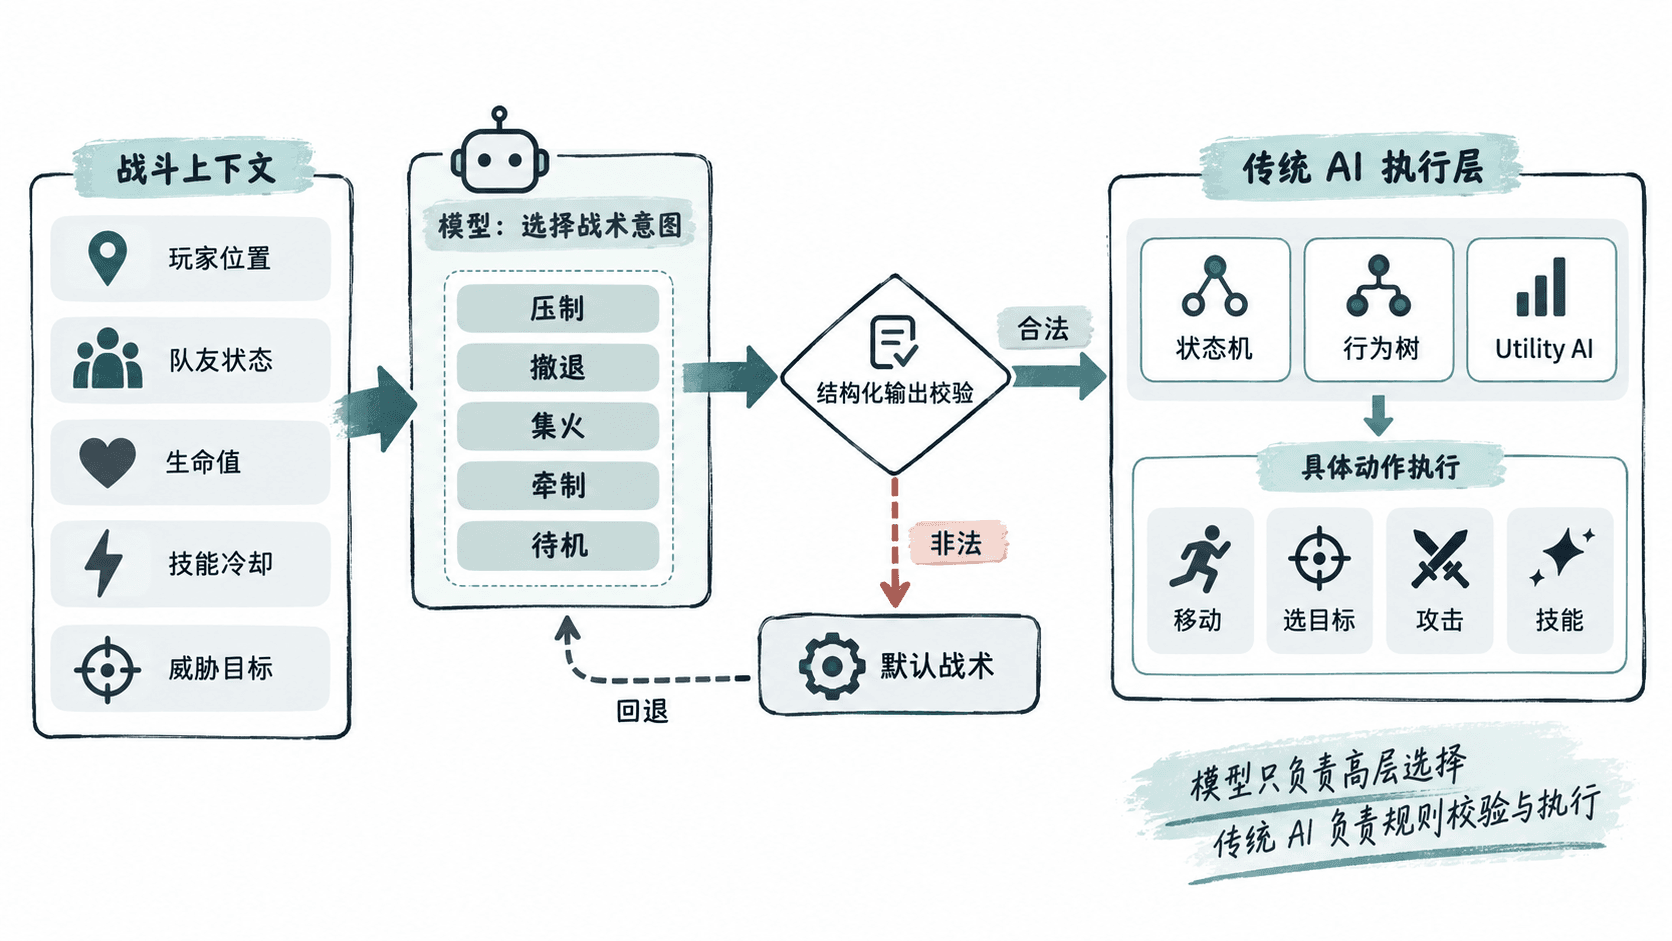
这样分层的关键价值是,即使模型产生一个不合适的选择,游戏也有明确的保护边界。比如模型要求 focus_fire,但场上不存在合法治疗者目标,执行器可以拒绝该结果并切换到 suppress 或默认的近敌策略,而不是让敌人进入无效状态。
控制调用频率和失败行为
战术意图不需要每帧重新生成。可以在进入新战斗阶段、关键目标死亡、队友数量变化或经过固定决策间隔后重新请求模型。模型不可用、超时或返回非法结果时,应立即使用本地规则,而不是等待模型恢复。
一个简单的状态优先级可以是“安全规则高于模型意图”。例如敌人已经处于眩晕、缴械或死亡状态时,模型返回的攻击意图没有执行意义;当生命值低于预设阈值时,系统也可以直接强制进入撤退分支。模型只在规则允许的范围内拥有选择权。
让输出变得可观测
接入模型后,调试重点会从“敌人为什么攻击了”变成“模型当时看到了什么、选择了什么、系统为什么接受或拒绝”。因此至少应记录决策时间、输入状态摘要、模型意图、校验结果和最终执行动作。
当你发现敌人行为异常时,可以沿着“上下文 → 模型意图 → 校验 → 执行”逐段定位,而不是只看最后一个动作。只要模型的输出始终被限制为有限意图,并由确定性系统负责校验和回退,生成式 AI 就能成为战术选择器,而不是不可控的游戏逻辑入口。