
游戏 AI / 系统课时
战斗中怎样避免模型频繁调用
战斗中怎样避免模型频繁调用
本篇解决生成式 AI 接入战斗循环后的性能问题:不要让模型跟着每个帧更新运行,而是按固定决策周期、关键事件和缓存结果控制调用,只让模型参与低频战术变化。
学习目标
- 区分帧级控制、规则级反应和低频战术决策
- 用决策周期与事件触发减少模型调用次数
- 设计带有效期的结果缓存,并在关键事件发生时主动失效
把模型从每帧循环里拿出来
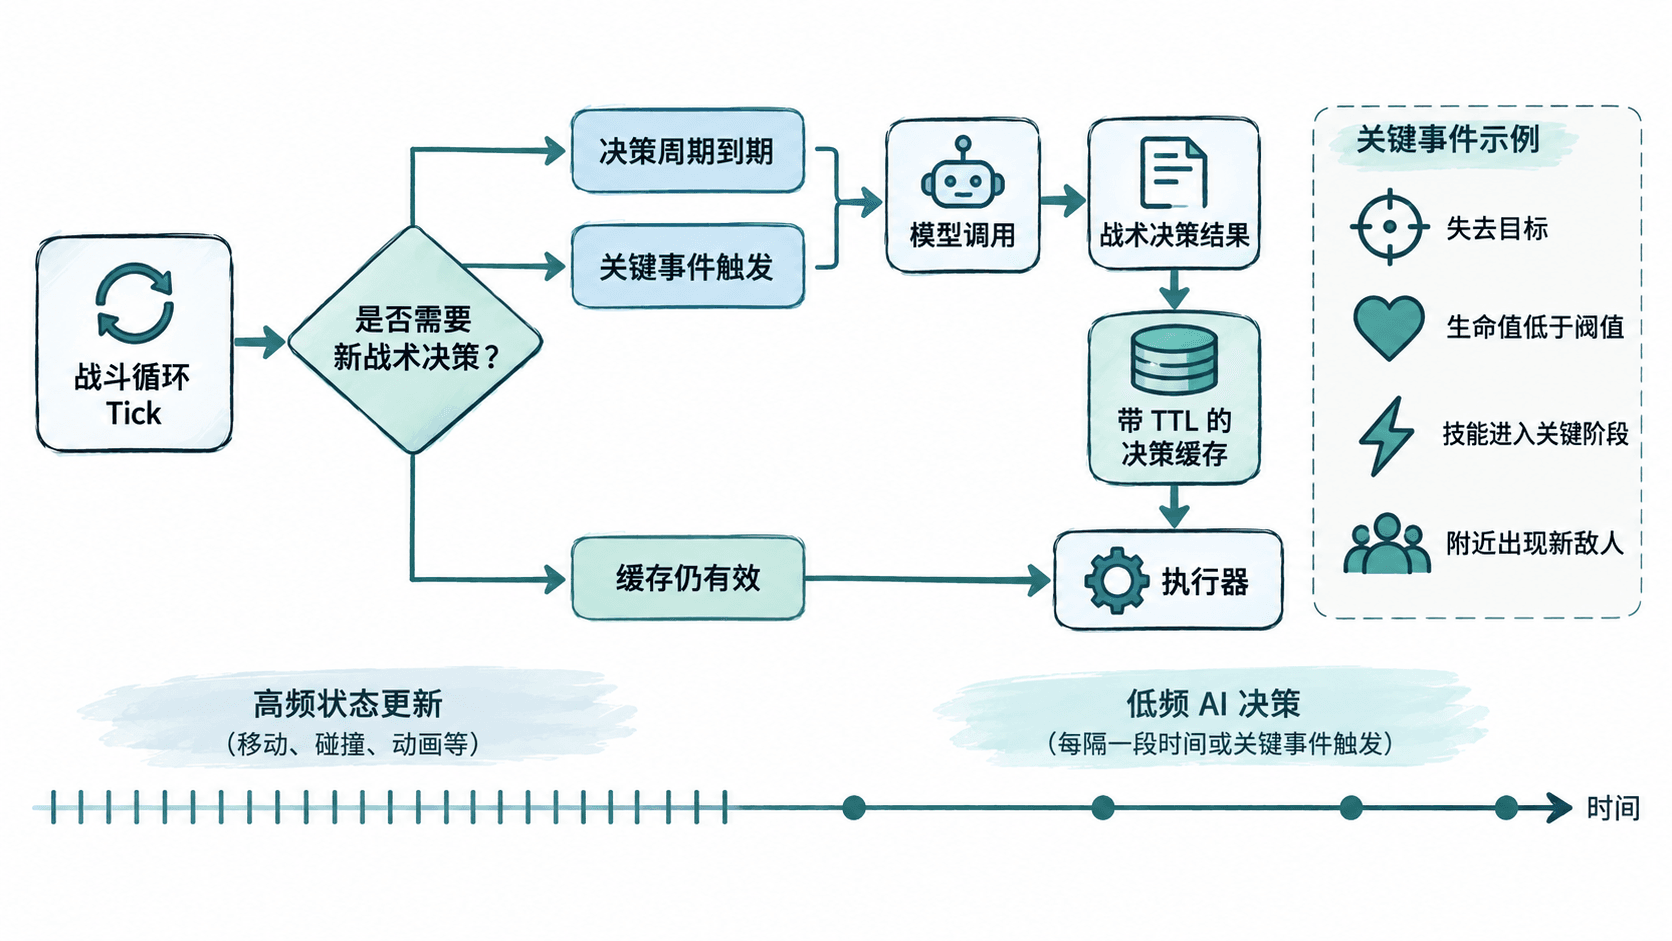
战斗循环可能每秒执行几十次甚至上百次,但敌人的战术意图没有必要以同样频率变化。移动、碰撞、动画和距离计算应继续使用普通游戏代码;模型只在“该换策略了”这个层级工作。
一个实用的拆分方式是把调用条件分成三类:固定时间到期、重要战斗事件触发、缓存仍有效时直接复用。这样即使战斗持续数十秒,也不会把每个 tick 都变成一次模型请求。
用决策周期控制基础频率
最简单的限制方式是设置下一次允许调用模型的时间。例如每 2 秒只允许产生一次战术决策。周期内所有普通 tick 都复用上一次结果,真正的移动和技能执行仍由游戏逻辑完成。
下面的示例只演示调用节流本身;call_model 代表项目已有的模型客户端,因此这是一个片段示例,需要接入你的实际调用函数后运行。
import time

DECISION_INTERVAL = 2.0
last_decision_time = 0.0
cached_decision = {"action": "hold_position"}


def call_model(snapshot: dict) -> dict:
    # 实际项目中替换为你的模型客户端调用。
    return {"action": "attack", "target_id": snapshot["target_id"]}


def get_decision(snapshot: dict) -> dict:
    global last_decision_time, cached_decision

    now = time.monotonic()
    if now - last_decision_time < DECISION_INTERVAL:
        return cached_decision

    cached_decision = call_model(snapshot)
    last_decision_time = now
    return cached_decision


snapshot = {"target_id": "enemy-42"}
first = get_decision(snapshot)
time.sleep(0.1)
second = get_decision(snapshot)
print(first == second)
预期输出
True这里的 True 表示 0.1 秒内第二次请求直接复用了第一次结果。实际项目中时间值会根据战斗节奏调整,不应把 2 秒当成固定标准。
让关键事件打破缓存
单纯依赖时间周期仍可能响应太慢。例如敌人刚刚失去目标,如果还要等剩余 1.8 秒才能重新决策,表现就会僵硬。因此需要事件触发,让部分状态变化立即使缓存失效。
适合触发新决策的通常是会改变战术空间的事件,例如目标消失、生命值跨过危险阈值、进入新战斗区域、重要技能结束冷却或附近出现新的高威胁目标。普通的位移更新则不应触发模型调用。
可以把每次决策绑定两个条件:最短调用间隔和缓存失效事件。即使事件频繁发生,也要继续遵守最短间隔,避免敌人进入事件风暴后连续发送请求。
让缓存结果带上有效条件
战术结果不能无限期复用。除了 TTL,还应该记录它是在什么状态下生成的,例如目标 ID、敌我距离区间、当前技能阶段和战斗状态。执行前发现这些关键条件已经明显变化,就应直接放弃缓存。
最终可以采用“高频规则 + 低频模型”的结构:高频部分处理运动、碰撞和即时约束;模型每隔一段时间或在重要事件发生时重新选择战术;缓存负责覆盖大多数普通 tick。这样模型调用次数下降后,战斗循环仍可保持稳定,而敌人的策略又能对真正重要的局势变化作出反应。