
游戏 AI / 系统课时
一次生成到底花多少钱
一次生成到底花多少钱
生成成本不能只看模型单价。一次请求的输入 token、输出 token、调用次数、缓存命中率和实际使用的模型共同决定成本;再把单次成本乘以每分钟或每局的调用量,才能估算单玩家和整服成本,并判断哪些优化真正值得做。
学习目标
- 能区分输入 token、输出 token 和有效缓存带来的成本变化
- 能计算单次生成、单玩家和整服的估算成本
- 能用调用频率、缓存命中率和模型价格定位成本优化重点
先建立单次成本模型
最简单的估算可以把输入和输出拆开计算。设输入 token 数为 ,输出 token 数为 ,输入价格为 (每百万 token),输出价格为 (每百万 token),则单次请求成本为:
如果系统存在缓存,还要把真正送入计费路径的输入量算清楚。缓存命中并不意味着整次请求免费,具体计费方式取决于所使用的模型和服务商,因此成本模型中应把“缓存命中后的实际计费 token”作为独立变量,而不是自行假设一个固定折扣。
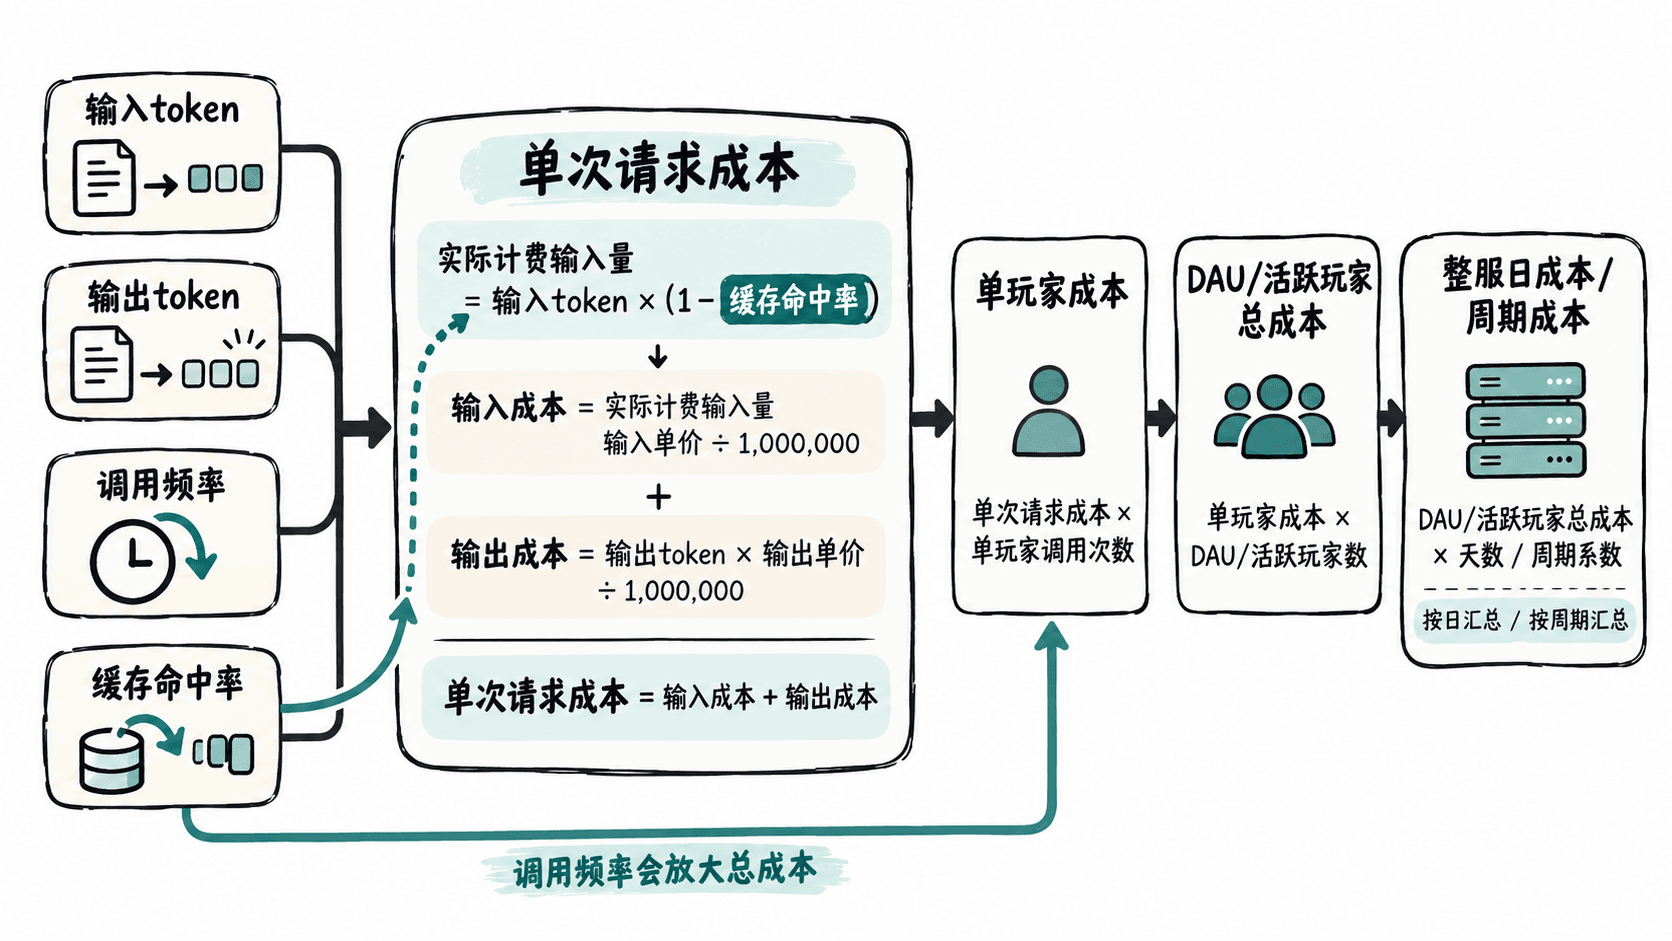
这里有一个常见误区:平均输出长度往往比输入长度更容易失控。提示词、角色上下文和历史记忆会让输入持续增长,而模型生成越长,输出 token 也越多。因此成本监控最好同时记录每次请求的输入 token、输出 token 和模型名称,而不是只统计 API 调用次数。
用 Python 做一个可复用的成本估算
下面的示例假设价格单位是“美元 / 百万 token”,调用频率按每小时请求次数计算。它只负责数学计算,不代表任何具体模型的实时价格,实际价格应从当前供应商账单或官方价格配置中读取。
def request_cost(input_tokens: int, output_tokens: int,
                 input_price_per_million: float,
                 output_price_per_million: float) -> float:
    input_cost = input_tokens / 1_000_000 * input_price_per_million
    output_cost = output_tokens / 1_000_000 * output_price_per_million
    return input_cost + output_cost


def main() -> None:
    # 示例价格仅用于演示计算,不对应特定供应商。
    cost = request_cost(
        input_tokens=2_000,
        output_tokens=500,
        input_price_per_million=1.0,
        output_price_per_million=4.0,
    )

    requests_per_player_per_hour = 6
    active_players = 1000
    hours = 24

    hourly_per_player = cost * requests_per_player_per_hour
    daily_total = hourly_per_player * active_players * hours

    print(f"cost_per_request=${cost:.6f}")
    print(f"daily_total=${daily_total:.2f}")


if __name__ == "__main__":
    main()
预期输出
cost_per_request=$0.004000
daily_total=$576.00
这里的计算关系是:单次输入成本为 ,输出成本为 ,所以一次请求为 。每位玩家每小时 6 次请求,则每人每天成本为 ;1000 名活跃玩家对应每天约 。实际生产环境还要把不同场景、不同模型和不同缓存状态分别统计。
把缓存命中率纳入估算
缓存真正有价值的地方,是减少重复上下文进入计费路径。可以把请求拆成“可缓存部分”和“不可缓存部分”,分别统计命中率。例如世界观规则、固定角色设定属于高复用上下文,而当前战斗状态通常每次不同。前者应尽量稳定,才能产生更高的缓存收益。
成本估算时,不要直接写成“缓存命中率 50%,所以成本减半”。正确做法是根据实际计费规则计算命中请求与未命中请求各自的成本,再按命中率加权。不同服务的缓存机制和计费方式可能不同,应以对应服务的当前价格说明为准。
从单玩家放大到整服
整服成本最容易受两个变量放大:活跃玩家数和单位时间调用次数。可以把公式写成:
其中 是每位玩家每天平均调用次数, 是当天实际产生调用的玩家数, 在这里取 表示已经使用“每天调用次数”。因此更直接的工程做法,是使用真实日志得到每位玩家每日请求量分布,再计算平均值和高分位,而不是拿理论峰值直接乘整服人数。
还应区分“在线玩家”和“真正触发生成的玩家”。例如只有进入特定任务、触发动态对话或遭遇特殊事件时才调用模型,就应按实际触发率估算,否则会系统性高估成本。
最终的成本看板至少应能回答四个问题:一次请求平均花多少钱、每位活跃玩家每天花多少钱、整服每天花多少钱,以及成本最高的场景是什么。只有把 token、频率、缓存和模型价格都拆出来,质量优化和成本优化才能在同一套数据上做取舍。