
游戏 AI / 系统课时
用固定样本评测 NPC 和任务生成
用固定样本评测 NPC 和任务生成
线上体验不能只靠“看起来还行”判断。固定样本评测的目标,是让不同模型、提示词和版本反复处理同一批 NPC 与任务输入,再用统一指标衡量角色一致性、任务可执行性、重复率和异常率,把主观试玩变成可回归验证的工程流程。
学习目标
- 设计可重复执行并覆盖关键边界的固定测试集
- 计算角色一致性、任务可执行性、重复率和异常率
- 用质量门槛和失败样本判断新版本是否可以上线
固定的是输入与判定规则
固定样本并不是要求模型每次生成完全相同的文本,而是固定输入条件和评分标准。每条样本至少保存场景输入、必须满足的约束和测试标签,例如角色职业、阵营、剧情状态、允许的任务类型以及禁止出现的内容。
测试集既要有常规场景,也要有容易失败的边界场景。例如角色身份互相冲突、任务前置条件不足、连续生成相似任务、上下文缺少关键事实等。只有把这些风险固定下来,新 Prompt 或新模型上线前才有稳定的回归基线。
把批量生成变成统一评测链路
一次完整离线评测可以按“固定输入 → 批量生成 → 结构校验 → 规则评分 → 汇总指标 → 门槛判定”执行。结构校验应放在语义评分之前,因为缺字段、类型错误或越界值本身就是异常输出,不应该继续进入游戏规则判断。
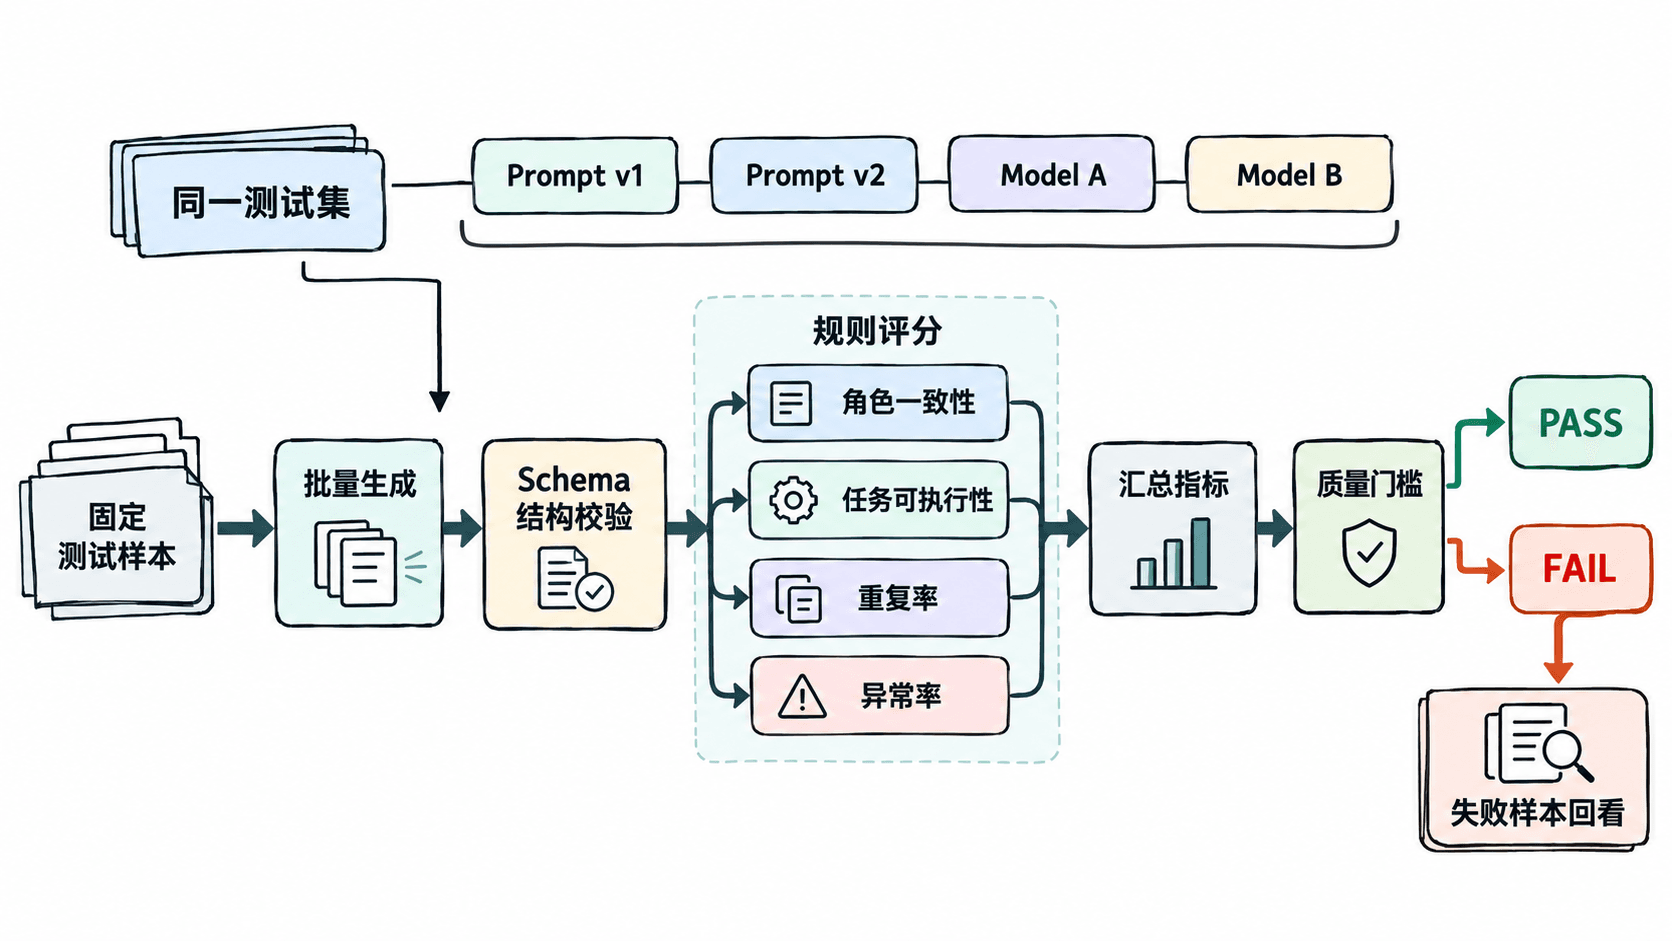
角色一致性用于检查职业、阵营、语气和已知事实是否互相冲突;任务可执行性检查目标、步骤与前置条件是否完整;重复率用于发现模板化生成;异常率则统计无法解析、Schema 不通过、字段越界或被安全规则拒绝的结果。
用脚本计算一组离线指标
下面的 Python 示例不调用模型,只演示如何对已经生成的固定样本结果做确定性评测。真实项目可以把 samples 替换成 JSONL、数据库导出或批量生成任务的结果。
from collections import Counter

samples = [
    {'expected_role': 'merchant', 'output': {'role': 'merchant', 'task': {'goal': 'deliver parcel', 'steps': ['accept', 'deliver']}, 'text': 'Deliver the parcel to the east gate.'}},
    {'expected_role': 'guard', 'output': {'role': 'guard', 'task': {'goal': 'patrol gate', 'steps': ['inspect', 'report']}, 'text': 'Inspect the east gate and report back.'}},
    {'expected_role': 'healer', 'output': {'role': 'mage', 'task': {'goal': 'collect herbs', 'steps': ['collect', 'return']}, 'text': 'Collect three herbs near the river.'}},
    {'expected_role': 'ranger', 'output': {'role': 'ranger', 'task': {'goal': 'patrol gate', 'steps': []}, 'text': 'Inspect the east gate and report back.'}}
]

def task_executable(output):
    task = output.get('task')
    return isinstance(task, dict) and bool(task.get('goal')) and isinstance(task.get('steps'), list) and len(task['steps']) > 0

def abnormal(output):
    # 这里只检查最小结构;生产环境应接入完整 Schema 校验。
    return not isinstance(output, dict) or 'role' not in output or 'text' not in output

total = len(samples)
role_ok = sum(s['output'].get('role') == s['expected_role'] for s in samples)
task_ok = sum(task_executable(s['output']) for s in samples)
abnormal_count = sum(abnormal(s['output']) for s in samples)

# 简化示例按规范化文本判断重复,语义重复可另接相似度模型。
texts = [s['output']['text'].strip().lower() for s in samples]
duplicate_count = sum(count - 1 for count in Counter(texts).values() if count > 1)

metrics = {
    'role_consistency_rate': role_ok / total,
    'task_executable_rate': task_ok / total,
    'repeat_rate': duplicate_count / total,
    'abnormal_rate': abnormal_count / total
}

gate_pass = (
    metrics['role_consistency_rate'] >= 0.95
    and metrics['task_executable_rate'] >= 0.95
    and metrics['repeat_rate'] <= 0.10
    and metrics['abnormal_rate'] <= 0.05
)

for name, value in metrics.items():
    print(f'{name}={value:.2%}')
print('gate=' + ('PASS' if gate_pass else 'FAIL'))
预期输出:
role_consistency_rate=75.00%
task_executable_rate=75.00%
repeat_rate=25.00%
abnormal_rate=0.00%
gate=FAIL
这里的阈值只是示例,项目应根据玩法风险和历史基线自行确定。重要的是各版本使用同一测试集和同一计算口径,否则分数变化没有比较意义。
指标失败后回到具体样本
聚合指标负责回答“版本是否退化”,失败样本负责回答“为什么退化”。评测结果应至少保留样本 ID、模型版本、提示词版本、原始生成结果和失败原因,使开发者能够判断问题来自提示词、上下文拼装、Schema、模型能力还是游戏规则。
固定样本评测适合发布前回归,但不能替代线上监控。离线测试负责稳定复现已知风险,线上指标负责发现真实玩家输入产生的新问题;两者结合后,NPC 与任务生成质量才真正具备可验证、可比较和可持续迭代的基础。