
游戏 AI / 系统课时
用规则约束生成的战斗决策
用规则约束生成的战斗决策
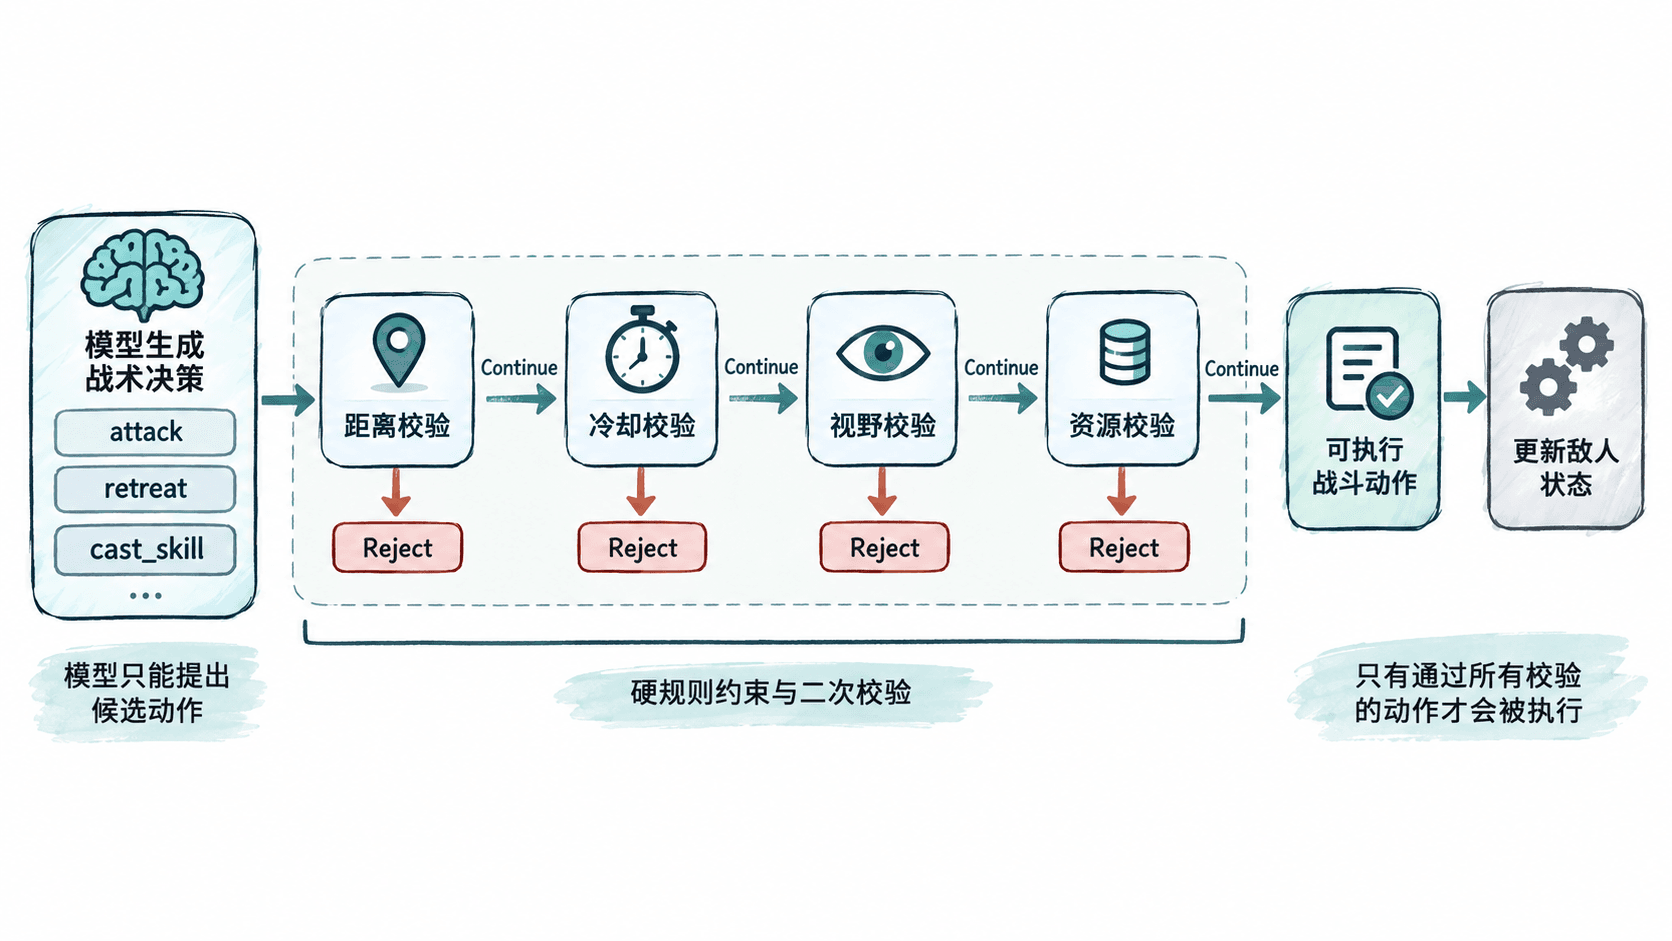
本篇解决敌人“会生成但不能乱行动”的问题:模型先提出战术意图,游戏规则再检查距离、冷却、视野和资源,只有通过校验的结果才能真正改变敌人状态。
学习目标
- 理解模型决策与游戏硬规则的职责边界
- 用统一校验入口拒绝无效战斗决策
- 在执行前完成二次校验,避免状态竞争带来的越界行为
让模型负责选择而不是突破规则
生成式模型适合回答“现在更应该做什么”,例如攻击、后撤、施放技能或寻找掩体;但它不应该决定一个动作是否违反游戏规则。规则应由确定性的游戏代码掌握,这样相同状态下的约束结果可复现,也便于测试。
可以把一次决策拆成“生成 → 校验 → 执行”三段。模型输出动作和必要参数,规则层验证当前战斗状态,最后只有合法动作才写入游戏状态。
把条件写成可测试的规则
规则校验最好集中在一个函数中,而不是散落在模型调用、AI prompt 和战斗执行代码里。这样每个条件都有明确含义:距离约束检查目标是否在技能有效范围内,冷却约束检查技能是否可再次使用,视野约束检查敌人是否仍能看到目标,资源约束检查法力或弹药是否足够。
下面用 Python 做一个最小示例。模型已经返回候选动作,validate_decision 不负责生成,只负责判断这个动作能不能执行。
from dataclasses import dataclass

@dataclass
class EnemyState:
    distance_to_target: float
    skill_cooldown: float
    has_line_of_sight: bool
    mana: int


def validate_decision(decision: dict, state: EnemyState) -> tuple[bool, str]:
    action = decision.get("action")

    if action == "attack":
        if state.distance_to_target > 4.0:
            return False, "target_out_of_range"
        if not state.has_line_of_sight:
            return False, "no_line_of_sight"
        return True, "ok"

    if action == "cast_skill":
        if state.distance_to_target > 8.0:
            return False, "target_out_of_range"
        if state.skill_cooldown > 0:
            return False, "skill_on_cooldown"
        if not state.has_line_of_sight:
            return False, "no_line_of_sight"
        if state.mana < 20:
            return False, "insufficient_mana"
        return True, "ok"

    if action == "retreat":
        return True, "ok"

    return False, "unknown_action"


decision = {"action": "cast_skill"}
state = EnemyState(
    distance_to_target=6.0,
    skill_cooldown=0.0,
    has_line_of_sight=True,
    mana=35,
)

allowed, reason = validate_decision(decision, state)
print(allowed, reason)
预期输出
True ok这个校验入口的价值在于,模型即使给出一个看似合理的技能动作,也无法跳过距离、冷却、视野和资源条件。实际项目中还可以把攻击类型、目标类型、阵营关系等条件放入同一层。
为什么要在执行前再校验一次
生成决策和真正执行之间可能存在时间差。模型返回“cast_skill”时技能可能可用,但等待动画、网络消息或其他 AI 工作完成后,冷却已经开始,目标也可能离开视野。因此生成时通过一次校验,并不等于执行时一定合法。
更稳妥的做法是把校验当成执行闸门:模型结果只保存为候选命令,进入战斗循环时再次读取最新状态并验证。失败就丢弃或转换为安全动作,例如停止施法、重新选择普通攻击或继续追踪目标。
用二次校验保护状态竞争
二次校验尤其适合多人或异步 AI 场景。一个动作可能在生成时满足条件,但在提交执行时已经过期。可以给决策附带生成时间或状态版本号,执行前检查版本仍然匹配;如果不匹配,就重新读取状态并生成新的决策。
因此,生成式 AI 在战斗系统中的职责边界可以概括为:模型决定候选战术,规则决定合法性,游戏循环决定最终状态变化。这种分工既保留了生成模型的灵活性,也让关键战斗逻辑仍然可控、可测试。